A-RSI:何时换题池,先分清答完与答对
固定程序生成新题的收益,能否归因于自适应刷新?
A-RSI用训练日志决定何时替换合成题池,在固定程序模板内继续训练多模态模型。全文的关键价值还在审计:新题池、提前结束回答、答案格式与推理改进不是同一个因素,作者并未证明无限递归自我提升。
图解主要方法
固定程序生成新题的收益,能否归因于自适应刷新?
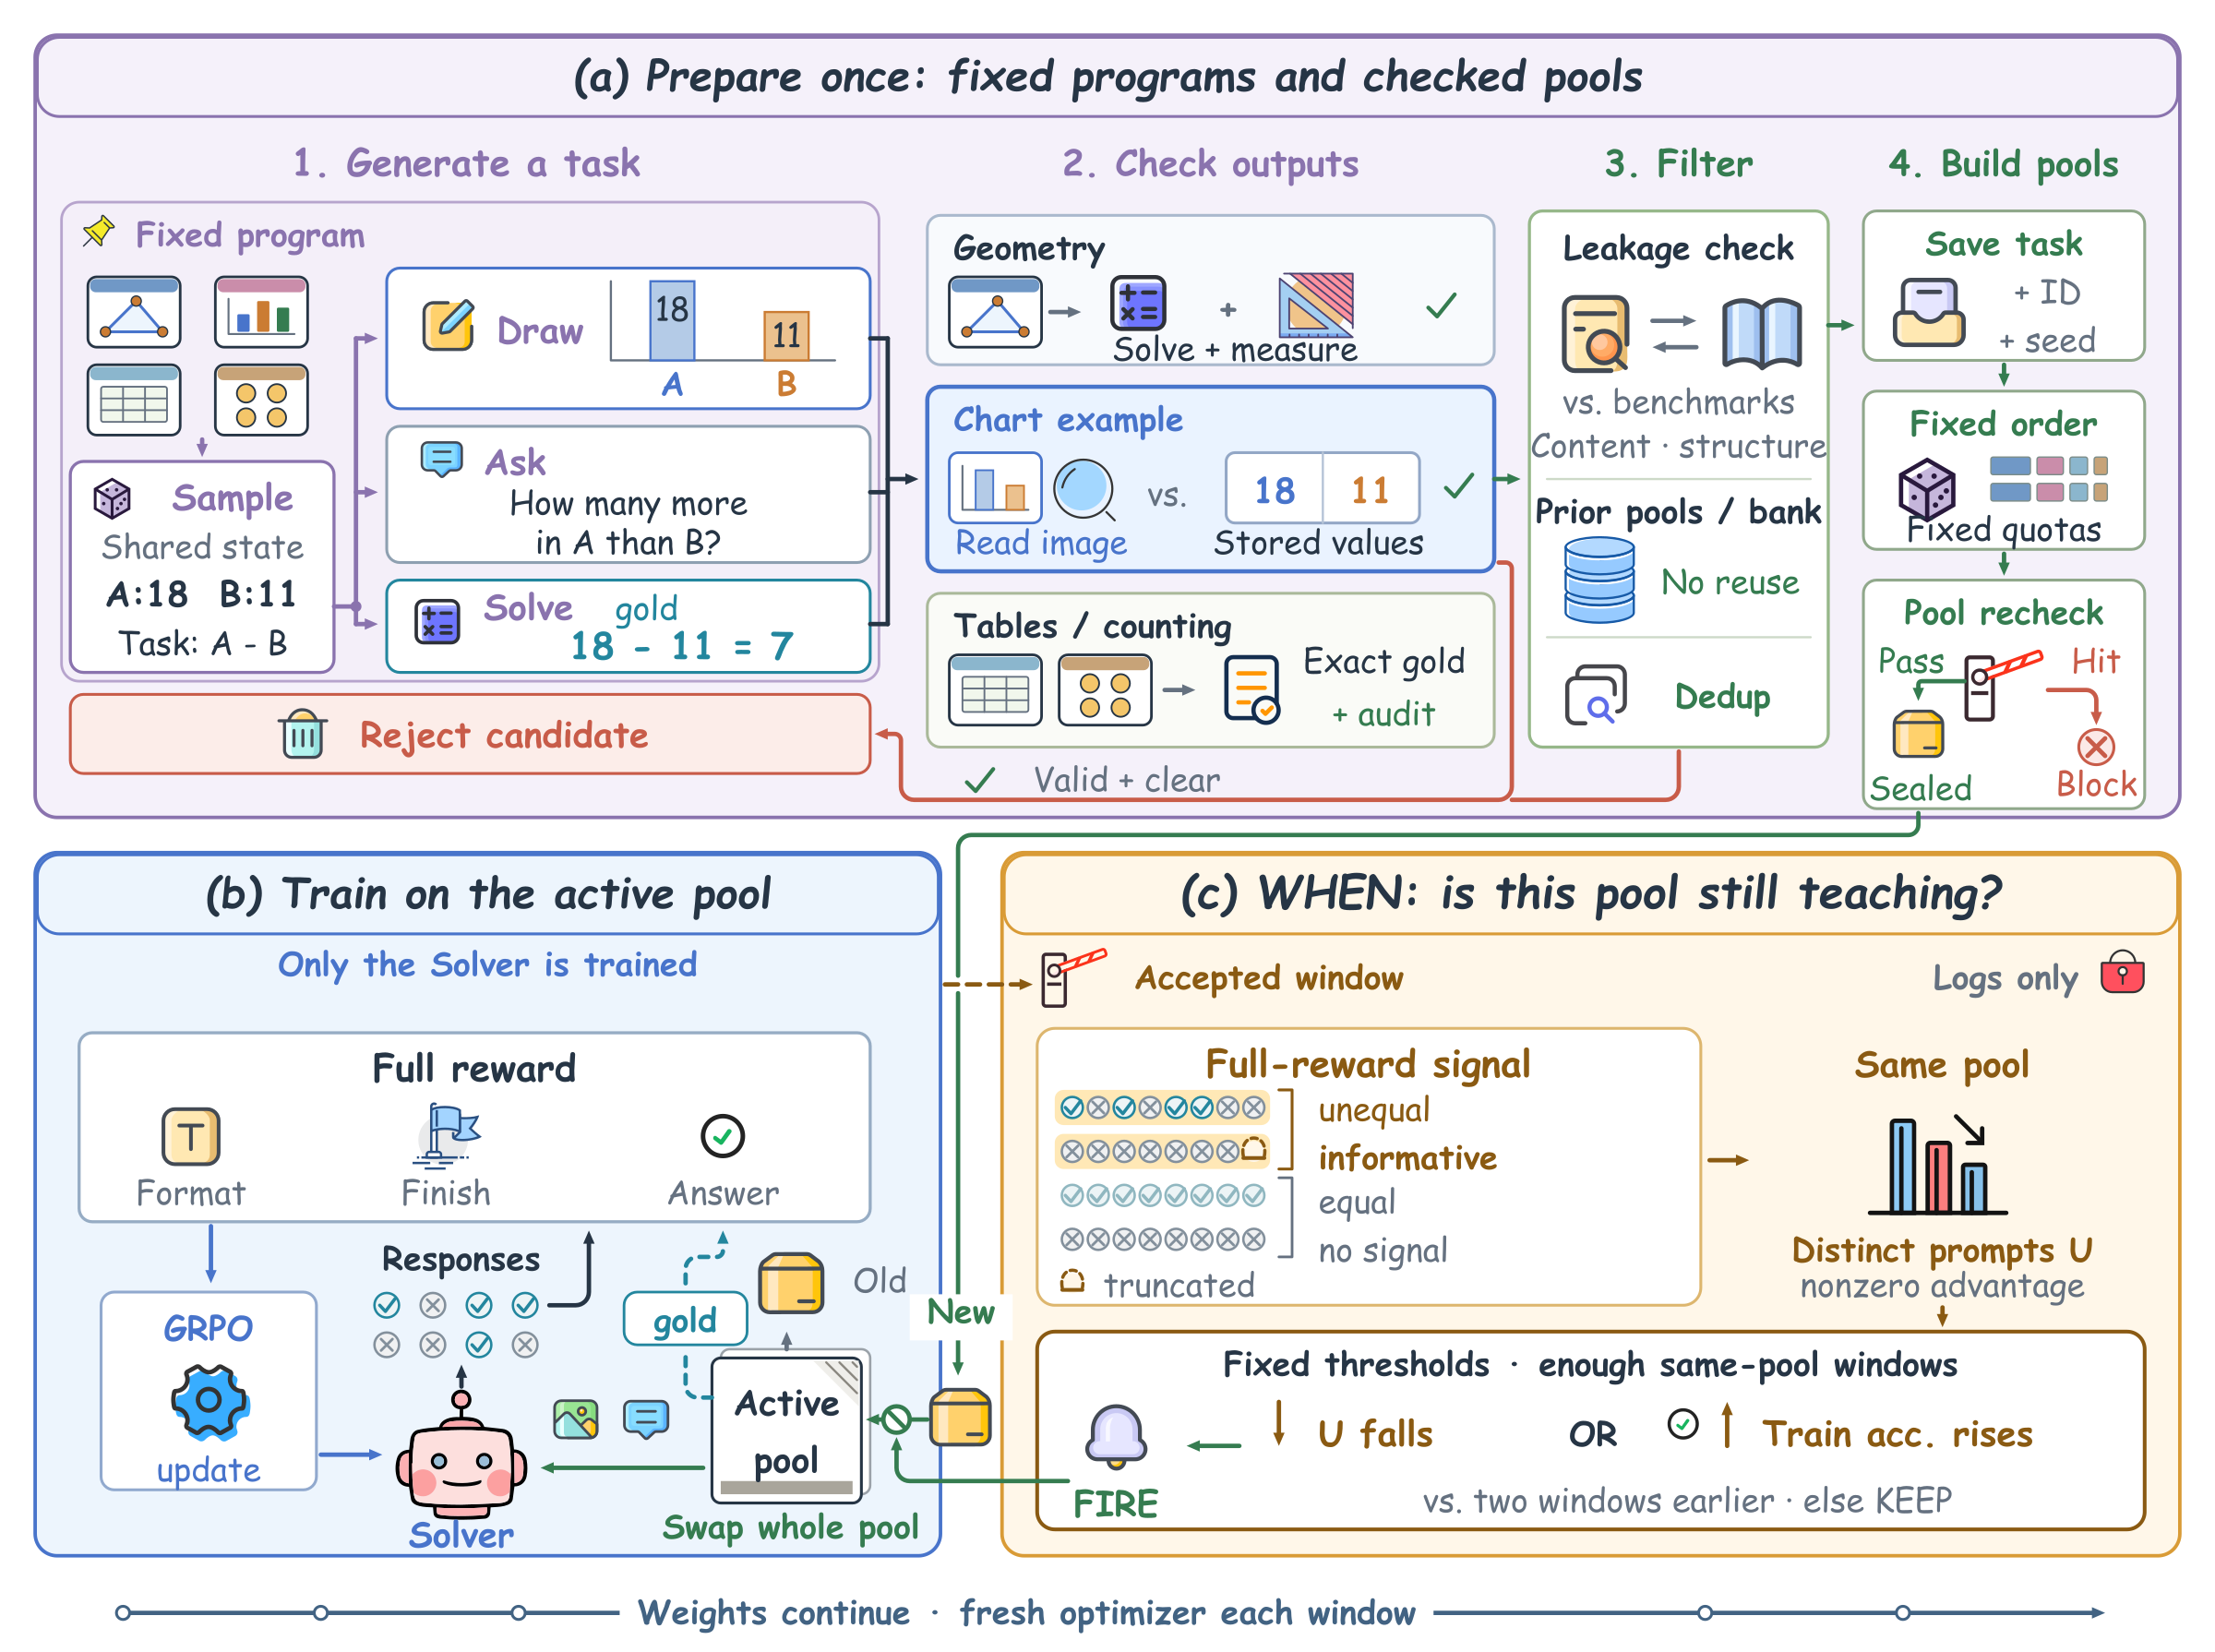
- 1
先固定题目生成器
从几何、图表、表格、计数类型构造可执行模板,同一参数配置生成图片、问题和程序答案;训练前建成16000题候选库,排除诊断留出与不支持的单元后剩14482题。初始500题与两批400题替换池分开,模板库不会随策略递归进化。
- 2
监测有效训练信号
每窗口100次GRPO更新、每题8条回答;至少观察同池三个窗口,再与两个窗口前比较。非零优势的不同问题数下降15%,或日志正确率增加10个百分点,就触发刷新;优势包含正确性、格式和停止奖励,不能简单解释为知识已学完。
- 3
换池但保留参数
从预先准备且互不重叠的池中按固定领域配额替换,保留模型权重。每窗口都会重建优化器与调度器,包括未换池时;因此刷新效应不能解释成只有换池才重置优化器。
- 4
审计得分来源
在相同8192输出预算上重评分,区分两次都正常完成、截断状态改变等分层,并审计程序配置、图片与答案的绑定。1000题检查包含800张整图复现及200张局部图形/文字核验,不是1000张全部逐字节复现。
实验与证据
已阅读正文与方法、实验相关附录,核对实验条件与原图;未独立复现。
来源证据Qwen3-VL-8B从初始化后的57.77到61.05;新增800题不包括初始500题。连续刷新使用3200新题得60.64。后者还使用难度前沿选题,刷新时间与选题策略同时变化。 主实验:11个完整基准,共22042题 ↗
我的解读各臂仅训练一次,约0.40分优势不足以证明自适应时机更好;缺少固定每三窗口随机刷新这一关键对照。
来源证据Qwen固定1000题抽样总增益4.70个百分点,两次都答完的分层贡献为−1.20,其余分层贡献+5.90;MiMo对应+1.30与+1.30。 附录完成状态与跨模型审计 ↗
我的解读这是描述性分解而非因果归因,不能把Qwen全部提升写成更强推理。该抽样与主表总体分母不同。
来源证据模板份额和19个主题词参考过评测元数据;初始池后来发现两题与MathVerse配置同构。主训练未做16k预算评测。 生成数据与评测边界 ↗
我的解读运行时不读测试答案不等于整个设计完全隔离评测;程序答案也不能自动保证图形语义无歧义。
开放情况与使用许可
已读正文及全部审计附录;未确认可下载的完整训练实现和检查点,不把生成器描述视为已开源。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
完整公开负结果与审计边界,有助于识别合成数据刷新真正解决的是训练信号枯竭还是回答截断。
反方 · 哪些结论还不够
单次训练、小优势、未隔离刷新时机;固定模板覆盖窄,奖励还影响格式和停止行为。800新题不是零人工设计,也不是无预训练知识。
综合判断
新题池有实用的正向证据;自适应调度优越性与开放式自我改进仍未被证明。
我会先做的验证
未执行的验证方案:匹配新题数量、训练步数和优化器重置,增加固定三窗口随机换池对照及多个种子;统一16k预算,逐项报告正常完成样本的净纠错与回退。