接受率不等于速度:有损推测解码会把回答拉长吗?
把每轮接受收益、完整回答长度和正确率放到同一张账单
放宽推测解码的验证条件,可能每轮接受更多草稿 token,却令模型思考更久、回答更差。本文检查多个模型组合和宽松规则,说明局部接受长度不足以代表端到端提速,尤其应检查长尾回答与质量约束。
图解主要方法
把每轮接受收益、完整回答长度和正确率放到同一张账单
- 1
建立严格验证的配对基线
以同一模型组合、任务和生成设置下的严格推测解码为参照,再替换为五类宽松规则。主要实验采用 vLLM 0.26.0、单张 H100、batch=1及固定草稿长度;不同规则的放宽参数不直接可比,因此作者使用小规模校准,而不是把相同参数值当作相同扰动。
- 2
让回答膨胀抵消接受收益
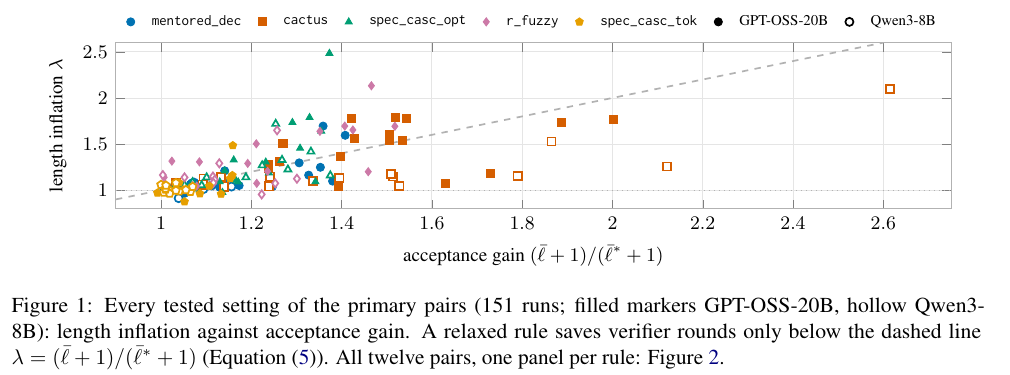
图1横轴是每轮有效输出的相对收益,纵轴是完整回答长度膨胀系数。验证轮数的相对变化近似为两者之比:只有长度增长小于每轮收益才节省轮数。真正延迟还受草稿计算、批处理和系统实现影响,不能只看这个近似。
- 3
加入质量门槛和失败归因
逐例判分并检查思考段、长尾回答和随机性,区分“更快但答错”与“保持质量后更快”。强制结束思考的诊断实验用于观察过长推理是否可被截断救回,但不是已经证明有效的通用部署策略。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据12个模型组合、6类基准共360个条件中,248个回答更长,平均长度膨胀1.54倍,中位数1.08倍;平均每轮收益1.34倍,114个条件反而需要更多验证轮。300个可判分条件中198个下降至少2个百分点。 跨设置统计 ↗
我的解读这是条件级统计,不是独立论文复现;长度长尾使均值与中位数差异明显,单报平均接受率容易掩盖损失。
来源证据主要组合的50个可判分条件中29个保持在2个百分点以内,最佳中位验证轮数比约0.96;在 Qwen 推荐采样设置下,较温和规则可减少约4–7%的轮数。 质量门槛与推荐采样设置 ↗
我的解读结论是需要量化收益边界,而非所有有损推测解码都必然失败;4%的轮数下降也不能直接写成4%的服务延迟下降。
来源证据额外字符中约92%来自推理段,最极端10%的样例贡献约59%的额外长度。强制结束诊断的1132条回答正确数从126升至439,其中335条被救回、22条丢失;选择与分析具有事后性质。 长尾与强制提交附录 ↗
我的解读支持“过长思考可能伤害答案”的诊断,但不等于部署一个截断器就能同时恢复准确率与吞吐。AIME的小样本和部分种子复测限制了精度。
开放情况与使用许可
论文 CC BY 4.0;匿名仓库 README 可读取,列出实现、结果及排除的逐轮追踪数据。继续读取代码和 LICENSE 时返回403,尚未确认许可及文件完整性,不标为已核实开源。
LICENSECC BY 4.0
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
把接受率转换为完整回答成本,并加入质量门槛,直接补上推测解码报告中容易遗漏的评价环节。
反方 · 哪些结论还不够
规则实现并非各原论文全部训练与残差细节的原样复刻;主要单请求 H100 结果不能外推高并发。不同宽松参数靠少量校准,部分后验诊断有选择偏差。
综合判断
评估部署提速时应优先报告正确答案的总延迟与尾部成本,不能将更长接受片段当作充分证据。
我会先做的验证
未执行的验证方案:在同一生产负载、并发数和长度上限下做配对测试,事前锁定准确率门槛与参数;同时记录总 token、验证轮数、P50/P95延迟、能耗和失败率。