激活记忆与参数记忆:互补,也会互相干扰
在人造规则任务中拆开事实存储与规则执行
研究把读历史的激活记忆、用历史更新参数的参数记忆,以及两者结合放在相同合成任务中比较。结合方式在复合规则上受益,但同样的参数更新也可能破坏事实回忆;结论受优化器、任务和更新预算约束。
图解主要方法
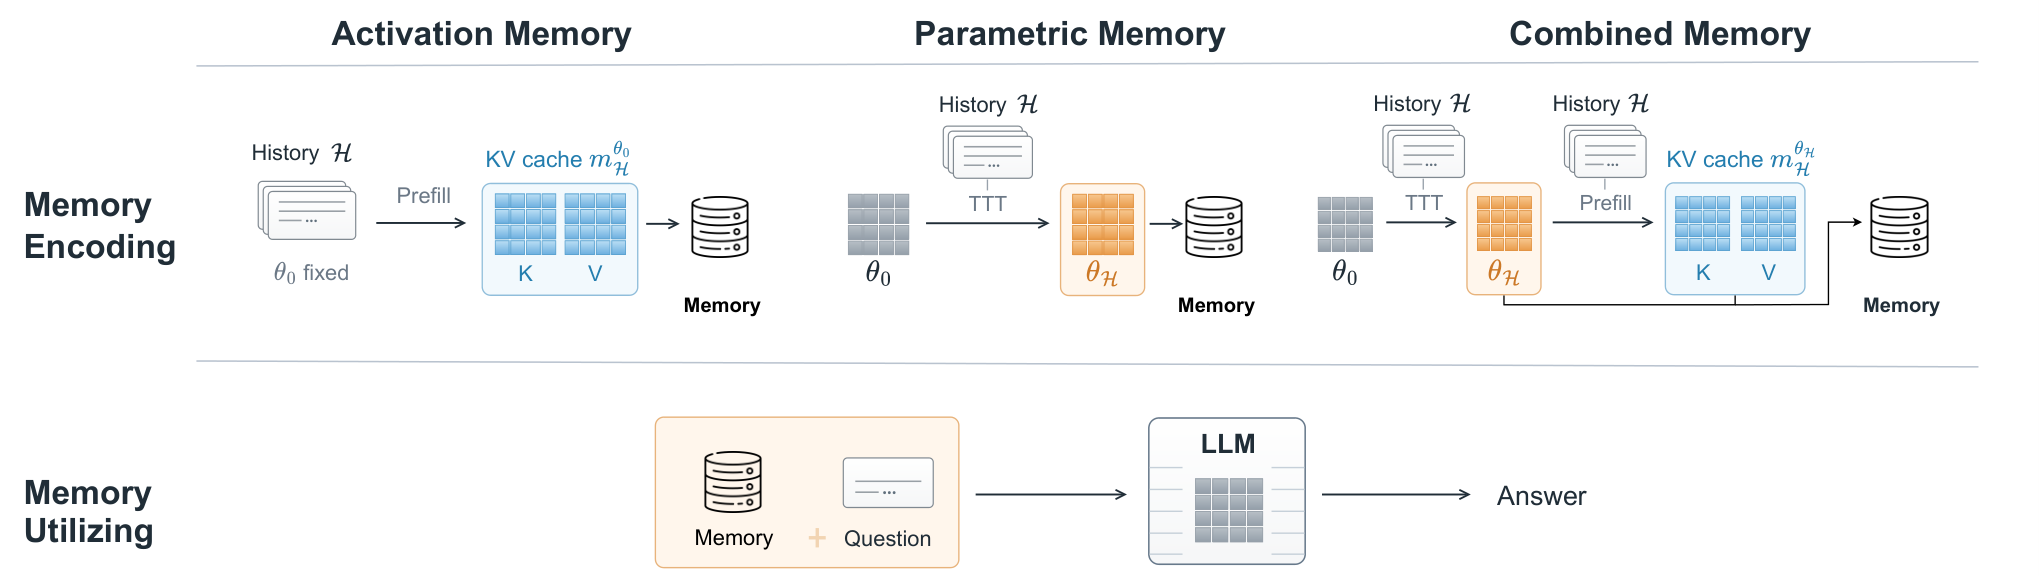
图 2 的三条路径究竟把历史放在哪里?
- 1
激活路径保留历史 token
Act 使用初始参数读取完整历史,让历史信息留在上下文激活中,不做参数更新。新造词与规则由当前历史定义,减少单靠预训练知识答题的可能。
- 2
参数路径写入后移除历史
Para 用历史做全参数 SGD 更新,随后不保留历史的 KV 激活,只让适配后的模型回答。默认 Nesterov 动量 0.9、学习率 0.01、梯度裁剪 1,每个样本重新初始化,比较 2 次与 20 次更新。
- 3
组合路径重新编码历史
Combo 先更新参数,再用更新后的参数重读同一历史。它同时拥有参数变化和上下文,但这不是把 Act 原有 KV 原样接到 Para 上;重编码本身改变了激活分布。
- 4
从单一事实逐步走向复合规则
六类任务涵盖事实、单运算、条件与组合算术,主设置每类 300 个实例、50 条历史示例,在 Qwen3 与 Llama 基础模型上测试。事实检索和执行条件规则的难点不同,不能只汇总为一个记忆分数。
- 5
神经元分析提供相关证据
作者用配对任务的响应差异选择神经元,在六个层各取前 20 个,并按各设置的标准差归一化。选择和测量使用同一批任务,且没有针对这些神经元的因果干预;活动差异说明相关机制,尚不证明唯一分工。
实验与证据
以下为作者报告;已阅读 v1 全文及可用附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【Qwen3-1.7B,复合条件算术】Act 0.257,Para 为 0.413/0.390,Combo 为 0.637/0.877,分别对应 2/20 次更新。 主实验表 ↗
我的解读我的解读:同任务、不同写入方式的比较支持互补,但不意味着任意参数更新都有效。
来源证据【事实任务】Act 在四个模型上均为 1.0;参数路径大多接近零。Qwen3-4B 的 Combo 从 2 次更新的 0.953 降到 20 次的 0.570。 主实验表 ↗
我的解读我的解读:多训练可能干扰原本能从上下文直接提取的信息,不能以复合任务收益覆盖事实损失。
来源证据【历史扩展】2000 示例时,组合约 83%,激活约 37%,参数约 12%。 历史长度实验 ↗
我的解读我的解读:说明该合成设置下组合更稳,但三条路径的训练和上下文成本并不相同;不构成无限记忆容量证明。
开放情况与使用许可
全文及附录未给出本研究可核实的独立代码或数据仓库;基础模型引用不等于实验实现开放。
LICENSE实现与数据许可未确认;论文许可见图注。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
将历史的存放位置与读取路径明确分开,使“记住事实”和“学会使用规则”可以独立诊断。
反方 · 哪些结论还不够
合成任务、单一优化配方及同样本神经元选择限制外推;实验没有证明真实对话必须同时使用两类记忆。
综合判断
可作为测试时适配的诊断基准:把规则收益与事实损失并列,而不是默认更新参数会增强全部记忆。
我会先做的验证
未执行的验证方案:加入自然语言规则、无关历史和冲突事实,在相同总计算预算下比较 SGD、低秩更新与检索上下文;在独立样本上复验神经元消融与遗忘曲线。