ActiveScale
机器人先换个角度看,再决定怎样抓
把历史画面与相机位姿监督加入 VLA,联合预测观察和操作动作。重点是遮挡下如何主动获取信息,而非只提高单帧识别精度。
图解主要方法
目标藏在包内时,策略能否把“再看一眼”作为动作的一部分?
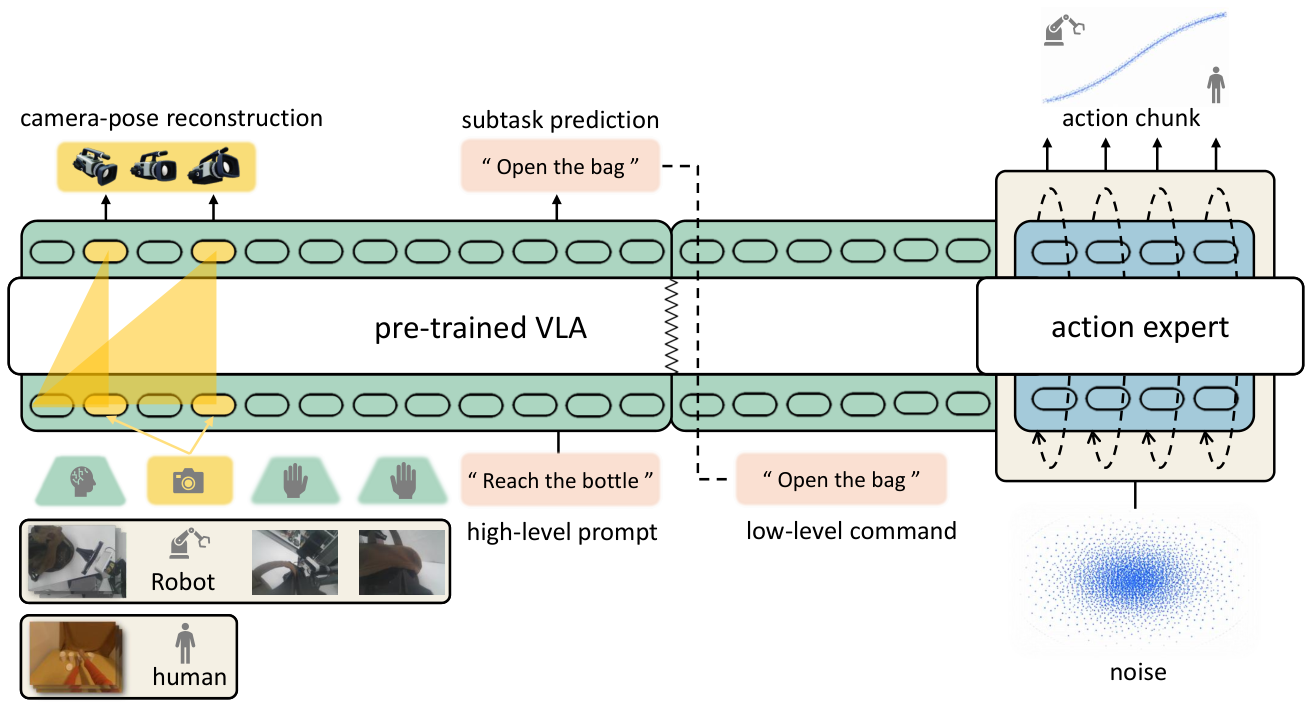
- 1
把先前观察留在输入中
图左的视觉输入与相机 token 一起进入预训练 VLA;历史帧提供此前看到但当前被遮挡的信息。
- 2
训练时约束相机表示
黄色 token 经辅助头预测位置、朝向与视场角。该头在动作推理时移除,监督作用留在内部表示中。
- 3
把语义目标变成联合动作
图中子任务连接动作专家;后者通过 flow matching 生成动作块,同时协调操作和相机运动。
实验与证据
作者在五类任务上各做 20 次实机测试,平均严格成功率由基线 30% 到 70%。这是作者评估,本站未复现。
开放情况与使用许可
已核查训练/推理源码及 Hugging Face 实际 safetensors 文件;未下载大体积权重或执行机器人实验。
LICENSE代码 Apache-2.0;派生权重受 Gemma 条款约束
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
我的判断:把观察动作纳入策略,能让错误从“看不到仍然猜”转为“先收集证据”。这比让语言输出显得更有把握更贴近真实控制问题。
相机位姿监督提供了有物理含义的训练信号。代码和任务权重已公开,使“究竟是记忆还是几何在起作用”有机会被独立检验。
反方 · 哪些结论还不够
主实验的额外训练预算和架构变化耦合。公平比较还应给基线相同数据、训练步数与相机执行能力,否则难以回答哪个改动最值钱。
每类 20 次意味着单次成败会改变该类成功率 5 个百分点。新的遮挡物、相机标定误差或更慢执行速度是否破坏收益,当前结果不足以保证。
综合判断
值得作为主动感知的可复现研究起点;尚不足以证明机器人形成了可迁移到任意环境的持久三维理解。
我会先做的验证
建议实验,尚未执行:固定数据与训练预算,对比单帧、历史帧、历史加位姿三组;另加打乱位姿监督的控制组。在未见容器和相机轨迹上报告成功率置信区间、观察次数、总耗时和碰撞率。