ARC:只在将要失败时修正冻结机器人策略
少量人工干预如何分别回答何时、沿哪些方向、修正多少?
把机器人残差控制拆为干预时机门、低维修正子空间和自主强化学习。三个真机任务各12次测试平均成功率33.3%→75%;人工干预主要教门与方向,不是直接把所有人工动作塞进RL回放。
图解主要方法
少量人工干预如何分别回答何时、沿哪些方向、修正多少?
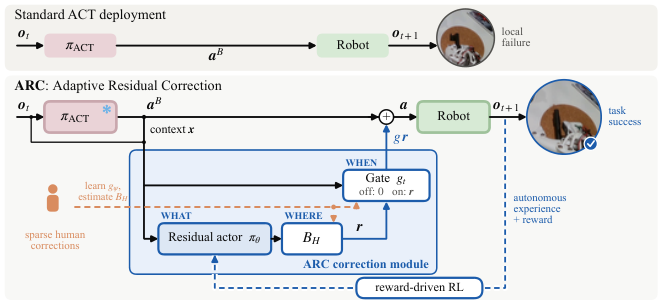
- 1
图1底座:冻结已有ACT策略
基础ACT控制Miroki机械臂七关节及相关末端动作,每任务约55条示教。部署时基础动作加一个受门控制的残差;门关闭时严格回到基础策略,避免始终修正破坏原本已会的动作。
- 2
WHEN:学习干预之前的状态
每任务8–10条稀疏人工介入轨迹,把介入前五帧标为危险信号,排除已经处于人工控制的状态。按完整轨迹交叉验证阈值并加滞回,防止频繁开关;门学习的是何时需要帮助,而不是看见纠正后姿态才触发。
- 3
WHERE:从人工修正提取低维方向
对残差的未中心化二阶矩作特征分解,得到固定线性基与尺度,三个任务分别用3/2/2维保留97.3%/96.0%/97.7%的能量。它保留常用纠正方向,同时也限制了从未示范过的救援动作。
- 4
WHAT:自主回放学习残差大小
在固定门和基上,用两轮自主采样及TD3多步奖励训练,加入小残差正则;人工轨迹不作为RL回放。探索方向按整段固定,回放存真实经过限幅执行的残差,防止训练动作与机器人动作不一致。
实验与证据
已阅读全文正文、方法和实机实验,核对实验条件与原图;未独立复现。
来源证据每方法每任务12次:托盘7/12→12/12,记号笔3/12→7/12,杯子2/12→8/12;合计12/36→27/36,即33.3%→75%。 三个真机任务 ↗
我的解读我的解读:小样本内改善大,但不是跨物体的大规模可靠性验证。托盘已满分也不代表新位置或新接触条件满分。
来源证据介入前状态训练的门在专门测试10/10触发,人工控制状态训练门0/10;记号笔AUROC .853但AUPRC .137,正例率 .037,检出17/36。七维监督残差基线为3/5/3次成功。 门与残差对照 ↗
我的解读我的解读:10/10是检测,不是任务成功。完整方法与监督基线同时改变学习机制和子空间,不能把全部提升都单独归因于RL。
开放情况与使用许可
论文公开;本次未核实对应完整代码、权重及明确实现许可,不以论文公开代替开源状态。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
我的判断:时机、方向、幅度分解让少量人类知识进入最需要的环节,并保留冻结策略正常工作区域,适合局部接触失败修复。
反方 · 哪些结论还不够
低维空间和门依赖同一操作者的干预风格,可能漏掉新型故障;正例稀少时AUROC容易显得好看,AUPRC与实际召回更重要。12次试验的置信区间很宽。
综合判断
这是有实机证据的局部修正方案,尚不等于无需人类的通用在线自我改进。
我会先做的验证
未执行的验证方案:用完全相同的低维基比较监督残差与TD3,额外加入无门和随机门;新操作者、新起点各100次,报告成功率、门召回、错误介入次数和最大接触力,验证收益来自哪里。