优势引导 VLA 后训练:先估计,再校准,再加权
固定离线数据,拆解真机收益来自哪里
论文把机器人后训练拆成优势估计、不同阶段间的分数校准与训练样本加权,先用人工接管和进度对照诊断,再在四项真机任务中验证。连续加权优于直接丢弃低分样本,但结论基于固定离线数据与有限真机次数。
图解主要方法
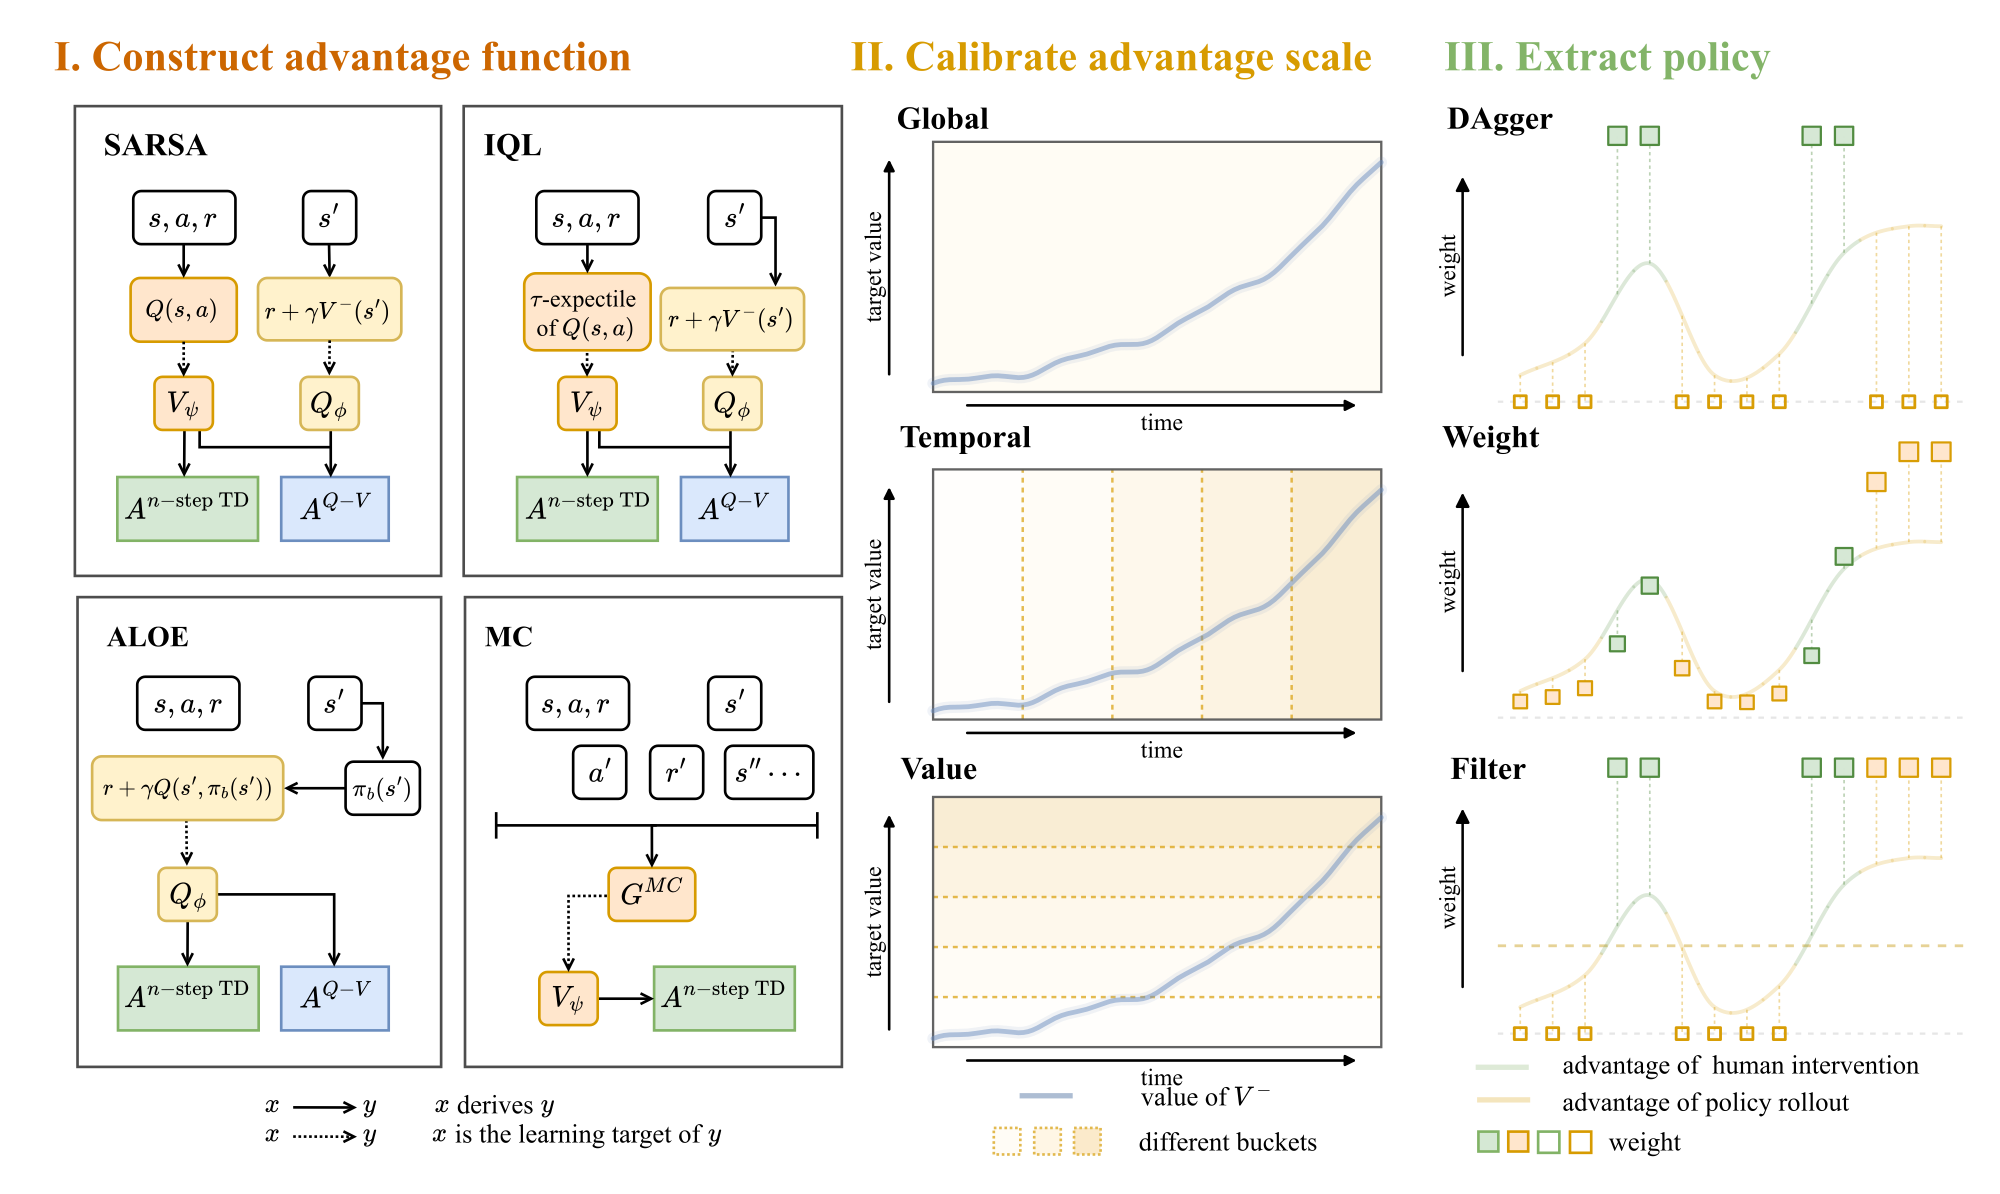
图 2 的三段比较怎样避免把不同改动混成一个收益?
- 1
固定数据后比较优势构造
每项任务约 40 小时专家数据,另有 100 次自主轨迹与 100 次接管轨迹。π0.5 策略每次输出 30 个动作、30 Hz 执行。比较 IQL、SARSA 等评价器,以及 Q−V 与十个动作块的 TD 差;奖励主要来自末端成功,γ=0.96。
- 2
用排序诊断代替假定真优势可知
接管配对约 200 组,检查人接管片段是否比自主片段得分更高;进度配对约 400 组,用视觉相似和人工子任务定义选择可比片段。这些是代理顺序标签,人接管和进度划分都可能带有状态选择偏差。
- 3
按价值阶段校准分数
将演示与自主来源分开统计,再按价值分成八组做标准化,与全局标准化和相对时间分组比较。样本不足的小组回退、标准差设下限,统计量固定;目的是避免某个容易阶段只因分数尺度大而支配训练。
- 4
保留低分样本,但降低权重
固定 4000 次策略更新、batch 2048,用裁剪后的标准分指数加权;对比仅训练人工数据的 DAgger 及每批只保留前 50% 的硬过滤。指数权重仍给低分样本非零贡献,因此比过滤更能保留状态覆盖。
- 5
真机结果与离线诊断对应
在四个任务中逐段更换估计或校准方案,再看真机进度和成功率是否同向变化。这是有控制的配方比较,不是任意任务中最佳估计器、归一化和优化器的全组合证明。
实验与证据
以下为作者报告;已阅读 v1 全文及可用附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【离线排序】IQL 的多步 TD 优势平均接管一致性约 0.718、进度一致性 0.897。 阶段 I ↗
我的解读我的解读:代理排序有诊断价值,但不同优势构造估计的量并不完全相同,不能只把一个排序指标叫作真实价值误差。
来源证据【校准】子任务间均值差异占比 η²:原始 0.092,全局 0.080,时间 0.044,价值 0.026。 阶段 II ↗
我的解读我的解读:降低阶段偏置不等于证明绝对优势已校准;个别任务也不是价值分组全面获胜。
来源证据【四任务真机,每条件每任务 20 次】SFT、DAgger、加权、过滤的平均成功率为 0.11、0.45、0.74、0.50;进度 0.44、0.71、0.86、0.75。 阶段 III ↗
我的解读我的解读:加权相对 SFT 是 63 个百分点,不是 63% 相对提升。样本量有限,主表缺少充分区间,仍需多次训练与更多真机种子。
开放情况与使用许可
已打开作者项目页,内容为方法、结果和演示;未发现本研究可核实的训练实现下载。页面模板仓库和 LeRobot 上游均不算本研究代码。
LICENSE代码与数据许可尚未确认。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
把估计、尺度和数据使用分开检查,能定位后训练失败源,而不只堆叠最终配方。
反方 · 哪些结论还不够
人工接管顺序是代理真值,四任务小样本与固定数据限制泛化;过滤还改变有效样本覆盖。
综合判断
适合已有专家与接管数据的 VLA 团队作诊断流程,优先确认优势排序有效,再决定加权方式。
我会先做的验证
未执行的验证方案:固定数据和训练预算,对估计、分组、加权做配对随机种子实验;保留独立人工盲评和真机置信区间,并测试任务阶段分布变化。