FEB-30:问答分数为何不等于记忆质量
记忆库中事实是否正确,应怎样与最后一次回答是否正确分开检查?
用30条随时间演化的事实轨迹逐状态检查记忆库,再独立评估最终问答。将检索、更新分类、事实合成、时序和来源归属拆开,展示两种评分可能相互偏离;内部指标也有裁判与阈值依赖。
图解主要方法
记忆库中事实是否正确,应怎样与最后一次回答是否正确分开检查?
- 1
构造逐状态事实而非只给最终答案
30条轨迹覆盖6类失效、3档难度,每档10条;147篇生成文档含127篇状态文档和20篇噪声。每状态维护累计真值claims,同时区分新文档docClaims,避免把重复旧事实误算新更新。多模型生成及一致裁判后仍人工修正11%内容、移除28%脚手架。
- 2
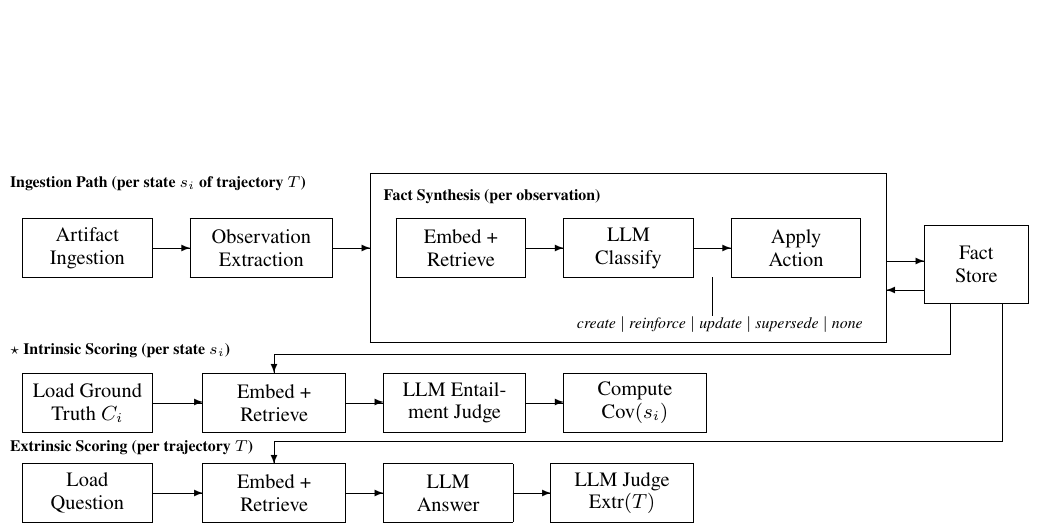
图1写入链拆成可检查决策
文档提取观察,结合嵌入和检索找到已有事实,再分类为create、reinforce、update、supersede或none,最后改变事实库。参考实现采用1024维Titan嵌入及BM25/kNN混合。时间保护会把旧观察降成reinforce,既防倒退,也可能漏掉合法的历史补充。
- 3
内部覆盖与外部问答分别计分
图1中间分支在每个状态加载真值,通过检索阈值与LLM蕴含裁判检查事实覆盖;底部分支在轨迹末尾检索、生成回答再裁判。内部评分不是直接读取数据库即可获得的客观全知真值,它也可能受检索和裁判影响。
- 4
用诊断指标定位更新错误
比较每条轨迹两分数绝对差、超过15个百分点的比例,再检查更新召回、错误更新、动作分类及来源归属。11次重复作用在同一组30轨迹上,不是330种独立情境;扩展的4种配置也不等于4个完全不同记忆架构。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据内部平均60.6±1.6%,外部48.8±2.9%,绝对差均值0.168±0.025,43.6%轨迹差距超过15个百分点;多作者归属内部41.5%。 表3、附录:11次运行 ↗
我的解读我的解读:两个分数确实揭示不同环节,但这些差值只来自该参考系统和窄域轨迹,不能外推所有记忆产品。
来源证据动作分类准确20.1±2.7%,更新召回73.6%,错误更新22.2%;附录提示强烈偏向将匹配观察作为update。 表4及分类提示 ↗
我的解读我的解读:系统提示可能贡献过度更新,应与模型能力不足分开诊断;改善提示、检索或时间规则可能改变排名。
来源证据C1原本用于“模型补偿记忆错误”的设计,实际内部82.2%、外部54.5%方向相反;正文部分难度数值与表格不同。表4的miss rate被称为coverage补集,但总体口径无法直接与60.6%覆盖率对应。 正文与表格的内部差异 ↗
我的解读我的解读:采用表格可核对数值,不替作者消除矛盾。相关系数及其平方也不能证明两评测中多少信息彼此独立。
开放情况与使用许可
论文给出amazon-science/feb-30-benchmark链接,但2026-10-19网页/API复查均未获得公开仓库(API 404);未核实可下载基准或实现。仅确认论文全文及附录公开,不能按承诺认定开源。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
我的判断:逐状态核验能把“没记住”和“没检索出来/没答对”分开,尤其适合事实会更新的长期助手。应把方法当诊断工具,而不是新增一个替代所有指标的总分。
反方 · 哪些结论还不够
30条多为合成的业务事实轨迹,生成、筛选和评估都使用LLM;内部覆盖依赖阈值。作者正文与表格存在数值/定义差异,参考系统的抽取模型身份也未充分明确,限制独立复核。
综合判断
值得复用双通道评估设计;在开放数据和实现可确认前,暂不依据其绝对分数选择生产记忆架构。
我会先做的验证
未执行的验证方案:构造独立人工真值的真实更新轨迹,冻结同一写入日志,分别改变检索、裁判、更新提示和时序规则;报告每状态漏记、误改及来源错误,并按轨迹而非重复运行做置信区间。