AgenticRoboRL:训练机器人的工具调用规划器
保持底层控制器冻结,用真实工具上下文和终局反馈训练上层模型。
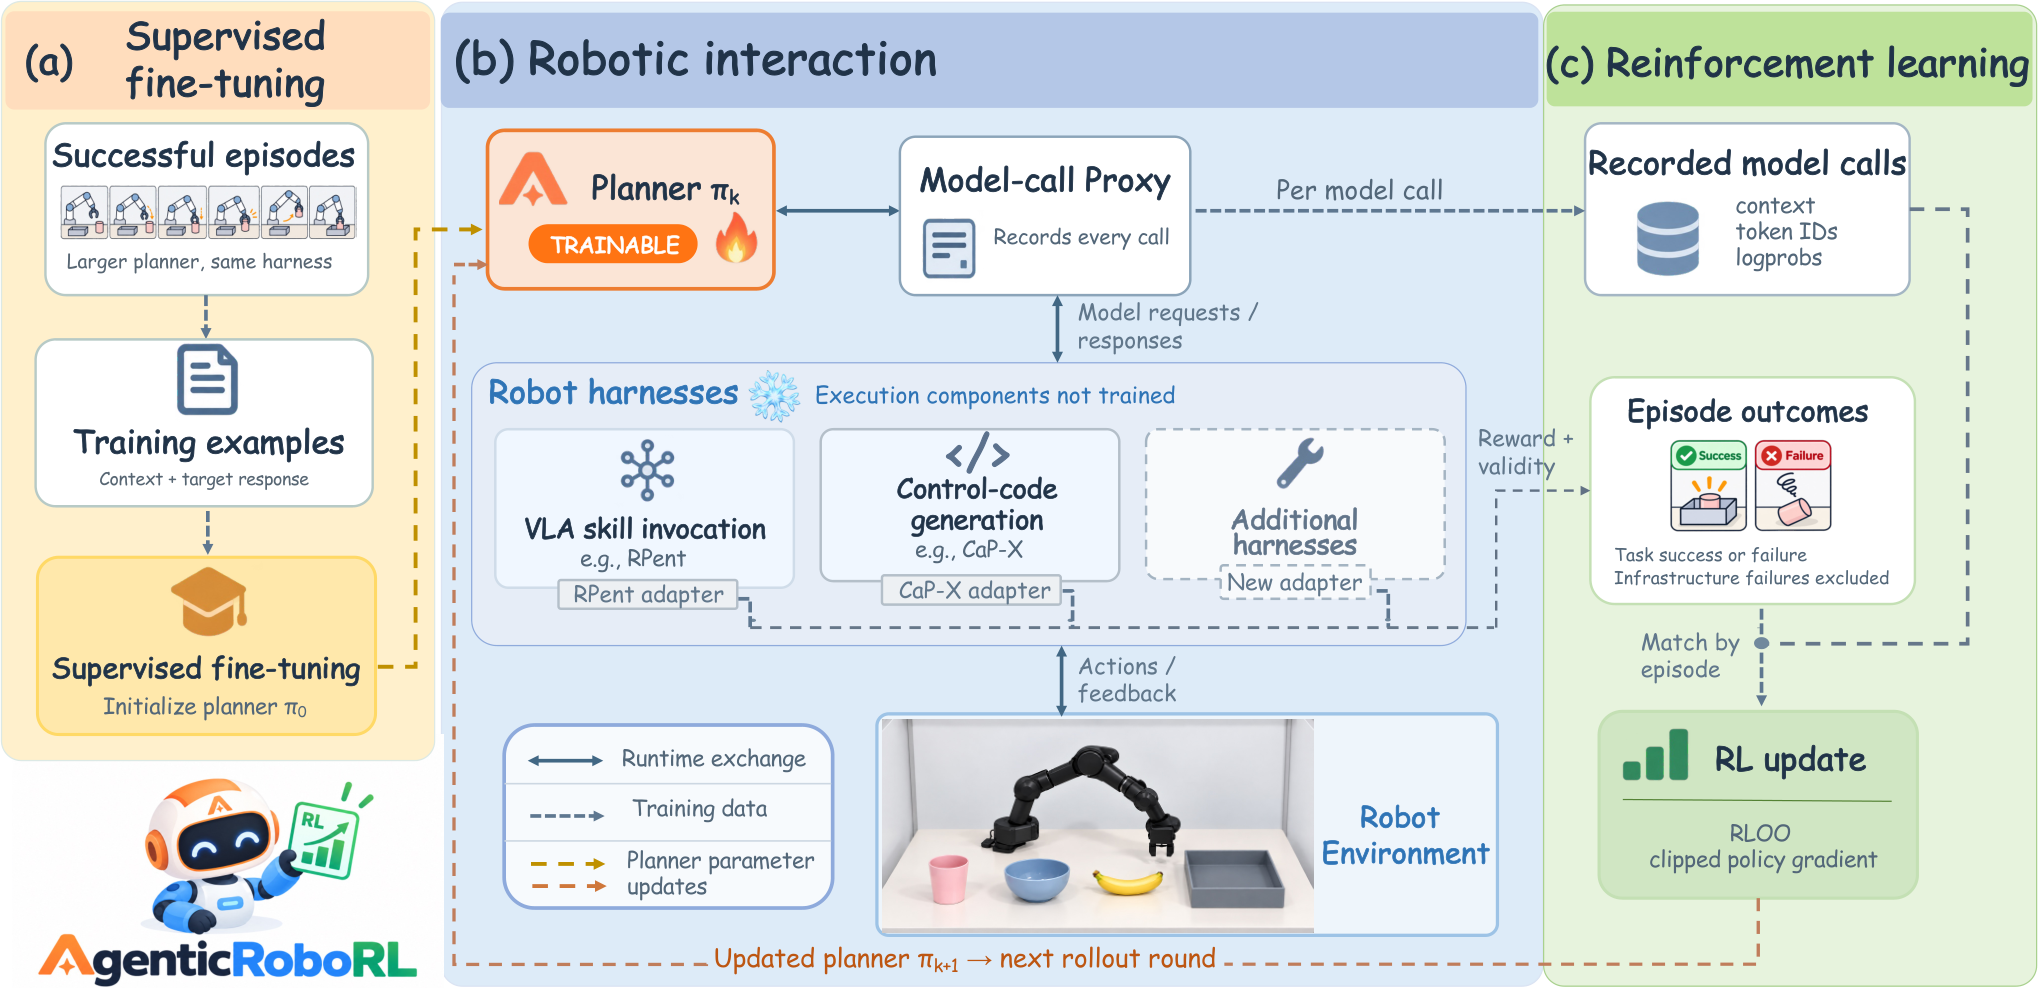
AgenticRoboRL 将代码智能体的SFT与多轮RL用于机器人上层规划:模型可以调用冻结VLA技能,也可以生成控制代码。代理记录实际请求和概率,避免训练上下文与执行时不一致。在仿真中RL带来进一步提升,但大量增益已来自教师轨迹SFT,不能全部记在强化学习名下。
图解主要方法
保持底层控制器冻结,用真实工具上下文和终局反馈训练上层模型。
- 1
1 · 重建学生真正能看到的SFT上下文
图2左侧使用教师成功轨迹;教师可使用记忆工具,学生部署不带它,因此要去掉记忆调用并改写引用记忆的文本,工具参数仍保留。训练的是学生真实可见输入,不是把带特权记忆的完整教师提示直接复制。
- 2
2 · 在现有机器人执行框架内采样
图2中部模型调用proxy记录prompt token IDs、输出token与logprob。RPent调用冻结VLA,CaP-X生成机器人API代码;适配器提供任务、初始化、尝试、reward与valid信息。只有规划模型更新,控制器没有同步学新动作。
- 3
3 · 将有效失败与基础设施故障分开
环境未成功和代码错误可作为有效零奖励,基础设施故障排除。token上下文不匹配的调用不进入优化。这样可避免把网络或日志问题训练成“动作错误”,也是多轮RL可复现的前提。
- 4
4 · 用组相对终局奖励更新
每组6次尝试,以其他样本均值构造优势,终局成功反馈到规划token,使用裁剪策略更新;无额外中间奖励、长度奖励或KL/熵项。最多选择16个回合训练不是限制整个执行只有16回合。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据800个测试episode:基础18.1%、SFT65.1%、RL71.0%;相对SFT增加121次成功、回退74次。LIBERO-Plus 10030项上19.2→66.7→72.2。 RPent · LIBERO-PRO与Plus ↗
我的解读RL提供增量而非全部52.9个百分点;扰动泛化有证据,但测试仍围绕同一基础任务族。
来源证据60任务600测试,从2.7%到SFT18.7%、RL28.5%;该框架可用特权状态,训练使用另一个检查点,并选择35个中等成功率任务进RL池。 CaP-X · 特权状态控制 ↗
我的解读不同框架不能直接合成一个通用成功率;Object类提高而Spatial类仍弱,空间位置项甚至10%到6%。
来源证据遮蔽记忆引用55.2%,重写覆盖更多训练回合时60.2%至64.6%;教师SFT轨迹未发布,仓库提供SFT及RL检查点与训练代码。 上下文重写消融与发布范围 ↗
我的解读重写和数据量、训练步数同时变化,不能将全部差值归因于单一文本操作;从头复现仍缺教师轨迹。
开放情况与使用许可
官方仓库重定向至 xinxinliu-ai/AgenticRoboRL,已核实际rl与harness实现及Apache-2.0 LICENSE。HF模型卡公开sft与rl-v006两个完整检查点、标注Apache-2.0;README明确教师SFT轨迹未发布,不能称全部数据开放。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
把模型调用记录、任务结果与控制框架解耦,是把智能体RL接进机器人系统的实用路径,尤其适合固定技能库上层规划。
反方 · 哪些结论还不够
主要为仿真,无真实硬件成功率;两框架的信息权限不同。训练/验证/测试按初始化切分,不能等同新任务泛化;教师轨迹未开放,执行回合与时间预算也较大。
综合判断
适合作为上层规划后训练基线,不应宣称底层机器人控制能力已端到端提升。
我会先做的验证
未执行的验证方案:固定冻结控制器与工具预算,在未见任务组合上比较基础、SFT、RL;分别报告新增成功与退步、非法调用、超时,以及失去特权状态后的性能。