Agentic-TTT:让策略决定何时训练、选哪种适配、何时复用LoRA
精选可获益任务上的效用近翻倍,离开放部署的自主持续学习仍有距离
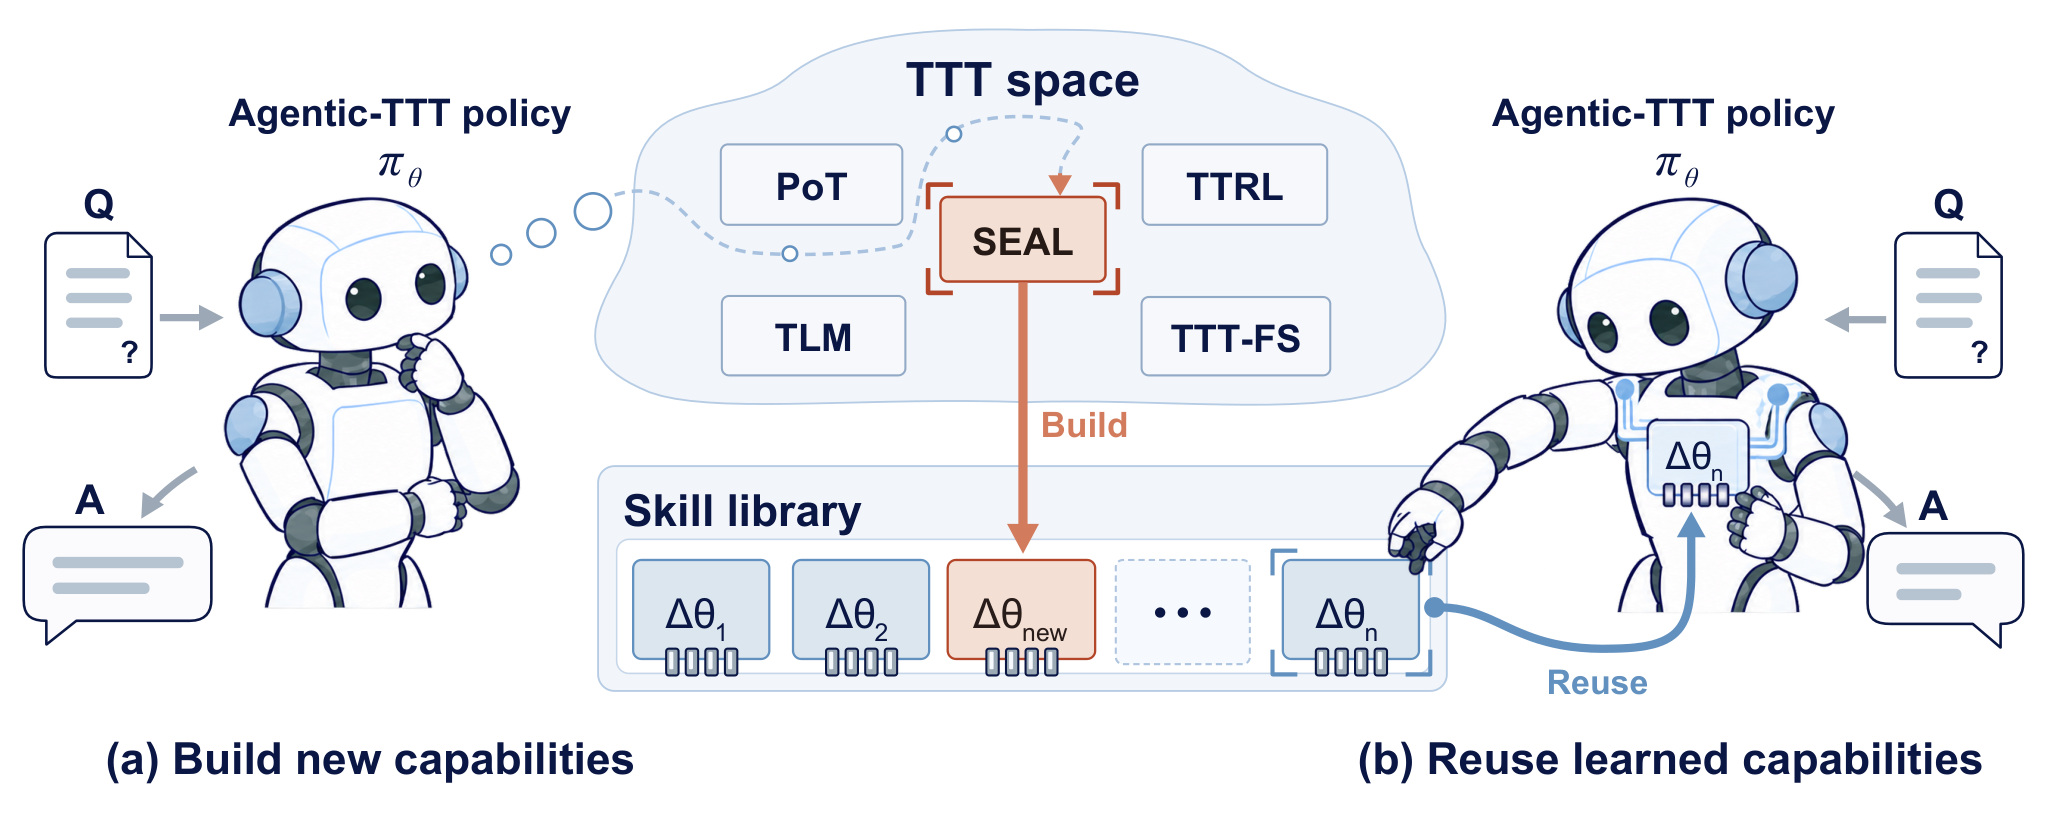
Agentic-TTT把五种测试时训练算法包装成工具,用独立策略LoRA决定存储材料、适配、加载或直接回答。每个技能是冻结基座上的独立LoRA,可随查询流复用。Qwen2.5-7B在176题精选流上效用0.256到0.510,但约65%的数据特意筛为适配有益,不能将翻倍解释成一般真实流量的预期收益。
图解主要方法
测试时训练不是总有益,模型能否学会何时花计算改参数、何时复用或直接回答?
- 1
把适配材料和技能变成跨题状态
维护材料池与每池至多一个技能LoRA,支持累计新样本及最多8条重放后增量更新;语义嵌入+BM25选top8池,名称和前提由harness校验。
- 2
策略选择四类动作
Assign存材料、Adapt调用PoT/TTT-FS/TTRL/SEAL/TLM、Load加载技能、Generate终止。每题最多六轮和一次成功适配,TTRL至少16新样本,耗尽轮数退回基座直接回答。
- 3
用提示引导收集再蒸馏
训练时提示下一金动作、保留执行正确轨迹;SFT前移除提示,动作token权重4、理由1。2072轮来自177轨迹,策略LoRA rank16,基座冻结。
- 4
以当前题实际收益做RL
同一状态采8完整轨迹,奖励为相对基座效用减适配成本和有上限的非法动作罚项;均值中心化不除标准差。采样后回滚,训练流由金动作推进,是重要限制。
- 5
将技能与控制器分离推理
回答阶段禁用策略LoRA,只载指定技能或裸基座,输入仅原题;文档任务先独立摄入、回答阶段无原文,适配成本仍计入。
实验与证据
全文与附录A–E、工具前提、数据筛选、全部提示模板读完;图1视觉核验,首发许可核对;论文中的操作提示仅作为研究对象阅读。
来源证据11基准8领域,229训练45开发176测试;RL187训练输入,测试另19个无评分文档事件。 第3节;附录B ↗
我的解读176是效用分母,文档摄入不评分但付计算成本;不能把195事件当195独立测试题。
来源证据Qwen7B直接0.256,提示0.271±.003,语义路由0.347±.020,SFT0.375±.010,SFT+RL0.510±.012。 表1 ↗
我的解读近翻倍是此精选流的二元题目平均分;±是三次训练的样本标准差,不是部署置信区间。
来源证据三次流中141个原错题变对、7个原对题变错;100次旧技能复用帮助61次、损害1次。 3.1 ↗
我的解读确有负迁移,20:1帮助/损害比不能保证下一查询不受害。
来源证据成本罚从0到.4,直接回答11.8%→39.8%,归一化适配成本1375.5→886.9,降35.5%。 图3–4;3.2 ↗
我的解读这是以直接答复FLOPs归一化的适配计算模型,不能直接当总系统延迟节约。
来源证据Qwen14B 0.432→0.621,但逻辑−.044、医学−.078;Llama8B数学−.105代码−.042,GLM9B长文−.200。 表2 ↗
我的解读总体增益不等于每领域增益,也不是把同一个策略零训练迁到新家族。
来源证据动作权重1→4使效用.464→.510、非法4.08%→1.72%;非法罚项使耗尽预算21.20%→13.33%。 表3–4 ↗
我的解读工具协议可靠性本身会影响任务结果,不能全归因更好的适配算法。
来源证据不缓存TTT的7B策略训练约单H200 11 GPU小时;重复配置缓存三个适配运行的平均效用。 附录C ↗
我的解读缓存影响训练成本与奖励估计,复现应同时披露缓存命中及在线真正训练次数。
开放情况与使用许可
论文未提供可核实的本工作官方实现或策略/技能适配权重下载;不标记开源。
LICENSE论文为arXiv非独占许可;基座及五种方法的许可分别适用,不能由论文公开推定统一商用授权。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
策略与答案LoRA分开,最终回答不读取策略轨迹,明确检验参数技能作用。
三次独立策略训练报告标准差,并比较提示、语义路由、固定方法、SFT和RL。
反方 · 哪些结论还不够
训练/测试约65%为已知TTT有益样本,而全MATH500在指定方法高收益仅7%,精选收益不能外推。
文档问答最终上下文刻意拿走原文,只测参数记忆;不是与正常RAG或长上下文服务公平比较。
每题快照探索后回滚、金动作推进训练流;部署自主状态可能偏离训练,形式化累计目标并未端到端优化。
综合判断
学习选择和复用适配确有可测价值,但证据是精选、可验证、小模型任务上的控制实验,尚非开放分布稳定自我进化或无需监督的长期学习。
我会先做的验证
建议实验(尚未执行):使用未经收益筛选的真实查询流,加入同预算RAG/长上下文及搜索对照,报告总延迟、显存和策略推理开销;自主推进训练流并测试分布改变、坏技能移除和顺序敏感性。