AW-0:把技能代码接进视频与动作联合预测
默认代码用于指导动作;真正执行代码时还需要另一套门控。
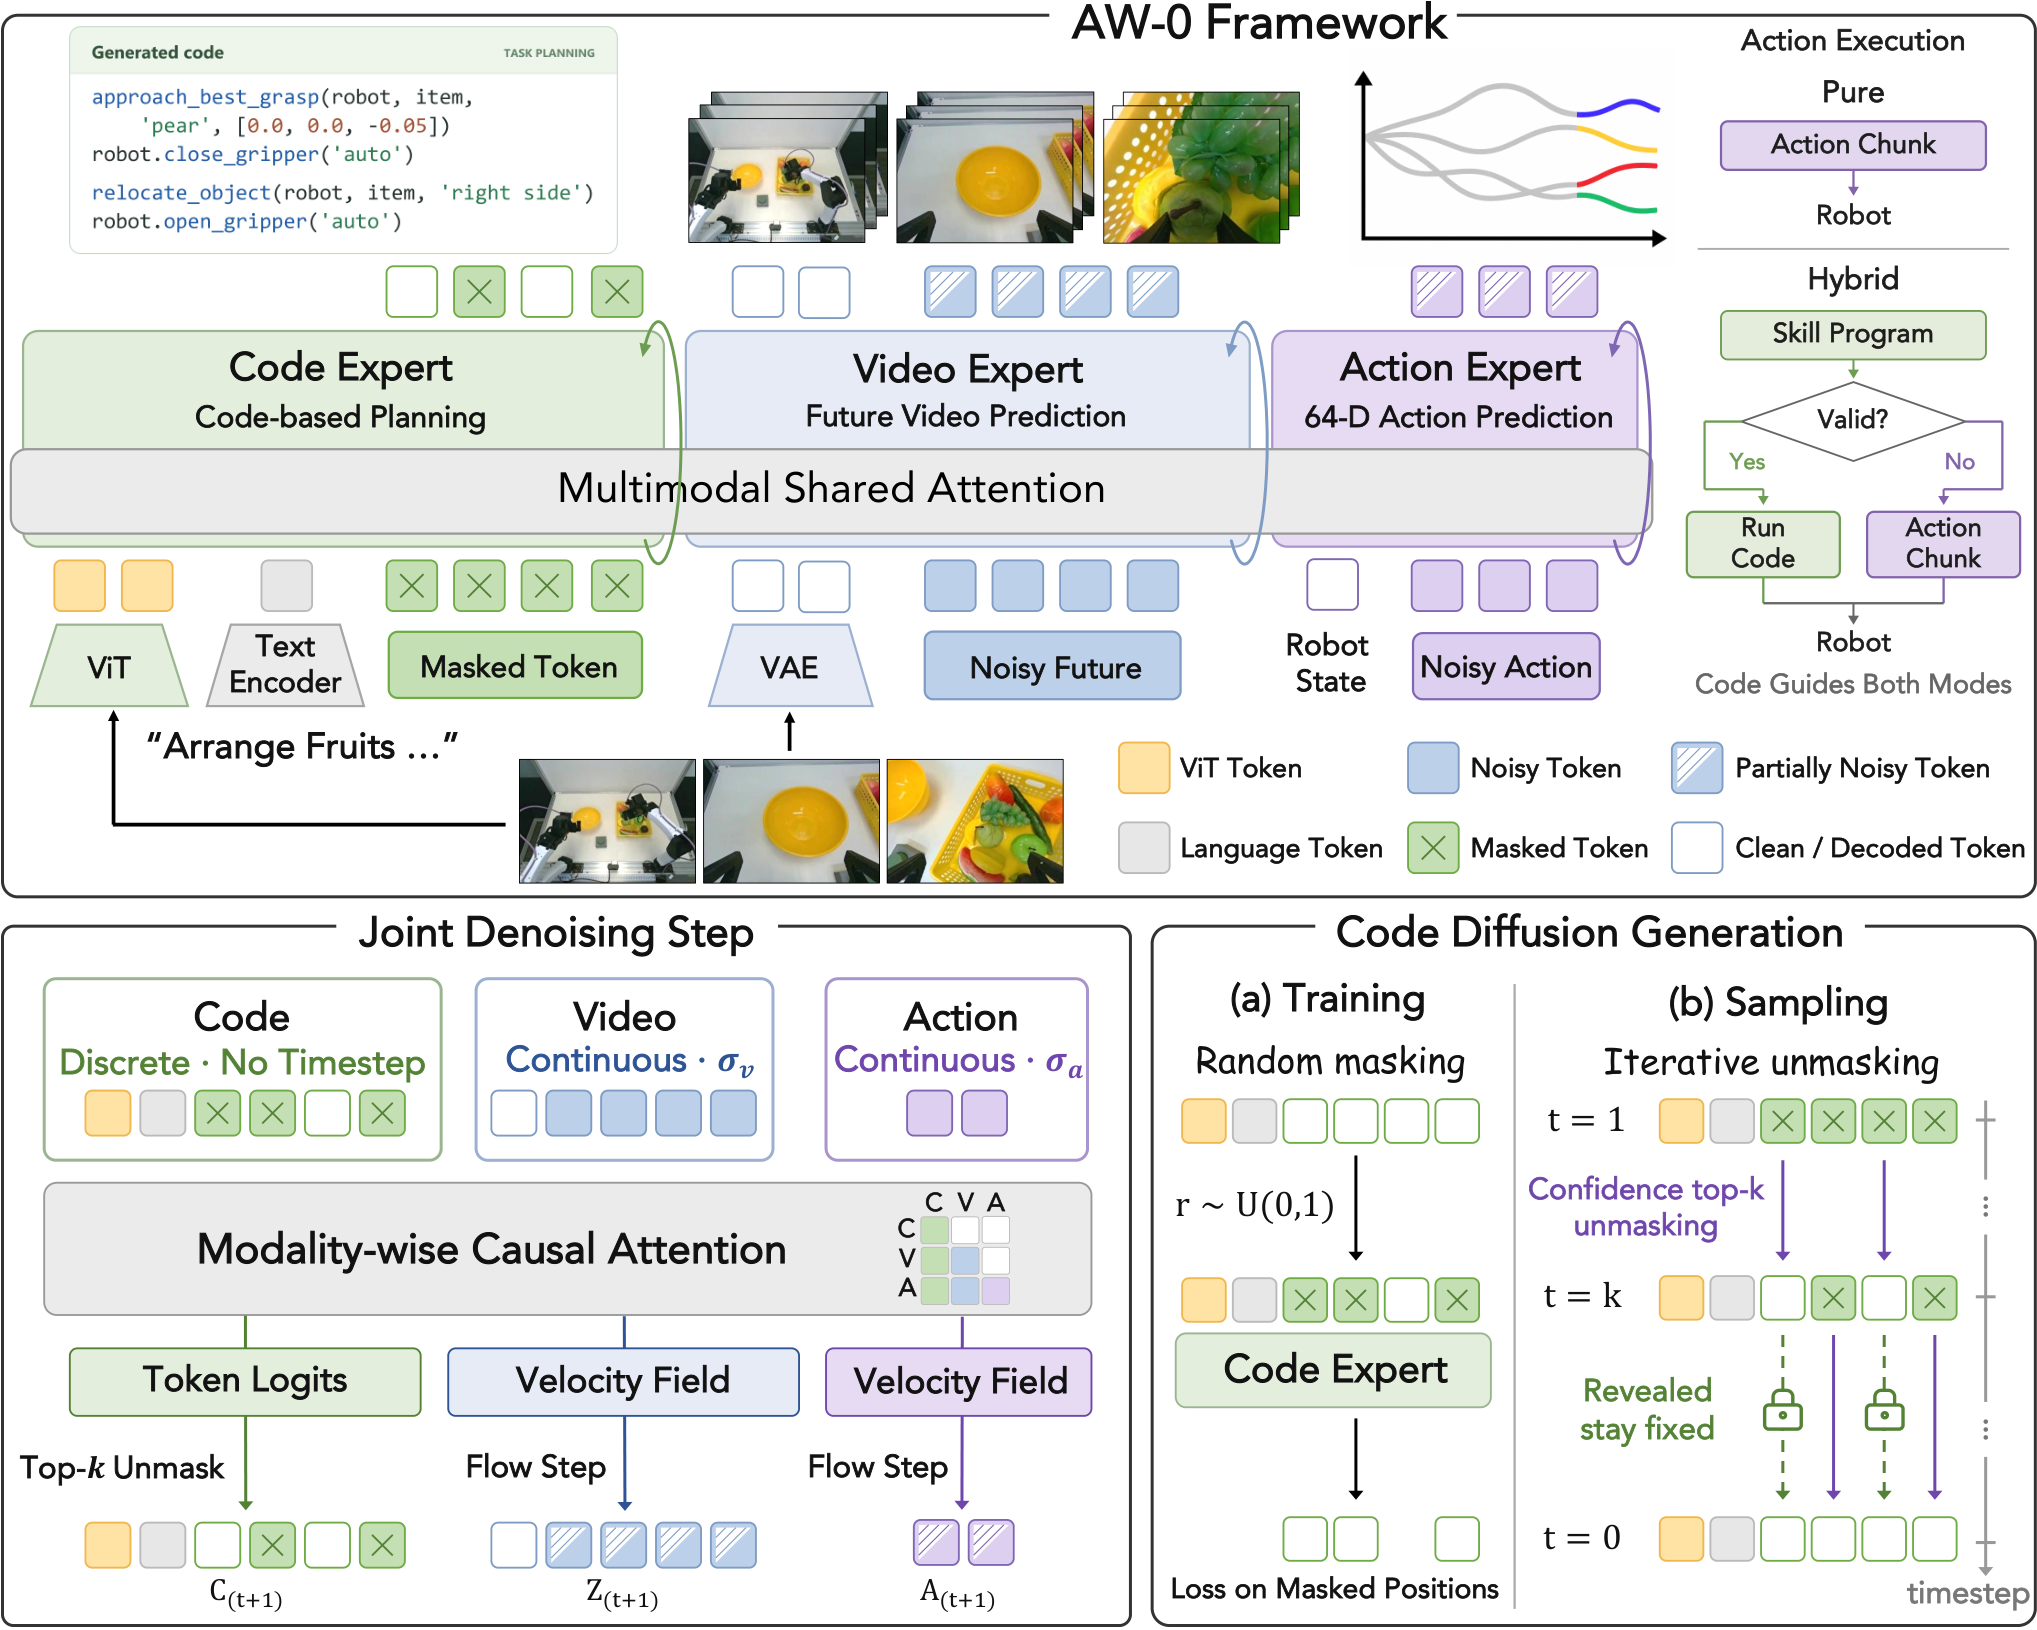
AW-0用三个Transformer专家同步生成技能代码、未来视频和动作。代码为世界动作模型提供显式任务结构,另有混合模式调用控制原语。论文有真实双臂与灵巧手实验,但平均分采用分步骤奖励,并非完整任务成功率。
图解主要方法
默认代码用于指导动作;真正执行代码时还需要另一套门控。
- 1
把示范标注为可复用技能片段
2913小时机器人与人类示范,经自动标注和协调流程形成50个技能。库冻结后按接触与运动证据复用片段;标注的静态语法验证不等于在机器人上验证。人类单相机视图复制到三路输入,不能当作三个真实视角。
- 2
让代码先于视频影响动作
图2三专家各有参数,通过code→video→action的块因果注意力通信。代码做掩码离散扩散,视频与动作做连续流匹配;视频噪声采用预训练分布和均匀分布混合,以裁剪归一化权重平衡目标。四步联合去噪生成128token程序及32步动作。
- 3
区分默认与混合执行
默认程序不直接执行,只通过注意力指导动作。混合模式检查阶段、依赖、语法、白名单和非空代码后调用原语;一旦尝试代码,就丢弃同次预测动作,即使抛异常也重新观察规划。无异常被记为阶段完成,不等于独立确认物理成功。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据平均分71.1,对DreamZero46.0;魔方仅随机一个面的单次扰乱。 实机8任务:每任务100示范、3种子×16回合 ↗
我的解读评分按子步骤加分,不能写成71.1%完整任务成功,也不是任意打乱魔方求解。
来源证据默认clean80.8%、random20.6%;混合63.1%、29.2%,随机场景默认低于π0.5的27.7%。 RoboTwin:50任务×50回合 ↗
我的解读混合仿真使用另采CaP示范,比较同时改变数据和执行模式;清洁场景还明显下降。
来源证据联合推理0.23秒,AR0.55秒,无代码0.19秒;预训练代码可解析87.5%,primitive F1为0.365。 RTX5090与代码质量 ↗
我的解读延迟包含编码、视频解码和动作处理,但语法通过不保证参数正确;真实混合只在YAM毛巾任务验证。
开放情况与使用许可
官方GitHub含实现与BSD-2-Clause许可,模型页实际列出agenticwam_pretrain.pt并声明同许可;底层Cosmos、Wan、SDAR等依赖保持自身许可,不能把单个许可覆盖整个组合。
LICENSE论文 CC BY 4.0;项目 BSD-2-Clause
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
技能结构能在低层预测前约束任务语义,是连接代码规划与接触动作的具体实现。
反方 · 哪些结论还不够
视觉分布变化、滑落与接触丢失仍突出;混合门控不估计代码优于动作的概率,系统未在线学习。
综合判断
值得复现三流条件化,但应分别验收完整成功、部分进展和混合执行收益。
我会先做的验证
未执行的验证方案:保持训练数据和检查点完全相同,切换纯动作与混合执行,报告整任务成功率、碰撞、接管和代码实际触发比例。