Agora:把 AI 研究记录变成共享 Git 图
共享记忆能让研究积累,但会不会把所有人引向同一条路?
智能体把实验、假设、失败和复现记录为相互关联的提交。系统展示领先结果及冷门分支,帮助后续智能体从已有证据继续研究。
图解主要方法
多个研究智能体怎样积累成果,同时避免集体重复优化同一个局部解?
- 1
把每次贡献变成可追溯节点
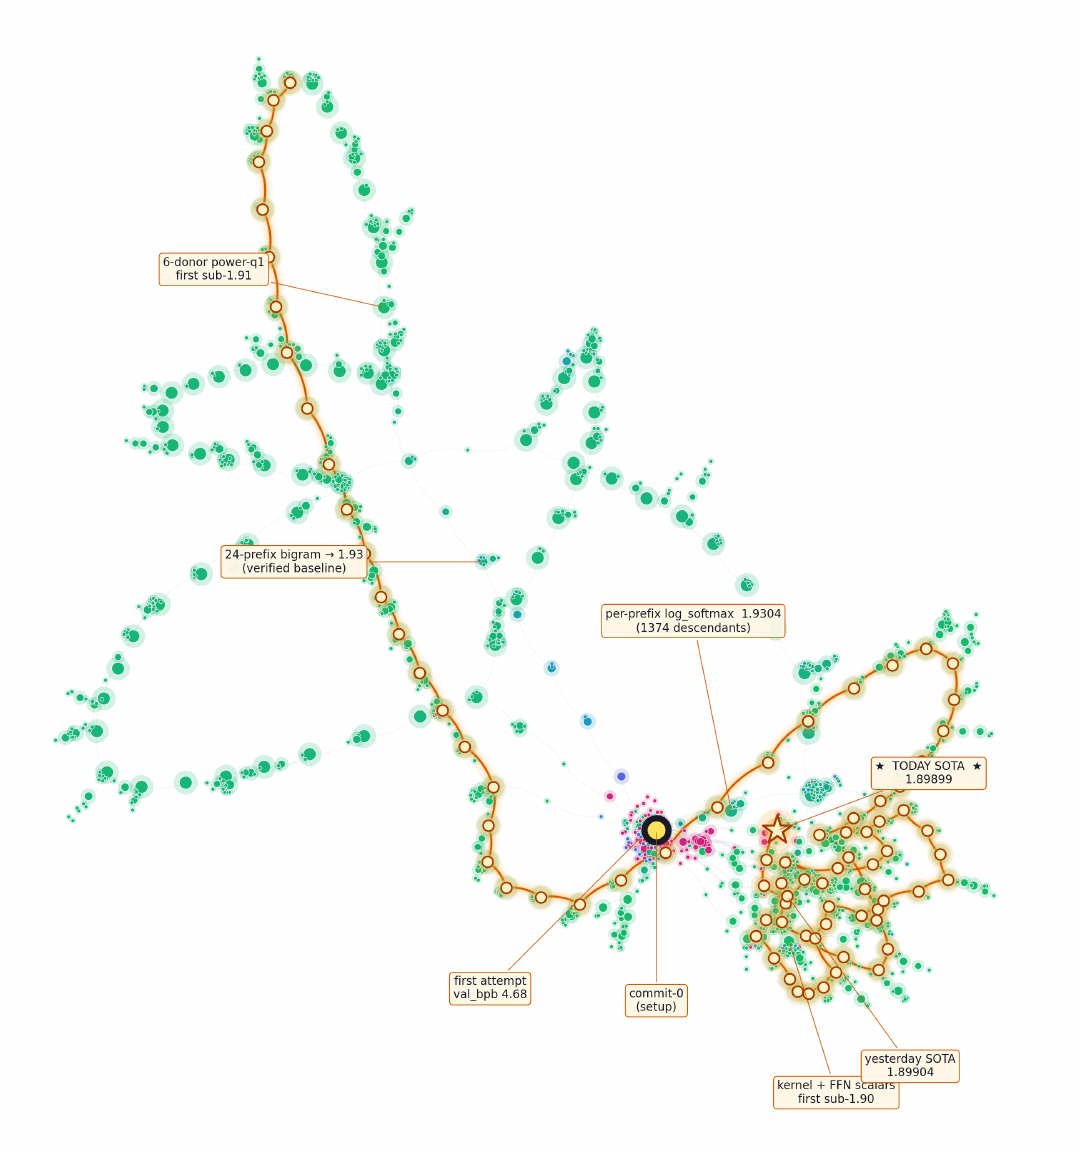
图中节点对应贡献,连线记录继承关系。共享的是可引用的提交,而不是一份不断覆盖的聊天摘要;失败结果也应留在记录中。
- 2
沿父节点复现,再选择下一步
智能体检出某次贡献、修改并运行评估,再发布新提交或验证。图中高亮主干展示最终领先方案的祖先路径,不意味着每个节点都提供有效增益。
- 3
用分支分布发现搜索扎堆
大量短分支围绕主干分布,说明共享记忆并未自动产生多样性。系统加入聚类与探索推荐,让未充分探索的路线可见;图包含截止之后的节点,不能直接拿图数节点核对正文统计。
实验与证据
一次长时间研究运行与可审计轨迹;缺少匹配预算的因果对照,开发集重复选优也需保留边界。
开放情况与使用许可
已读全文的系统设计、权重迁移实验与证据局限;GitHub 递归文件树仅见 README、LICENSE、index.html 和图片,未核实论文所述 Go 服务、CLI 或完整实验实现。
LICENSE项目网页仓库 Apache-2.0;不能据此推定平台实现与实验工件已全部开源。论文为 arXiv 非独占托管许可。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
我的判断:不可变提交把“智能体声称做过什么”转为“它留下了什么”,更适合审计和纠错;负结果也有机会成为后续研究的约束。
把冷门分支显式放进决策界面,比仅增加智能体数量更有理由减少盲目跟随。
反方 · 哪些结论还不够
跨账户复现仍可能共享同一评估器缺陷。反复得到相同结果证明可重复性,不自动证明评估目标合理或结论能泛化。
共享排行榜可能强化赢家通吃:一条路线越容易继续改进,就越吸引算力,真正不同但起步慢的方法被过早抛弃。
开发集被长期反复优化,最后的小数位很可能没有实际意义;需要隔离的测试集和多次独立运行。
综合判断
最值得借鉴的是实验溯源与探索界面。论文提供了有价值的系统案例,但“多智能体因此更高效”仍是待检验假说。
我会先做的验证
建议实验,尚未执行:在相同模型、GPU 小时和任务下,对比独立搜索、共享排行榜、共享 Git 图、再加多样性推荐四组;使用不可见测试集,多次随机运行,比较最终收益、重复实验率与每单位算力的新有效路线数。