ValueMap:训练模型更重视一种价值,会顺带改变哪些行为?
行为激活比价值名称更能预测迁移,但相关性还不是可控对齐
逐个价值微调四个基础模型,测量对未训练价值的变化,建立有方向的泛化矩阵;再比较名称、行为文本、权重差、persona激活和梯度表示的余弦相似度能否预测它。最后用激活表示分析多价值目标与分类体系。
图解主要方法
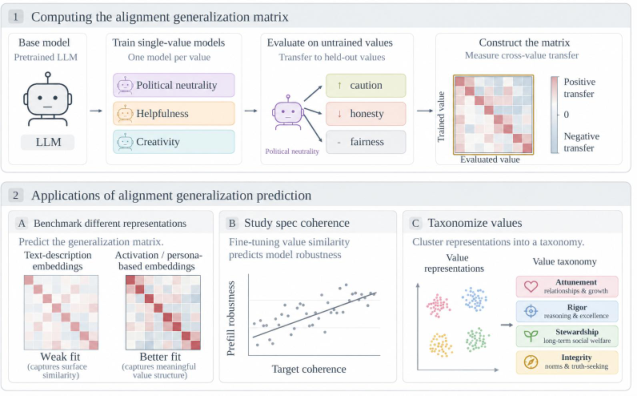
图1如何从单价值微调得到泛化矩阵,又如何防止相似度被误当因果保证?
- 1
先建立真实训练迁移矩阵
图1上排对66价值逐项生成5000条SFT数据;DPO从公共偏好中用最小费用流分配49组互不重叠的4000对,先做19748条“价值中性”SFT。用11188个冲突场景评估,改善除以剩余上升空间、退化除以原分数,得到[-1,1]分段迁移量。
- 2
从正反行为差异提取表示
Persona取同一价值正反回答的平均残差激活差;Gradient取偏好损失对激活的梯度方向。小模型在独立激发问题上选层,大模型按相对深度固定;表示不直接偷看对应微调训练对。
- 3
用非对角秩相关检验,而非只画聚类图
图1下左把相似度与49×66矩阵的非对角元素比较。描述嵌入、行为文本、权重差都作基线;方向性矩阵的对称化相关约0.89只是对称预测器的参照上限。
- 4
检验目标鲁棒性并建立分类
64组六价值目标各用12000对DPO,300个冲突场景先直接回答再插入反目标prefill。平均pairwise相似度预测归一鲁棒性;ValueMap再以k-medoids将266价值分四类,类别不是人类价值的普适真理。
实验与证据
已阅读v1完整正文及其公开附录、核对作者实验与必要原图;未独立复现实验。
来源证据八设置聚合Persona Spearmanρ0.45±0.07,描述嵌入0.05±0.03,行为文本0.35±0.05;±为bootstrap95%区间。 表1 ↗
我的解读行为上下文贡献很大,激活进一步改善;不能把相关系数解释成预测正确率。
来源证据64目标Persona一致性与prefill鲁棒性ρ0.43、p=0.0005;描述一致性ρ0.12、p=0.37。 §5 / 附录B.4、G ↗
我的解读在单模型和该分层目标集合中成立,不能推出提升相似度必然改善真实对齐。
来源证据不同模型Persona相似矩阵平均ρ0.84,但266价值的两种ValueMap分类ARI0.24。 表2 / 附录I ↗
我的解读共享表示几何是初步证据,聚类边界仍会变化。
开放情况与使用许可
官方MIT仓库含训练与预测源码、测试、泛化矩阵和论文复算脚本;外部模型、数据需分别下载,本次未执行重训或复算。
LICENSE论文及图1 CC BY 4.0;本仓库代码MIT;基础模型及外部数据保留各自许可。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
四个7–32B模型、SFT与DPO共八设置均比较多类表示;独立多价值实验为下游用途提供额外证据。
反方 · 哪些结论还不够
64目标的鲁棒性实验仅Qwen3-8B且按coherence分层抽样;不是随机干预提高一致性后的因果效果。跨模型聚类ARI仅0.24,几何相似不等于类别完全一致。
综合判断
支持用行为激活辅助预测训练副作用,但0.45的秩相关仍留下大量不可解释变化,不能当安全保证。
我会先做的验证
未执行的验证方案:在另一套价值来源和多轮工具任务上预注册目标,交换评分模型并人工抽查;比较有方向预测器与余弦,并报告负迁移、校准和最坏价值损失。