Arc:让机器人策略学会使用“为什么要做这一步”的语言条件
75K旧演示重标注,外部VLM持续提供推理;减少去噪步数不是端到端十倍提速
Arc把已有DROID演示重新标注成状态、原因、预期效果、动作、禁止效果与完成状态,再微调π0.5和Cosmos3-Nano,让动作生成真正依赖这些语言条件。部署时推理仍由额外视觉语言模型异步提供,原策略负责连续动作。多个零样本任务有明显收益,但额外标注、训练与推理成本不可忽略,强语言依赖也会把错误或过时推理传入机器人动作。
图解主要方法
已有机器人策略能否通过动作目的语言监督,学会利用推理而不只是生成附属文字?
- 1
从旧演示恢复与动作对齐的因果叙述
Gemini2.5 Pro看完整腕视视频叙述并挑关键帧,GPT5.5生成场景谓词与逐帧轨迹。DROID训练95,658段中标74,740段、约120万帧;多数缺失无可用指令。谓词是模型判断而非真值,保留帧索引/时间戳将语言对齐原动作块,不收新机器人演示。
- 2
使VLA动作头能够读到语言差别
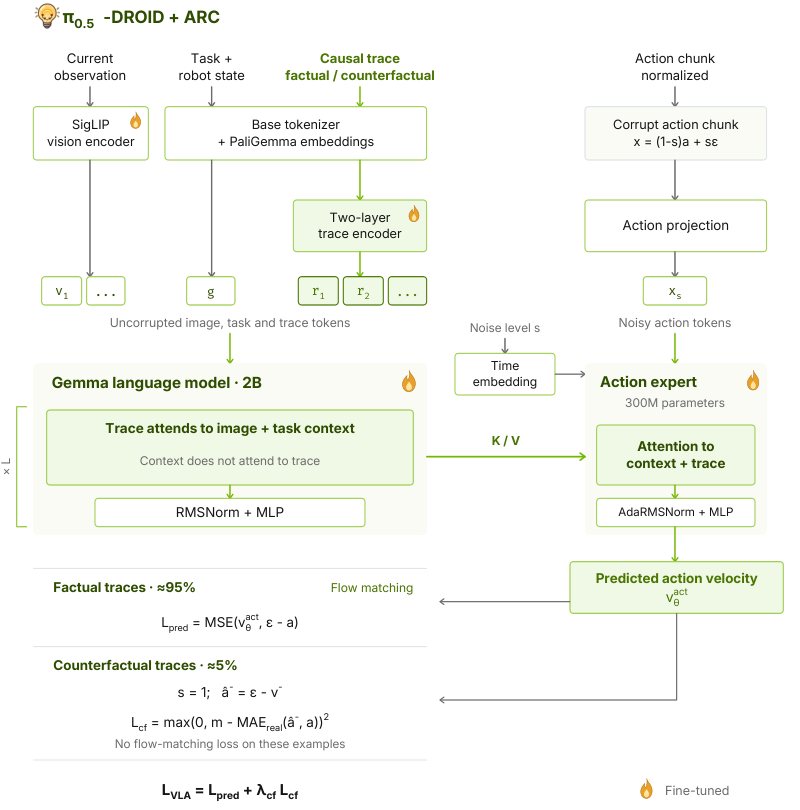
π0.5在共享词嵌入后加2048→512→2048的2层8头trace encoder,最多320token,输出零初始化;轨迹看图像和任务,动作头看两者与轨迹。18层共同微调视觉、Gemma2B和300M动作专家,trace位置排在动作位置之后以保持原动作RoPE索引。
- 3
用负例阻止忽略轨迹,但不提供替代动作答案
约5%训练行改成“不要抓目标”型反事实,固定纯噪声时刻并排除正常flow loss。一步估计动作与原示范8个非padding坐标的平均绝对距离必须超过0.3,否则平方hinge惩罚,权重1;这只保证分离,不等于学到正确拒绝动作。Cosmos联合训练语言CE和动作/视频flow,不采用此负例loss。
- 4
外部推理异步更新,策略执行最新通过格式检查的文本
默认Qwen3.6-35B-A3B-FP8本地vLLM,当前外部/腕视两图加任务生成短段落,无上次推理输入。15动作块、15Hz控制与约1Hz示例刷新分开;迟到/无效回答保留旧段落。验收规则检查长度、开头、禁数字和完成短语,未验证物理事实;首条前有固定启动叙述。
实验与证据
正文及附录A–G完整阅读,目视检查图9/12和嵌入图片的超参表5/6,核对项目发布状态;未独立复现。
来源证据RoboLab120任务每设置1,200episode;默认π0.5 28.0→45.3、Cosmos36.8→48.8;Molmo九任务45.0和57.6%。 表1–2;附录C ↗
我的解读不使用基准训练,其他基线部分来自报告/榜单;零样本指任务迁移,模型确实在重标DROID上微调过。
来源证据自建Reasoning-50每模型500次:π0.5 10.2→57.0、Cosmos11.0→61.0;硬件28任务每题3次,π0.5 9.5→91.7%。 表3;附录C.1.3/C.2 ↗
我的解读硬件增益82.2个百分点,不是82.2%;27仿真任务来自硬件评估,仿真与硬件不是独立抽样的两组任务分布。
来源证据图9完整45.3,去Cause&Effect39.25、去Action30.58、仅Action27.42、State+Action32.25%。 图9;附录C.3 ↗
我的解读支持轨迹内容组合重要,但每种变体分别微调;粗子任务基线不微调、无重规划且失败超时跳过,不是完全匹配的分层系统。
来源证据VLA全参数3万步、global batch8、8张A100、lr10⁻⁵;WAM25,450步、128张GB200、154.29小时、lr2×10⁻⁴。 附录D表5–6 ↗
我的解读资源来自原图表5/6,WAM含8B reasoner及generator,不应把“复用数据”写成几乎免费。表6 trace loss系数仍以符号表示。
来源证据π0.5单Euler步接近十步基线,项目页说明相差0.4个百分点;Cosmos两步超过四步基线。 图7–8;附录B.3/F ↗
我的解读减少求解步不等于同比总延迟,视觉/语言编码、异步reasoner GPU和旧轨迹风险仍存在;4.3倍训练更新减少也非总GPU成本比例。
来源证据外部reasoner图9约44.4–45.6%,内置Cosmos8B为40.4%;文本检查允许150–950字符、3–8句。 图9;附录G.3 ↗
我的解读不同外部模型近似不代表任意错推理都稳健;请求要求少于900字符与验收上限950不同,二者均只是格式范围。
开放情况与使用许可
作者项目页Code、Model、Dataset及RoboLab-Reasoning-50均Coming soon;正文说明评审期后发布。当前仅论文、配置与视频展示已确认,不标开源。
LICENSE论文及引用图12为CC BY 4.0;尚未发布的Arc权重、数据、代码许可未确认,DROID、基础模型及外部推理服务各自条件独立。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
同检查点无基准专项训练,RoboLab默认π0.5由28.0→45.3%、Cosmos36.8→48.8%;完整轨迹明显优于动作命令单独条件。
图9全模型微调π0.5为45.0%,只训练动作头30.9%;显示语言表示适配与控制头共同训练有价值。
反方 · 哪些结论还不够
正文“无需架构修改”需要限定:π0.5实现实际增加2层trace encoder;Cosmos路径才是直接用已有reasoner接口。
表6 WAM用128张GB200、154.29小时,约19,749 GPU小时(据表相乘),还未计标注与外部推理;“不重做基础预训练”不等于廉价微调。
10倍/2倍是达到基线效果时去噪步数减少,异步约10ms是新增控制环阻塞开销,不是VLM生成耗时或端到端加速。
注意力变化不证明语言因果机制;负例只要求与原动作分离,且训练看全段视频得到标注,部署只能看当前两图,存在监督信息差。
综合判断
动作效果语言加共同微调在所测任务上有强实验证据;应将系统理解为外部推理与动作策略的组合,不应宣称单个策略自主推理、无结构改动或低总成本。
我会先做的验证
建议实验(尚未执行):在相同总训练/推理成本下匹配分层基线;随机打乱或延迟轨迹,加入语义错误但格式正确的推理;对替代动作做正确性评测,多seed跨形态测试,并报告总功耗、VLM响应时间与轨迹年龄分布。