ARPS:让世界动作模型只传递对动作有用的预测状态
32个状态token、两种未来目标,较大收益出现在分布偏移测试
预测视频容易不等于表示适合控制。ARPS 先诊断不同教师表示能读出多少动作信息,再用 V-JEPA2 的未来绝对状态与变化量监督紧凑接口;部署只看当前观察,不需要生成未来视频或运行教师。
图解主要方法
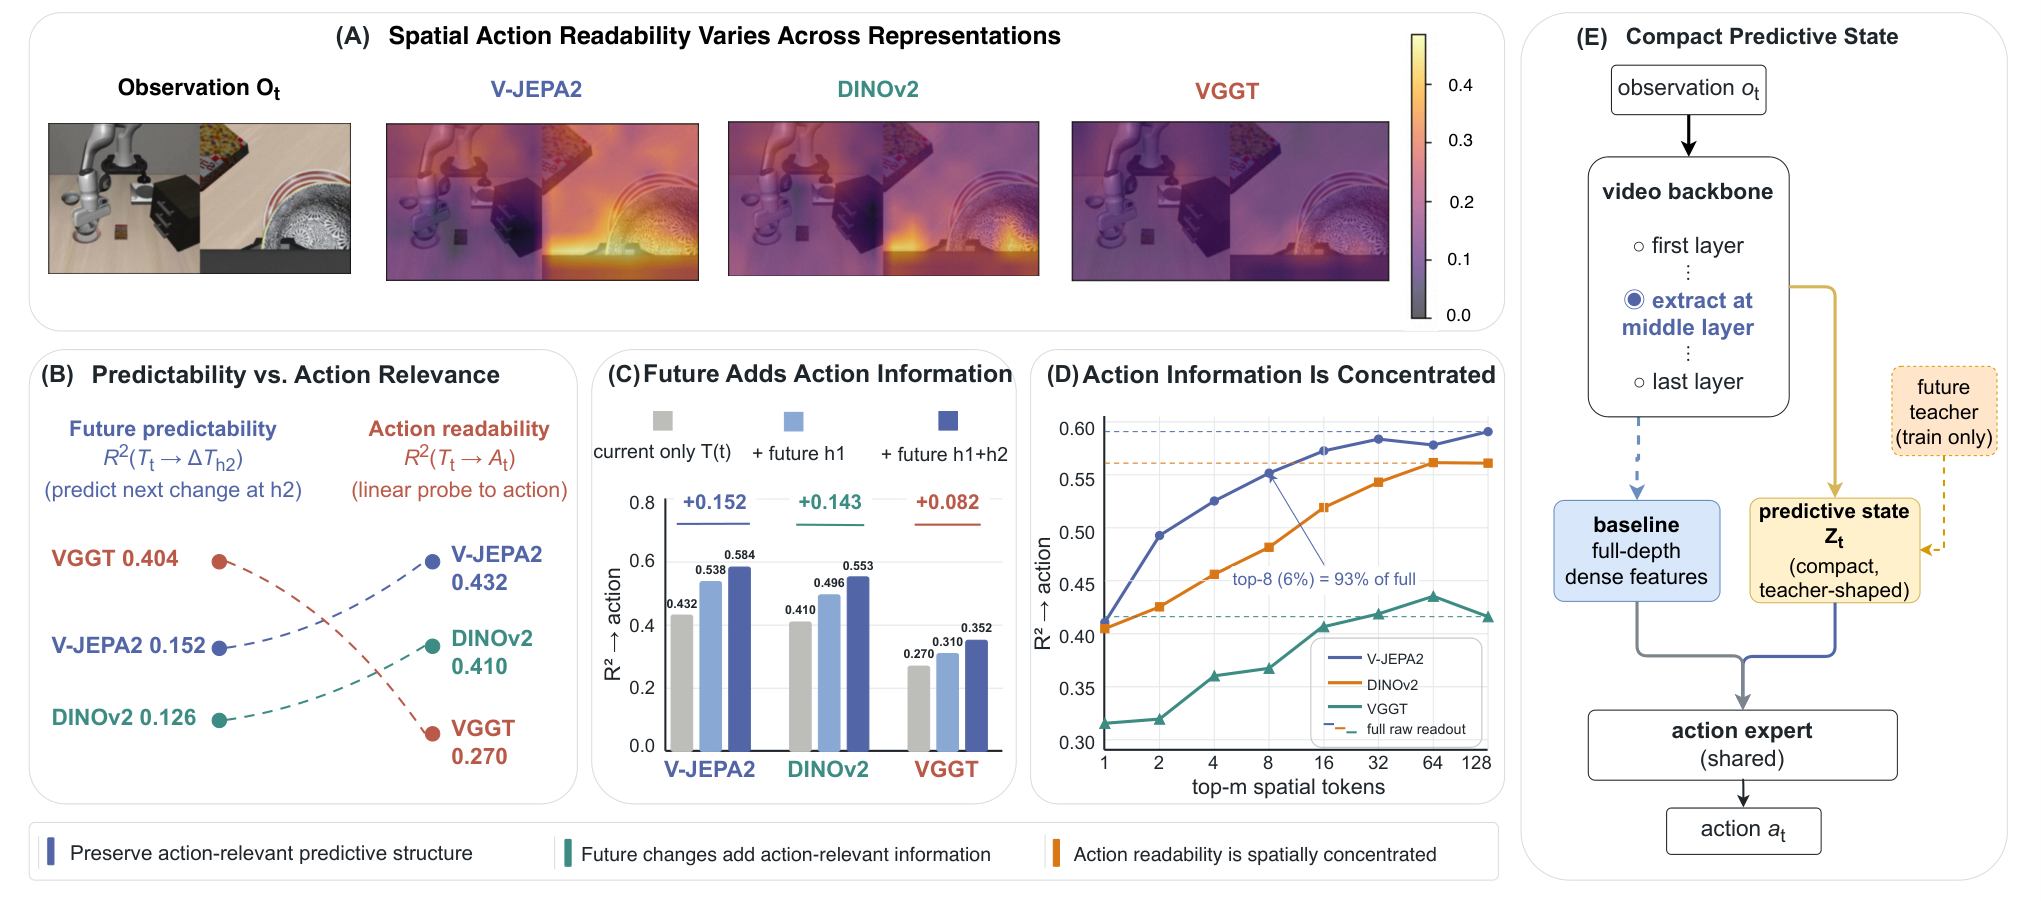
图 1 的诊断怎样转化为右侧紧凑状态,而不是把真实未来偷给策略?
- 1
区分未来可预测与动作可读
图1A/B用线性探针比较V-JEPA2、DINOv2与VGGT:几何教师未来变化更好预测,却不一定更容易解码动作。C把真实未来加入探针仅作信息上限诊断,不能当部署输入;D显示空间信息集中,启发容量瓶颈。
- 2
从中间层聚合32个状态
图1E在Wan5B视频专家第15层提取当前帧特征,三层预测器用32个学习查询交叉注意力聚合。查询分到两个未来时间组,但组间自注意力共享信息;动作专家的全部视觉上下文都必须通过状态Z,文本与本体状态另保留。
- 3
训练时同时监督绝对未来与差分
每个时间组用独立位置查询头预测冻结V-JEPA2的未来表征及相对当前的变化,用余弦加Smooth-L1约束。教师用因果四帧片段、训练集逐通道标准化;两个h是视频latent时间范围,不是两张瞬时未来帧。原视频与动作flow损失仍保留。
- 4
部署删除教师并提前结束视频专家
推理按当前观察→中间特征→Z→动作块执行,教师和监督头删除,视频专家在提取层停止。未来监督塑造了表示,但状态不是已观测未来;32token只是被测最优容量,不意味着越小或越大必然更好。
实验与证据
以下为作者报告;已阅读 v1 全文及可用附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【主要结果】LIBERO99.2%;未适配LIBERO-Plus87.3%,作者重跑Fast-WAM48.1%。Plus含10030扰动变体、每变体一次;RoboTwin两组各5000次,平均均为90.7%。 表 1–3、附录 A/B ↗
我的解读我的解读:OOD收益明显,但双臂平均未提升,Random组略降。全部为仿真,不能转述成真实机器人可靠性。
来源证据【控制消融】同教师的当前目标49.0%、近未来72.4%、双未来87.3%;相同监督的稠密接口76.8%,去视频损失64.6%。 表 4 与附录 C ↗
我的解读我的解读:未来目标、紧凑接口和视频共同训练都贡献收益;线性探针分数本身仍不足以完全解释泛化差异。
来源证据【速度与机制】H20完整动作块306ms,对照353ms;噪声干预状态会改变成功率,但未单独隔离未来信息。 第 5.3 节与附录 D/F ↗
我的解读我的解读:约13%时延改善是动作块生成,不是机器人底层控制频率。状态与轨迹相似性是关联证据,不能单凭噪声干预证明未来因果机制。
开放情况与使用许可
09-20 首发回顾补收;全文附录已读。未核实专属实现或权重公开。HTML架构段的图引用缺失,本页使用实际存在的图1及正文方法解释,不虚构另一幅图。
LICENSE论文及图 1 为 CC BY 4.0;模型及实现许可未确认。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
用部署动作任务反过来设计世界模型表示,而非假定视频重建越好控制就越好,且有同架构消融支撑。
反方 · 哪些结论还不够
只有一个骨干和仿真评测;真实接触、跨本体及多种子统计稳定性未被解决,表示噪声试验不等于未来信息消融。
综合判断
适合研究低延迟WAM的动作接口;真实部署价值应由接触任务与分布偏移的独立闭环测试确定。
我会先做的验证
未执行的验证方案:保持教师、参数和训练预算,比较32token、稠密接口、当前/未来/打乱未来监督;在真实多物体任务和统一扰动集上多种子报告成功率、碰撞、P95延迟及失效类型。