SGS:百万并行机器人训练,关键还在把样本分给“快学会”的任务
成功率驱动的重置采样提升难任务学习,近目标覆盖与真机工程仍不可省
Success Guided Sampling维护固定任务配置最近的成功率,把更多重置分给成功率适中的配置,同时保留所有配置的非零采样机会。在百万并行环境中,它改善复杂地形和螺母装配的学习;视觉策略蒸馏后完成三项真机装配,但最难任务仍有明显仿真到真实差距。
图解主要方法
如何把并行仿真预算分配给仍在学习的配置,而不浪费在过易或暂时不可解的重置上?
- 1
先构造有覆盖的任务配置库
配置含初始状态、目标与环境。行走使用104000种地形/起止配置;操纵每任务32768个碰撞检查重置,平衡Reaching、Stable Grasp与Near-Goal三类。SGS不会创建库外新配置,近目标重置仍需任务几何先验。
- 2
用近期布尔结果估计可学程度
每配置维护最近100次结果的循环缓存,以均值p估计当前成功率。它混合了难度与此前训练经验;新技能迁移后旧配置成功率也可能变化,所以不能只在训练开始估一次。
- 3
用Beta形状把采样集中于能力边界
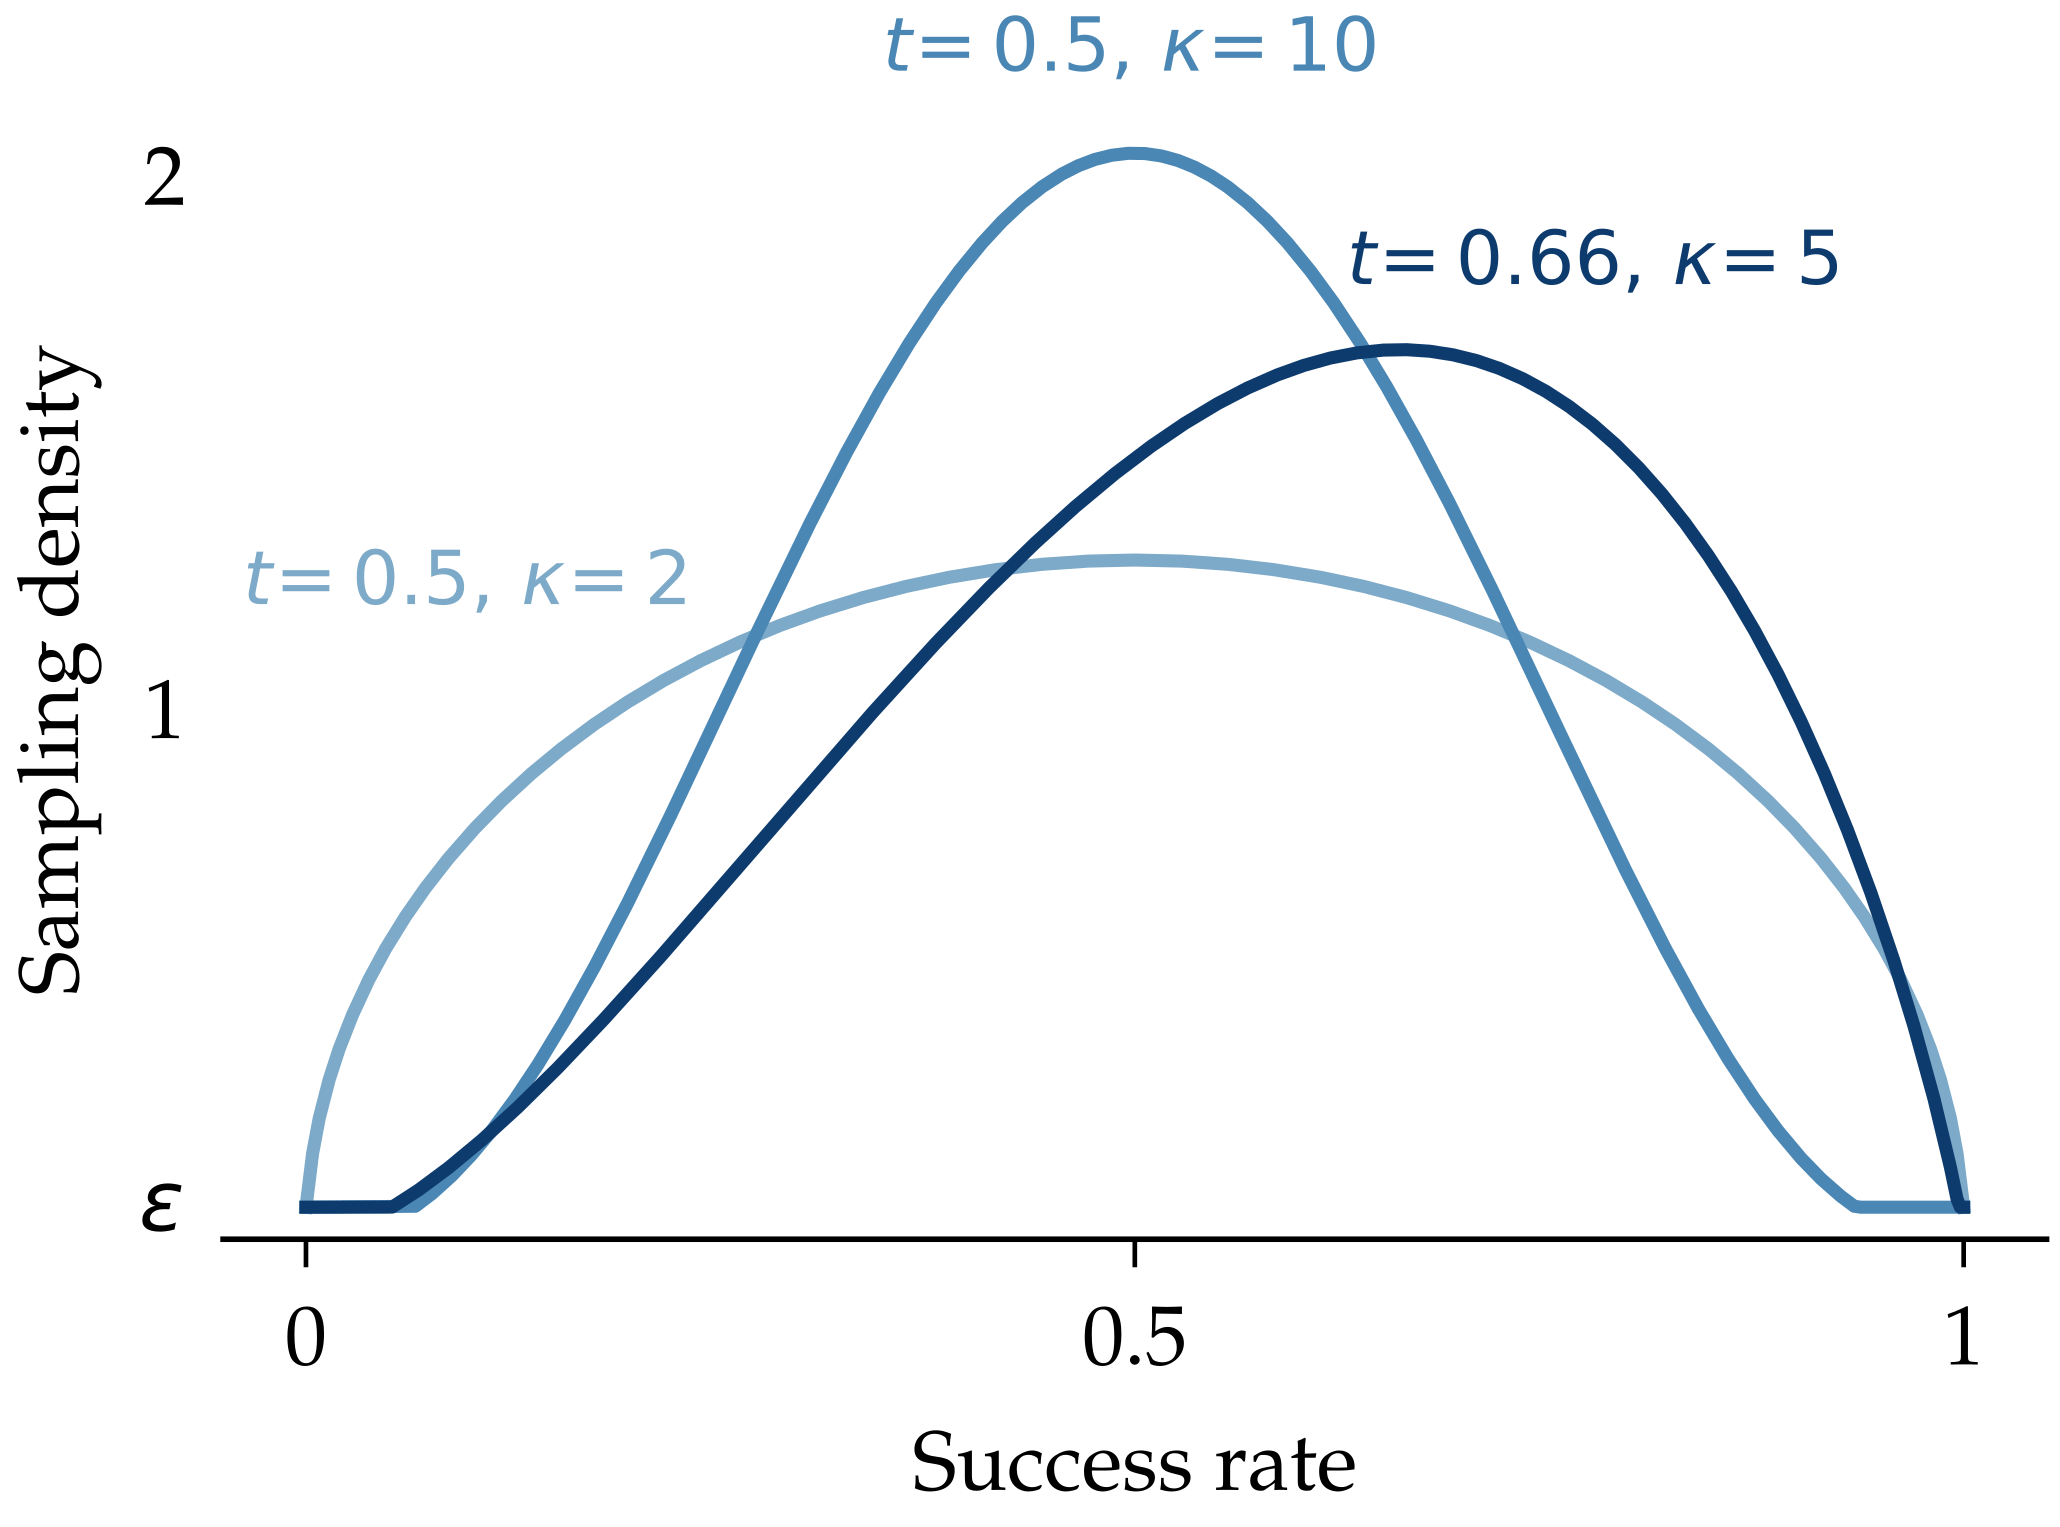
图2中权重近似(p+ε)^(κt)(1−p+ε)^(κ(1−t)),t决定偏好成功率,κ决定集中程度。再取带下限的log权重做温度softmax;所有配置保留非零机会。行走t0.66、κ5,操纵t0.5、κ1,温度2。
- 4
在PPO外层替换重置选择
episode结束记录成功,再按新分布选配置;PPO本身继续采样和更新。每个领域共用奖励,但还含功耗、姿态、接触或动作变化等正则项,并非完全无奖励设计。
- 5
从仿真教师蒸馏到RGB学生
操纵点云教师使用带特权状态的critic,通过在线DAgger教侧面/腕部双相机ResNet-18学生。保留6.67%环境不参与梯度,防止逐步在线更新夸大训练成功;硬件仅运行冻结RGB学生,无真实数据微调。
实验与证据
完整阅读69282字符全文、参考文献及附录A–C,视检原图2并核对官方项目页、超参数、真机协议和重置消融。未执行训练或真机实验。
来源证据百万环境多地形成功73%,PLR54%;Franka螺母70%,均匀6%、PLR5%。每规模3训练种子,固定PPO迭代和mini-batch数,batch随环境数增长。 图5、官方结果表 ↗
我的解读同规模对比支持采样价值,跨规模提升同时增加样本及算力。百万Franka均值区间约±19个百分点,不能忽略波动。
来源证据较易UR5e插杆在32K时SGS能学成而两基线0,256K时各方法约98%;另组64K最终SGS95.70略低于均匀95.90。 图5(c)、附录表6 ↗
我的解读更快达到能力与更高最终上限是不同结论;简单任务高规模下不必然受益。
来源证据4K行走SGS45.6±1.9%,SFL最终25.5±5.1%、最佳28.9±1.5%;32K SGS49.4±11.3%、SFL最佳42.1±3.2%。 表1、附录B.1 ↗
我的解读均为3种子的95%区间;32K区间重叠且SFL用默认超参,不把均值差当作所有调参条件下确定胜出。
来源证据插杆去Near-Goal后两保留分布均0%;去Stable Grasp后Reaching63.8、Near-Goal81.3;三类全用为96.0和100。 附录表4 ↗
我的解读采样器依赖可达学习路径,非零采样概率不能代替有用重置覆盖。
来源证据去重力课程的一个训练种子,在512评估episode中69.4±4.0%,有课程70.2±3.9%。 附录表5 ↗
我的解读区间来自评估episode而非多个训练种子,证据只支持该配置可不依赖课程,不证明课程在所有任务无影响。
来源证据真机螺母18/48=37.5%,杆30/49约61%,齿轮47/50=94%;RGB仿真分别89.05、93.36、96.42%。 表2、附录C ↗
我的解读螺母与杆迁移差距较大,不能只突出齿轮成功。桌板贴胶带减少反光并增加摩擦,且固定在桌面。
来源证据首试成功分别12.5%、28.57%、76%;吞吐0.23、0.71、3.08成功/分钟,包含重置时间。 表2、附录C.5 ↗
我的解读首试定义允许第一次插入前重新抓取,和OmniReset把任何重抓计重试不同,不能不加说明横向比较。
来源证据行走约36小时,Franka螺母128小时;UR5e螺母约335小时,RGB蒸馏另约两天、4张L40S各480环境。 第4节、附录A.2与C ↗
我的解读控制频率与接口不同会影响训练成本;“百万并行”不是用户轻量本机即可复现的成本描述。
来源证据附录配置密度说明把p×p起止组合与52000/104000/208000数量对应,同时正文地形组合计数又为104000。 附录A.1、B.2 ↗
我的解读p翻倍但配置数只翻倍,与全笛卡尔积描述不完全一致;精确枚举方式需代码发布核实,不自行补出确定实现。
开放情况与使用许可
官方sgs-rl.github.io提供论文、方法、结果及演示,代码按钮明确标注coming soon,未核实代码仓库和检查点。因此本轮仅确认论文与项目页公开。
LICENSE论文和图2为CC BY 4.0。原始SVG栅格化为PNG并铺白底,曲线及文字未改动;实现和权重许可待发布后核实。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
同规模、同PPO超参数比较下,SGS在困难装配和多地形有显著均值优势,并给出3训练种子的区间。
重置消融、采样形状敏感性及RGB蒸馏留出环境揭示了方法奏效的条件,证据超出单一成功演示。
反方 · 哪些结论还不够
百万环境同时改变数据量与batch规模,不能等同固定总计算下的效率证明;最难UR5e训练约335小时,RGB蒸馏另需两天四卡。
算法只重新分配已有重置,近目标缺失时成功率0;目标附近如何构造及成功条件仍依赖任务工程。
真机螺母18/48,远低于约89%的RGB仿真;贴胶带、固定板、摩擦与对称性处理对结果很重要,不能省略为纯粹零工程迁移。
综合判断
主要贡献是在困难任务与大并行训练中验证成功率采样的实用价值,而不是提出全新的课程原则。它降低部分奖励和课程设计负担,但尚不能消除重置先验、物理建模与真机调试。
我会先做的验证
建议实验,未执行:在固定总环境步数和GPU小时下比较SGS、均匀、PLR及重调参SFL,跨任务改变近目标覆盖与成功标签噪声;真机使用固定协议报告首试、重试、人工重置和吞吐,并测无胶带或板位置变化下的退化。