大模型在上下文中形成信念状态几何
从“可以读出”走向“确实参与预测”的机制证据
用隐马尔可夫过程生成序列,检查大模型内部是否表示隐状态的后验分布,再通过修改这一表示检验它是否影响预测。这里的“信念”是统计状态,不是主观意识。
图解主要方法
预测下一个符号时,模型是否维持了对不可见生成状态的概率判断?
- 1
先知道正确答案是什么
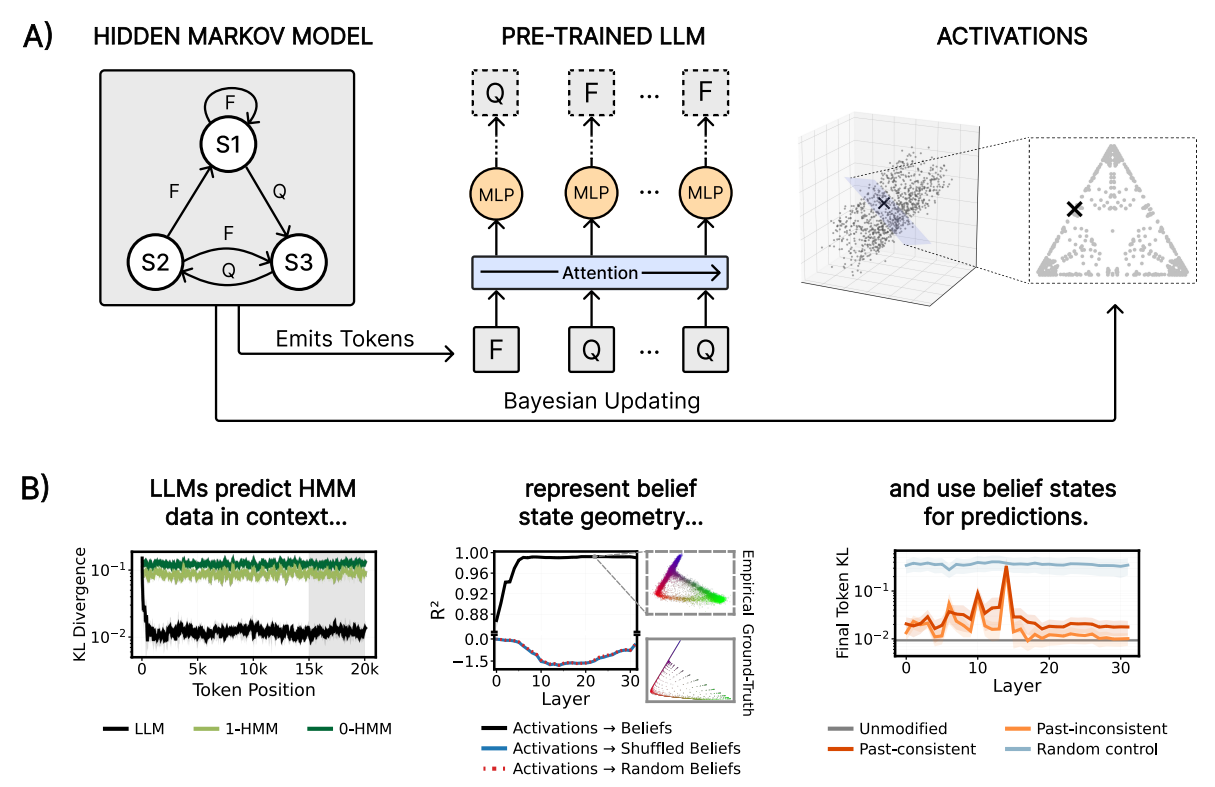
图 A 左侧 HMM 的 S1/S2/S3 是隐状态,F/Q 是可见符号。已知生成规则后,可以计算每段历史对应的真实后验。
- 2
将统计目标与内部表示对齐
图 A 中间将序列输入预训练 LLM;右侧用线性探针从激活恢复后验。图 B 中部比较真实目标和随机、打乱目标。
- 3
修改表示,看预测是否改变
图 B 右侧对应干预:写入目标后验相关表示,检查输出更接近目标的预测分布,还是仍跟随原历史;只画出几何形状还不够。
实验与证据
六个开放模型、40 个特定 HMM;序列长 20,000 token,每种条件分析 10 条序列。结论来自作者实验,本站未复现。
开放情况与使用许可
已读取 PDF 正文的方法、控制、干预与局限,并检查相关附录说明;未核实作者实验代码,不因被测模型开放就把本研究标成开源。
LICENSE论文为 arXiv 非独占托管许可;实验代码许可未核实
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
我的判断:受控生成器让“内部状态应该是什么”成为事先可计算的问题,避免把任何容易解码的特征都解释成理解。
干预还区分了目标后验和任意扰动,使机制论证更具体:表示必须以有方向的方式影响后续预测。
反方 · 哪些结论还不够
序列内随机划分的位置具有时间相关性,应再做连续时间块留出和新序列迁移。否则漂亮的解码分数可能高估部署中读出内部状态的能力。
控制实验排除部分替代解释,无法排除全部等价特征。尤其是自然语言缺少可计算的“真实隐状态”,迁移这套方法需要重新定义目标。
综合判断
这是关于受控上下文学习的有价值机制证据;它既不证明模型具有人的信念,也不证明自然语言推理普遍接近最优。
我会先做的验证
建议实验,尚未执行:固定探针跨新序列测试,再逐步增加状态数、熵与生成规则切换;同时报告预测误差、跨序列解码和干预效果,保留失败案例,而不是只挑清晰几何。