AKV:保留对话记录,只裁剪正在注意的 KV
智能体缓存成为可编程状态,服务端必须记住缓存操作的先后顺序。
AKV 将智能体的完整文字历史与活跃 KV 缓存分开:保留消息,删除较早工具结果的 KV,再复用仍在缓存中的状态。它同时提供策略接口与 SGLang 服务实现,减少重新预填充的成本。关键难点是缓存携带过去上下文,同样的剩余文本并不对应同样的 KV。
图解主要方法
智能体缓存成为可编程状态,服务端必须记住缓存操作的先后顺序。
- 1
1 · 文字历史与注意力状态分开
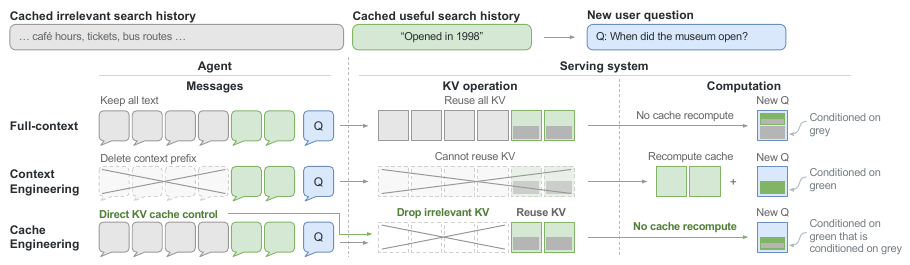
图1对比三条路径:全上下文保留全部KV;传统上下文裁剪删除文字并重算;AKV只删除部分KV,保留后缀已有状态。保留状态可能已吸收被删信息,因此drop不是语义遗忘或隐私删除。简单策略保留assistant消息与最近12轮工具结果。
- 2
2 · 用 append、drop、repos 操作缓存
append追加新状态,drop排除指定KV,repos压紧位置;RoPE键按新旧位置差旋转,值保持不变。这样节省位置空间和重算,但保留向量仍受其生成时上下文影响,不等于把裁剪后文字重新送模型。
- 3
3 · 服务端按操作历史分支
如果先删除A再生成C,和先生成C再删A,最终虽然都只剩B、C,C的状态也不同。扩展radix tree把缓存操作放进路径,结合请求隔离、按删除状态淘汰及位置版本,避免仅按文本前缀错误共享。
- 4
4 · 缺失缓存分段恢复
段式批处理在不同注意力可见范围下重建各段,每层尽量共用一次前馈计算;无状态请求仍提交完整消息与操作记录。收益依赖后端正确恢复历史操作,不只是客户端少发几个token。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据三个模型、四类智能体基准中,作者汇总平均分提高1.7点,API等价成本降低27.7%;GPT-OSS-120B平均分51.0到53.1,等价成本11.2到7.3美分。 跨模型任务表 ↗
我的解读这里是按token价格换算的成本,不是实际账单;MiniMax的SWE结果75.2到74.4等退步也必须保留。
来源证据8张A800 80GB,BF16权重,预填充和解码各TP4;回放80条最长SWE轨迹。峰值AKV并发14输出369 token/s,对照并发12为313,P95延迟28.49秒对43.16秒。 系统吞吐实验及附录 ↗
我的解读峰值比较不是相同并发;录制工具输出、固定生成长度的回放不能代替完整在线智能体。论文另有前100项SWE三次在线验证。
来源证据BCP中只drop为55,配合repos为62;删除推理轨迹更差。缓存作为工具的变体分数64对56,但成本5.9对5.4更高。 策略消融 ↗
我的解读缓存管理是质量与成本选择;模型自己管理不自动意味着更便宜。
开放情况与使用许可
已核查 thu-nics/AKV 的 agent策略与system实现、README及 Apache-2.0 LICENSE,非空仓库;底座权重分别遵循原模型许可,本工作主要开放缓存系统,不另宣称发布新基础模型。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
服务系统与智能体策略共同设计,使长任务避免反复摘要和预填充;操作历史依赖的分析尤其有工程价值。
反方 · 哪些结论还不够
不能把drop当作信息擦除。当前未覆盖线性注意力,重新定位存在数值误差;主要吞吐结果来自筛选的长轨迹回放,高并发还有完成数量截断,跨模型平均数会掩盖任务退步。
综合判断
值得作为长工具链的缓存后端试验,但需要端到端质量与缓存恢复正确性共同验收。
我会先做的验证
未执行的验证方案:用真实工具延迟和相同并发,比较全上下文、摘要、AKV;插入必须回查旧证据的任务,并强制缓存淘汰与重启,核对恢复后的输出、成功率、P95及实际GPU秒。