CausGround:先检索动作前提,再让机器人规划
怎样把交互经验变成“门未开就取不出物品”的可用知识?
CausGround 从受控交互中整理动作前提与效果,再把它们接到视觉语言规划器。相比只检索语义相似经验,反向追踪目标需要哪些前置动作更有效;但主证据来自模拟器的高层技能规划。
图解主要方法
怎样把交互经验变成“门未开就取不出物品”的可用知识?
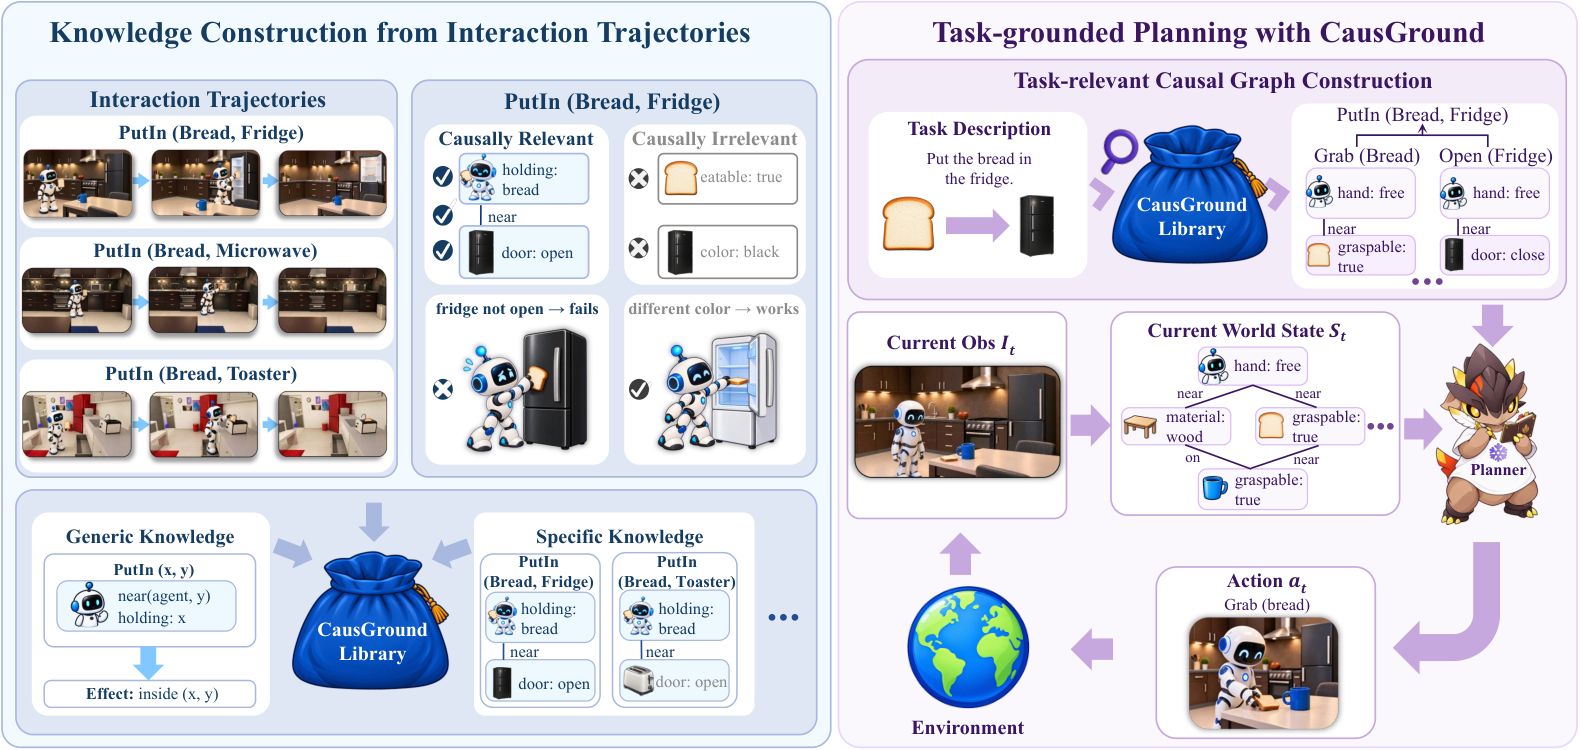
- 1
图2左侧:状态分解后积累交互规则
冻结MLLM从图像提取对象属性和类型化关系,交互前后状态共享同一套表示。通过变化条件、检查稳定效果区分一般动作知识与实例特定知识;这不是无隐藏混杂条件下的因果发现证明。
- 2
目标向后找前提,再补语义检索
从目标效果倒推可实现它的动作及所需前提,再与语义检索结果合并。知识集合在任务开始时构建一次,不应描述为每个动作后都重新建立整套因果图。
- 3
图2右侧:状态持续更新,规划器使用检索知识
执行后读取新图像并更新因子化状态,把当前状态和相关知识交给冻结规划器。RoboCasa使用高层技能接口,真实双臂示例由现成低层控制器执行,方法不直接学习关节控制。
实验与证据
已阅读全文正文与附录D消融、E真实部署,核对实验条件与原图;未独立复现。
来源证据三个Qwen骨干在VirtualHome平均成功率24.9%到53.3%;27B消融中基线33.3、仅状态36.0、仅知识53.3、二者62.7。9B语义检索18.7%,因果检索42.7%,合并44.0%。 正文主表与附录D ↗
我的解读收益主要来自前提—效果结构,状态表示有补充贡献;不能把所有提升归于更强视觉识别。
来源证据RoboCasa重规划平均43%到57%,但27B单次规划27.9%不变;SWITCH四类任务25.8%到31.9%。附录E展示微波炉取面包和多物体搬运。 跨环境与真实示例 ↗
我的解读真实实验是两项示例,未给出足够试验次数和成功率;不能推出家庭机器人泛化已解决。
开放情况与使用许可
项目页与论文已公开;本次项目页未提供可核实的官方代码或模型下载链接,不称开源。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
将隐含常识转成可以检查的动作前提,有利于定位“计划看似合理但无法执行”的错误。
反方 · 哪些结论还不够
VirtualHome图像经过AI修复,感知分布与真实家庭不同;知识建库覆盖、识别错误和未见动作都可能成为瓶颈,高层成功不等于低层执行可靠。
综合判断
较有说服力的是模拟规划中的结构化检索收益,实机通用性仍待定量验证。
我会先做的验证
未执行的验证方案:固定低层技能和任务,分别注入漏检对象、错误前提与新物体,比较语义检索、因果检索和二者组合的恢复率及调用成本。