LOWN:扩散视觉语言模型何时可以暂时不看图
文本预测与旧视觉锚点一致,是否足以省下一次昂贵视觉前向?
LOWN 在扩散解码中先运行便宜的纯文本前向,用它与最近一次看图所得预测的一致性决定是否再次读取视觉 token。它不训练新参数,但所谓 certificate 是可出错的一致性判据,并非答案正确性的形式证明。
图解主要方法
文本预测与旧视觉锚点一致,是否足以省下一次昂贵视觉前向?
- 1
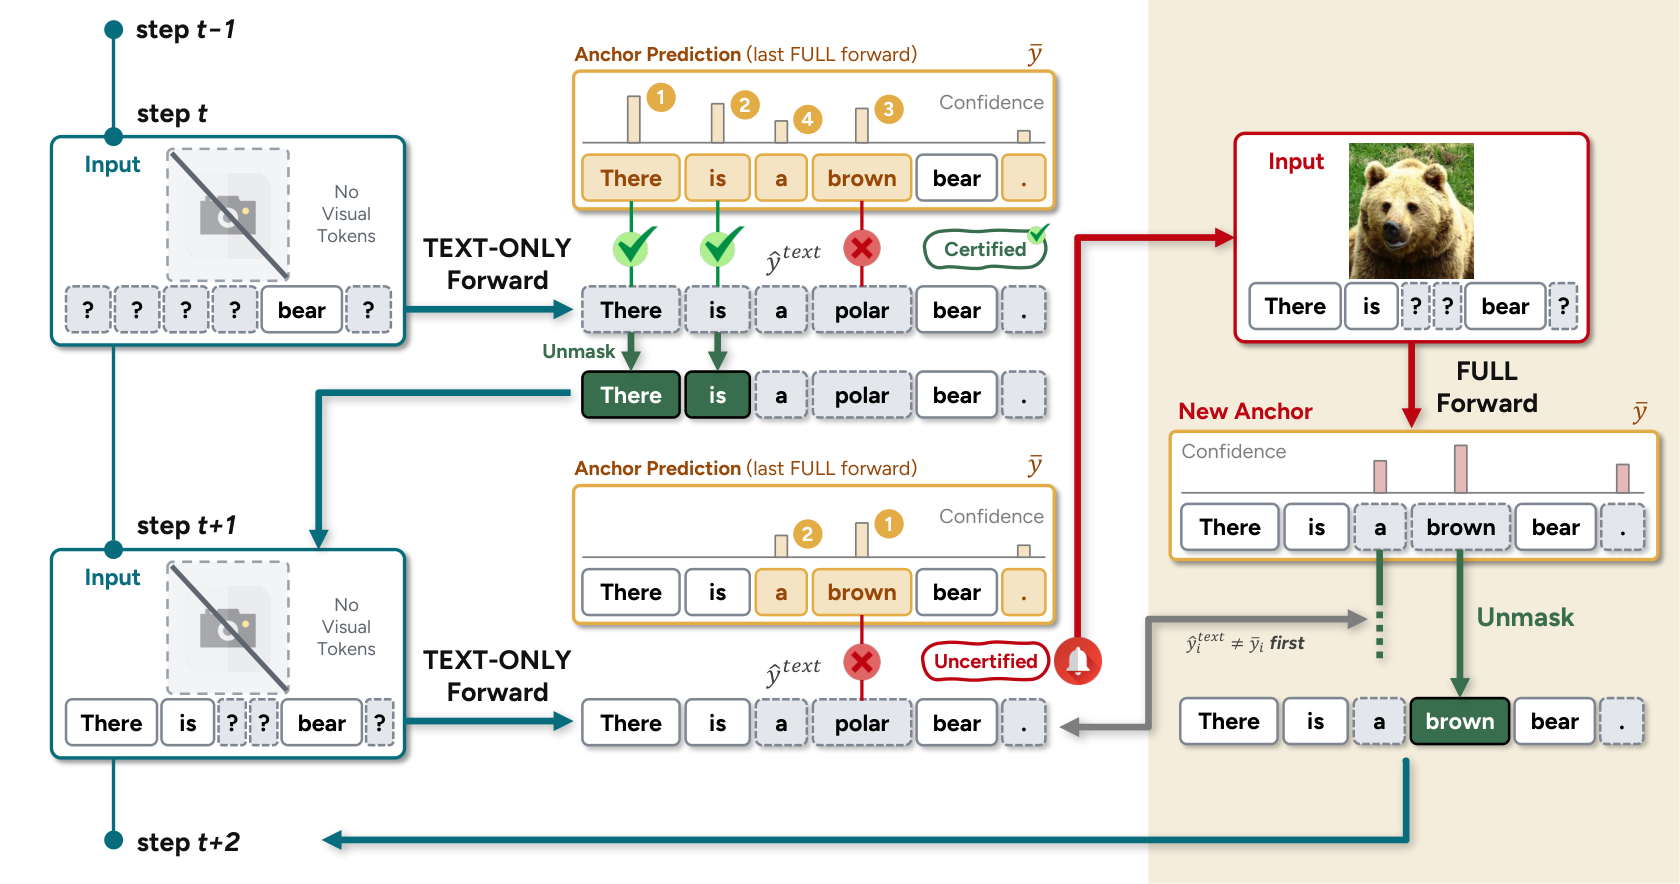
图3:保存最近一次看图的锚点
FULL 前向记录剩余掩码位置的最高概率token与置信度。下一步去掉视觉embedding但保留文本位置编号,运行TEXT-ONLY;图像只编码一次,省掉的是后续语言解码层处理视觉token的成本。
- 2
只接收连续通过的一段候选
按旧视觉置信度排列仍被掩码的位置。当前文本预测等于锚点才通过,第一个不一致就结束前缀,并配合重复保护。它同时近似检查视觉依赖和旧预测是否过时,两者都不是严格保证。
- 3
不够一个基本步长就重新看图
若通过的前缀长度达到基线每步解掩码数量k,一次接受整个前缀;否则运行FULL刷新全部锚点,优先接受视觉与文本意见不同的k个位置。每步至少推进k,所以不会比基线步数更多,但每步成本仍由输入决定。
- 4
与视觉剪枝、缓存分别组合
视觉剪枝缩短每次FULL,LOWN减少FULL次数,两者可以叠加;缓存进一步改变每次前向成本。图中绿色一致只表示token相同,不代表没有视觉幻觉。
实验与证据
已阅读正文及解码、评估、可靠性相关附录,核对实验条件与原图;未独立复现。
来源证据LLaDA-V十项任务,batch1、贪心、无KV缓存、相同提示和输出预算,平均保留99.6%基线分数、用0.353倍解码FLOPs;把高于基线的分项封顶后保留98.6%。 表1与实现协议 ↗
我的解读平均值会用某些任务上涨抵消其他下降;分析FLOPs不包含完整服务开销,不能直接称端到端节省64.7%。
来源证据与Fast-dLLM组合在三个任务进一步省38.1–50.1%生成时间,但三个任务均低于Fast-dLLM质量,其中LLaVA-Bench下降5分;独立LOWN十任务平均生成时延下降57.4%。 表2与时间实验 ↗
我的解读组合加速并非无损;部署应按任务质量底线选取而非只看速度。
来源证据自身运行中被纯文本步骤接受的token仍有2.2–4.7%被新FULL预测推翻;基线轨迹中八步旧锚点在DocVQA错误一致率达25.3%。 §5.3 / 附录F:判据失效 ↗
我的解读动态刷新能减轻锚点陈旧,却不能把经验一致性变成可靠性证书。
开放情况与使用许可
官方GitHub存在lown.py、演示与评估入口,不是空仓库;未发现根目录统一LICENSE,内含上游llava许可不能替代新增代码授权。没有需要额外训练的专属权重。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
把“看图频率”从固定规则变成逐步决策,为不永久删除视觉细节的加速提供了路线。
反方 · 哪些结论还不够
仅测试若干扩散VLM,图表和文档任务收益较少;相同token不保证正确,延迟和显存依硬件实现而变。
综合判断
适合允许小幅质量损失的扩散解码试验,不能用于需要零差错承诺的视觉核验。
我会先做的验证
未执行的验证方案:在同硬件、相同输出长度下测文档小字与图表数字,逐token对照新FULL;报告最差任务退化、锚点年龄、P50/P95端到端延迟及缓存内存。