CFM 策略蒸馏:把多个专家的速度场合成一个策略
真实动作锚点与教师引导必须同时保留
研究先为各任务训练流匹配专家,再让一个学生同时学习专家速度场与真实演示动作。它在八项 RLBench 任务上超过直接混合数据训练,但训练仍需多个专家,单一任务也可能退步。
图解主要方法
图 1 中的专家监督为什么不能替代真实动作锚点?
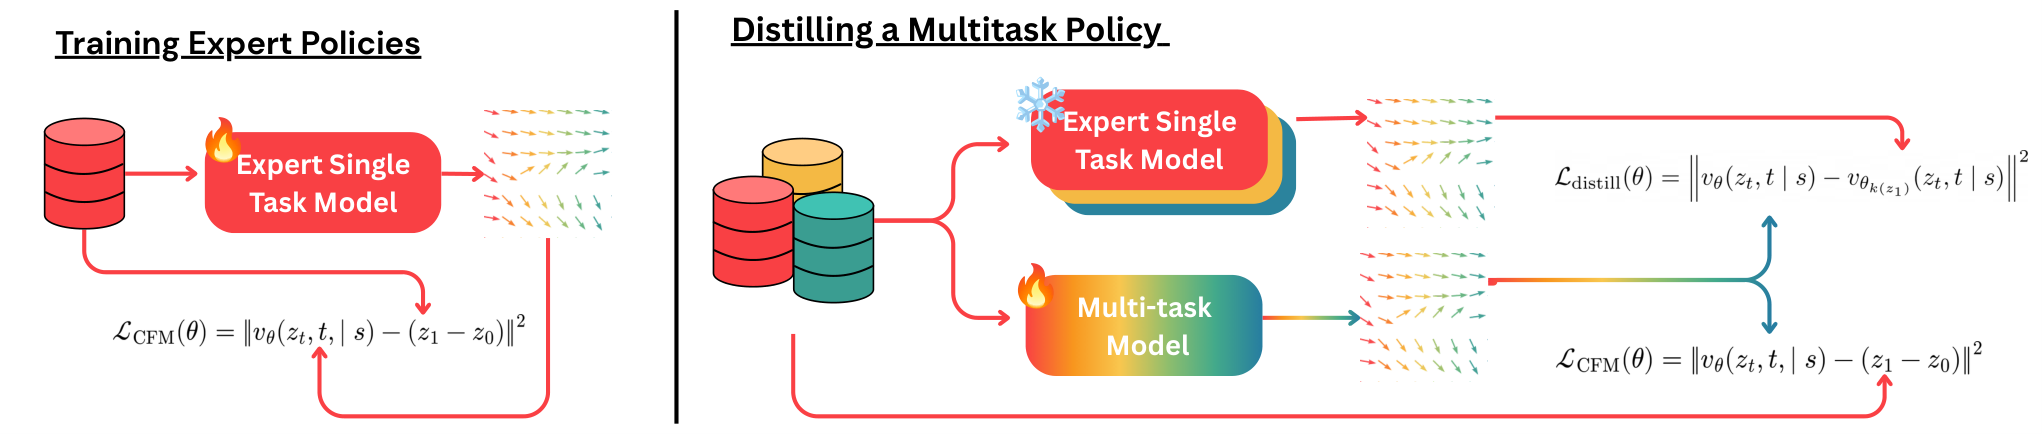
- 1
从点云与状态生成动作块
使用不含 T-Net 的 PointNet 编码点云,与机器人本体状态一起进入一维 U-Net。每个任务先用 100 条演示训练一个 PointFlowMatch 专家,学生再在所有任务的联合数据上训练。
- 2
在同一流时间读取教师速度
令 z_t=(1−t)ε+t a,ε 是高斯噪声、a 是真实动作;基本速度目标为 a−ε。对当前任务调用对应专家,得到同一 z_t、t 下的速度场。这里 t 是去噪进度,不是机器人真实执行时间。
- 3
把两类目标按固定比例组合
损失用 λ=0.5 平衡真实速度与教师速度,不随流时间改变。专家提供平滑的任务结构,真实动作防止学生只模仿教师偏差;先从专家采样再当训练目标是另一种对照,并不等价。
- 4
部署只保留学生,训练仍付专家成本
推理无需专家集合或显式任务 ID,以观察区分任务。但相同场景中用户可能有不同意图,单靠观察无法消除歧义;论文没有证明任意语言任务条件下的多技能选择。
实验与证据
以下为作者报告;已阅读 v1 全文及可用附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【八项 RLBench,每任务 100 次评估】专家平均 64.4%,直接联合训练 61.4%,完整蒸馏 79.5%;仅专家采样增广为 70.0%。 表 1 ↗
我的解读我的解读:结合真实轨迹和教师速度有收益;全部来自仿真,没有同规模真机成功率证据。
来源证据【反例】Open Box 专家 99%,直接联合 97%,完整方法 83%;Open Fridge 则从专家 46% 提至 77%。 表 1 ↗
我的解读我的解读:平均收益掩盖任务冲突,需要按任务而不是只按均值选择部署模型。
来源证据【权重与容量】λ=0.25/0.5/0.75/1 的均值 69/79.5/68/65.4;扩到 16 个任务时增大学生有帮助。 消融与任务数实验 ↗
我的解读我的解读:全靠教师并非最佳,固定学生容量也会饱和;蒸馏不是无上限合并技能。
开放情况与使用许可
全文与附录已读;未确认独立代码、专家权重或学生检查点下载入口,引用的 PointFlowMatch 不能代替本工作发布。
LICENSE代码与权重许可待确认。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
在相同噪声位置对齐速度场,再以真实动作约束终点,提供了可检查的多专家合并机制。
反方 · 哪些结论还不够
缺少真机、同观察不同意图及完整训练成本比较,且部分任务退步。
综合判断
适合观察足以区分任务的紧凑多技能策略;评价应包括最差任务与训练专家的总成本。
我会先做的验证
未执行的验证方案:在相同学生容量和总 GPU 小时下比较联合训练、速度蒸馏和样本蒸馏;加入同场景不同目标条件,并逐任务报告多种子成功率。