ClawLoop:把失败诊断接回智能体训练数据生产
没有外部教师,代理如何生成可验证、又处于自身能力边界的练习?
ClawLoop让同一27B模型构造工作区任务、执行并验证轨迹、训练自身,再用保留任务上的失败诊断指导下一轮出题。它把能力模板和领域工具图两条合成路线接成三轮循环;结果支持这套课程的价值,但小模型只是消费27B课程,并未自己完成闭环。
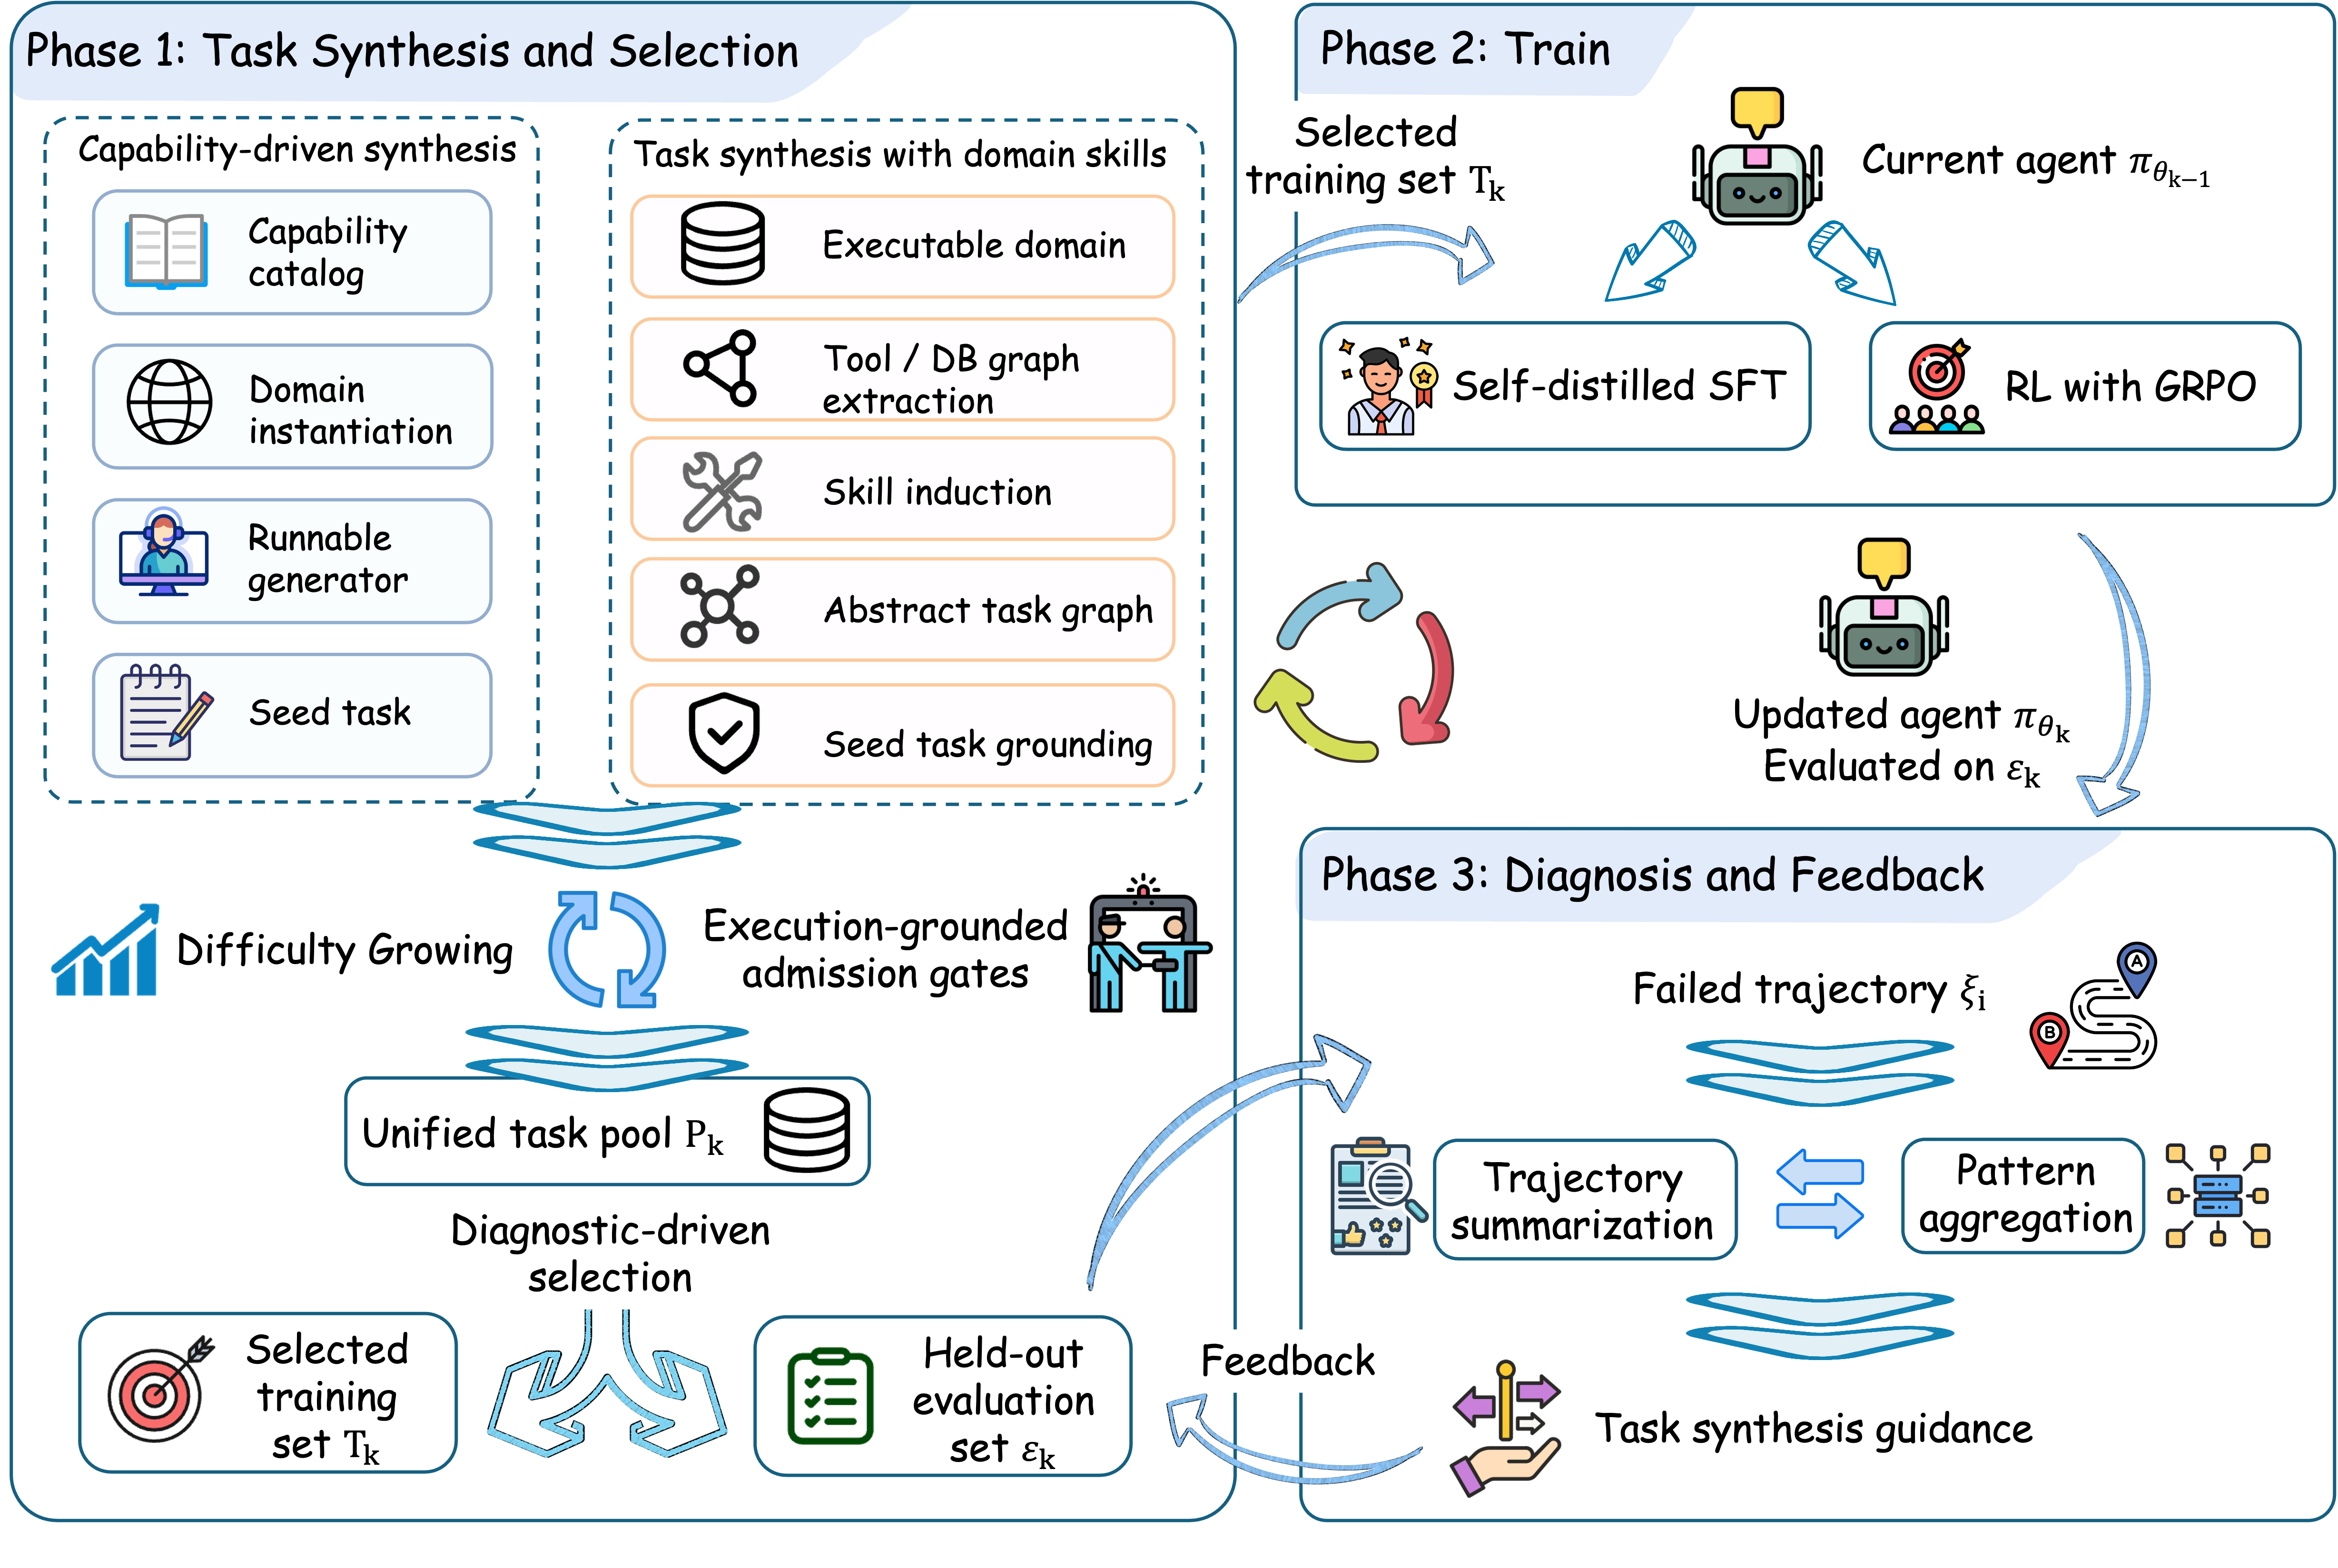
图解主要方法
没有外部教师,代理如何生成可验证、又处于自身能力边界的练习?
- 1
双路线生成可执行任务
能力路线让模型写带种子的生成程序,执行得到多源数据、答案与契约,避免直接相信模型口述答案;领域路线从工具、字段和数据库三部图归纳技能,再把抽象依赖图落到具体业务。契约显式声明舍入、筛选与并列规则。
- 2
增加难度并校验可解性
多跳任务强制连接索引、实体文件和交叉参考;脏数据扰动不改变明确的解。先检查参考解、验证器和答案泄漏,再对每题采样8次,仅保留成功1至5次的任务。全对与全错都缺少GRPO组内对比信号。
- 3
复用轨迹做SFT与GRPO
成功轨迹用于SFT,仅对代理动作token计算损失,屏蔽文件和工具观察;同组轨迹用结果奖励计算相对优势做GRPO。训练配置为SFT三epoch、GRPO一epoch、最长65536token。
- 4
用保留集合失败更新课程
训练后的策略只在合成保留任务上总结失败位置、根因和缺失能力,聚合后调整下一轮任务;外部三项评测不参与出题或难度调度。图1的反馈箭头指向下一轮合成,不是直接把外部测试答案加入训练。
实验与证据
已阅读正文1–6与附录A–E,包括成本、算法、课程动态与完整案例,核对实验条件与原图;未独立复现。
来源证据SkillsBench平均五次成绩46.3→57.2,Claw-Eval-Live69.3→76.9,ClawGym-Bench67.6→68.4。 表1与附录A:27B三轮、每轮1024候选 ↗
我的解读第三项相对基础模型只增加0.8点,不能把相对较弱ClawGym的优势描述成三项都大幅提高;正文未报告完整置信区间。
来源证据4B Claw-Eval-Live32.4→48.0,9B58.3→71.7;ClawGym对照用SFT,本方法小模型主要用RL。 表2与附录C:4B、9B课程迁移 ↗
我的解读数据来源和训练算法同时变化,不能仅由这张表断定数据质量的独立贡献;小模型未运行自己的诊断闭环。
来源证据每轮74.23小时、2375 GPU小时,其中验证轨迹30.76小时;环境无外网,32并发容器,单轨迹最多300轮或24小时。 附录A表4:32张H800 ↗
我的解读无外部教师并不等于低成本,也不是具有任意互联网依赖的真实工作流。三轮训练的总算力需要单独预算。
来源证据准入率65.6%、45.8%、55.4%,平均轮数5.6、11.4、8.7;困难案例推理token67994,简单案例4067,二者不是同题受控对照。 附录D–E:课程动态与案例 ↗
我的解读难度增长会过冲;附录把更难说成超过成功次数上界,语义与筛选公式不一致。案例token数也需与65536序列上限核对,不能宣称实现细节完全可复现。
开放情况与使用许可
论文CC BY 4.0;全文未提供可核实的ClawLoop实现、训练数据与检查点发布入口,相关基准链接不代表本方法代码开放。
LICENSECC BY 4.0
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
把可执行答案契约、任务准入和保留集诊断串成可审计闭环,比只展示自生成任务的数量更有信息量。
反方 · 哪些结论还不够
循环模型只有一个规模,三轮后两项趋于饱和;验证器与生成器同源可能共享盲点。算法对SFT前采样轨迹的GRPO复用、长轨迹切分说明不足;小模型对照训练算法不一致。
综合判断
值得参考其课程与验证设计,但论文结果支持有限轮次和指定环境内改善,尚不足证明持续自我提升。
我会先做的验证
未执行的验证方案:固定总GPU小时和训练算法,对比双路线、无诊断与固定难度课程;独立审计验证器误判,保留真实外部任务并报告多种子区间及完整轨迹长度处理。