CoDA:用失败诊断组织机器人的训练课程
把场景生成、失败因素和奖励塑形放进可复用记忆。
随机增加场景不一定补上机器人的真正短板。CoDA 让语言模型根据执行失败提出难点假设,再生成目标变化与对照场景,并记住哪些变化确实造成困难。它在仿真中提高分布外泛化,同时暴露出更高的生成与训练成本。
图解主要方法
把场景生成、失败因素和奖励塑形放进可复用记忆。
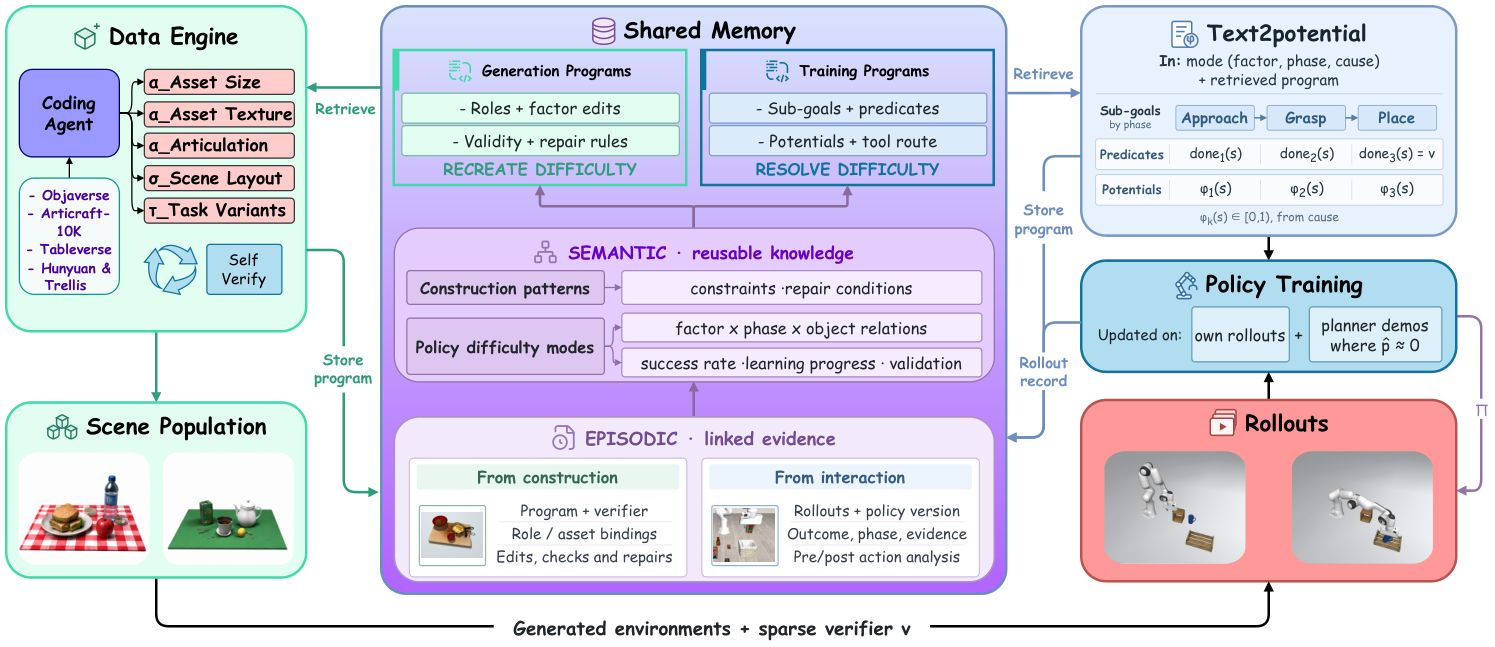
- 1
图1:三类记忆分开保存
情节记忆记录环境修复和执行轨迹;语义记忆把失败拆成任务、空间、属性与执行因素;程序记忆分别保存制造难度的生成器 Ω 和帮助学习的子目标及势函数 Φ。制造难例与解决难例不是同一个缓存。
- 2
用目标变化和对照检验诊断
GPT-5.5 评审轨迹后提出失败因素,只改变目标因素并尽量固定其他因素,比较目标与对照环境的 rollout。18.2%的诊断被反驳,说明环节确实过滤猜测,但控制变量并不保证所有隐藏混杂都消失。环境还需碰撞、稳定性与尺度校验。
- 3
按难度和学习进度选择课程
调度结合 UCB、难度与进步,偏向成功率0.2–0.8的环境,保留15%新颖和10%回放;覆盖不足或学习停滞触发下一轮生成。四类 Franka/MuJoCo 任务使用规划器示范和独立稀疏任务验证器。
- 4
用势函数提供训练信号
语言生成已完成子目标数与下一子目标的有界进度,按 β(γ^hΦ末−Φ初)塑形,β=0.5、γ=0.99,终止按规定处理。Q 网络在训练时评估8个候选动作块,优势加权更新 π0.5 LoRA,部署只需策略。势函数的理论不变性依赖固定、有界和正确终止处理,不保证实际学习达到最优。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据5轮、每类320个接受环境、1280条规划示范和2.5M token预算,三随机种子;分布外平均成功率由 SFT5.3%提升到27.6±0.5%,标量反馈18.1±0.5%,无记忆评审19.2±0.7%。 主实验:匹配环境预算 ↗
我的解读支持有结构诊断和记忆的组合有效。15轮达到42.1%使用更多预算,不能与5轮结果当作等成本对照。
来源证据稀疏奖励22.3%,Text2Potential27.6%;达到25%水平所需步骤约31k降到21k。记忆迁移到 OFT 后从3.8%到21.1%,不再生成环境。 塑形与迁移 ↗
我的解读迁移仍需策略训练,不能称为零样本能力转移;编译器检查函数能运行也不保证奖励始终有助任务。
来源证据LIBERO-Pro 30个源任务上,15轮后位置变化25%到84%、指令变化1%到76%;每1000个接受环境需约7.4M tokens、66 GPU小时,对照标量方案4.6M、51小时。 扩展与成本 ↗
我的解读环境数量相同不代表计算相同。对象变化仍有其他方法更强,不能泛化为所有 OOD 扰动全面领先。
开放情况与使用许可
论文可访问;论文所指 plan-lab.github.io/coda 本次返回404,未核实正式实现、数据和许可证,不标成已开源。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
将可反驳的失败假设、环境生成和长期记忆连接起来,使课程生成比仅“再生成一些难题”更可检查;部署不需要额外 Q 网络。
反方 · 哪些结论还不够
主要证据均为仿真,没有真实机器人验证;语言评审、场景修复与奖励生成有多重误差来源。增加环境和推理成本显著,因果诊断仍受因素表达和对照质量限制。
综合判断
更适合把它视为仿真训练数据与课程管理框架,而非已验证的通用自主机器人研究员。真实收益需用总计算和人工调试成本重新核算。
我会先做的验证
未执行的验证方案:固定总 token、GPU时长和接收环境数,做三种预算匹配;人工盲审接受与拒绝诊断,再把相同课程迁移到真实机器人,记录奖励投机和环境修复成本。