CogMem:把谁说的、何时有效和原始证据保存在长期记忆图中
观点与记录分型有助于多跳问答;归纳并不删除旧事件,也不能把自述自动变成已核实事实
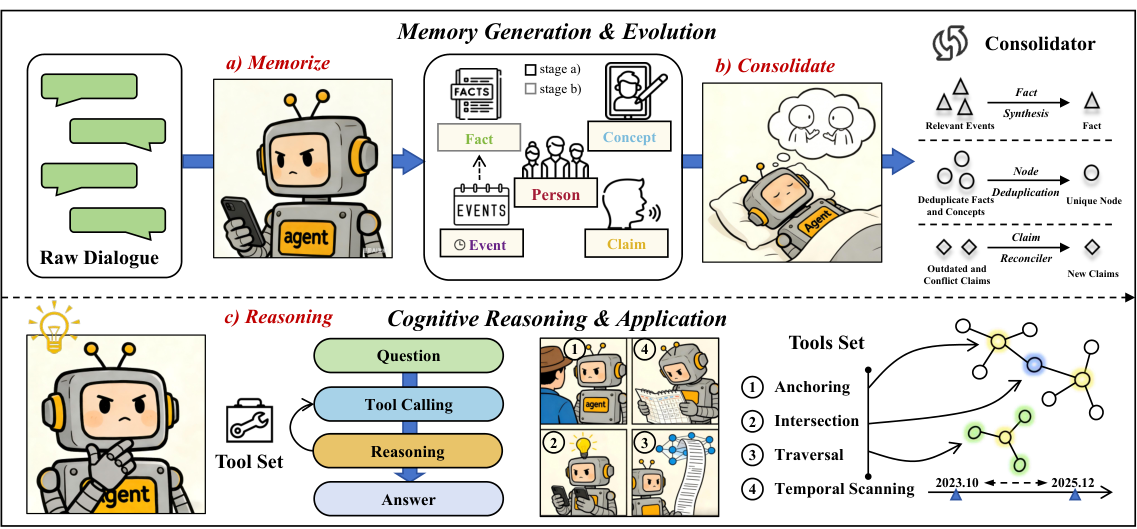
CogMem将对话拆为人物、事件、概念、观点和事实记录,保留来源与时间,再用受限图操作重建回答证据。它在LoCoMo多跳与LongMemEval更新问题上优于所列基线,但归纳增加存储,意图解析和类型限制也会漏证据。这里的Fact是一种记录类型,不是外部核验后的真相。
图解主要方法
怎样区分某人说过的看法、对话中的记录与随时间更新的状态,并按问题重建证据?
- 1
逐轮抽取五类带来源节点
将动作存Event,稳定自述或属性存Fact,关于他人的带来源表述存Claim,并规范化Person与Concept。所有记录保留轮次和时间;Claim显式连接说话者与对象,Fact不代表经外部核实。
- 2
离线归纳而不删除事件
同一人物—概念在30天内至少3事件时,用模型生成带时间包络的概括,并用SUPPORTED_BY连接全部原事件。概念与重复事实可合并,但事件保留,因此缩短推理路径不等于减少物理存储。
- 3
协调同一来源的时间更新
仅对规范化来源、目标、谓词均相同的观点排序,派生当前、已过时或冲突视图,保留原始记录;不同说话人的分歧不被合成共识。
- 4
规则控制器按模型意图选图操作
先用0.3词法与0.7向量混合定位锚点,再按比较、观点、时间或核验意图调用交集、遍历或原文取证。图操作与高层分支是确定规则,意图和证据是否充足由模型判断;最多5次定位后调用。
- 5
从限定证据回答并保留核验路径
主配置15锚点、每跳最多15邻居、遍历深度2。可早停,但这也可能跳过原文核验;图2将第四项画为时间扫描,正文四算子则将时间过滤纳入遍历,另列证据取回,按正文实现口径解释。
实验与证据
阅读全文75727字符及附录A–H,核对图2、公开实现树、README、MIT许可和首发记录。
来源证据LoCoMo十段长对话、1542题;Qwen多跳F1为48.42,对GAM42.96和RoG41.80。 表3;A、B、E ↗
我的解读F1/BLEU-1是词级重叠,不直接等于推理正确率;类别结果应分别看,敏感性表使用加权整体分而非这项多跳分。
来源证据LongMemEval整体GPT骨干68.40%,Qwen66.50%;更新子项Qwen73.08%。 表4–5;H.5 ↗
我的解读整体与更新子项分母不同,评分依LLM裁判;更新规则允许回答同时提旧值,只要含所需新值,不能据此认定过时信息完全消失。
来源证据150合成事实—观点对:平均嵌入相似度0.8231,错误归属64/150→9/150。 表1;G.2 ↗
我的解读支持类型约束对构造混淆有用,但未验证自然对话抽取错误的同等收益,类型过滤也可能排除有用观点证据。
来源证据Qwen消融:去归纳43.56多跳F1、去Claim41.20、固定流22.81,对完整48.42。 表5、11;C ↗
我的解读固定流为锚定、两跳、取证三步,不含交集和适应选择;其整体19.7对57.0属于另一指标,不能混写成多跳分。
来源证据归纳节点3641→4181,边9935→14643;多跳工具次数3.42→2.67。 表6、12;D ↗
我的解读节点增加14.8%、边增加47.4%,换取语义捷径;保存原文不能防止生成概括时丢失关键限定词。
来源证据Qwen构建共1578.2k骨干token、1216调用;问答平均6610 token/题。 表14;E ↗
我的解读建库略低于所列A-MEM和Mem0,不代表总计算统一公平;LightMem另有压缩模型未纳入此token表,在线仍高于单次检索。
来源证据主文和README锚点K=15;敏感性表K=15得56.55,K=18得57.04,并将57.04用于多项完整配置。 表2、7–10;README ↗
我的解读存在需复现澄清的参数口径,不能直接将敏感性最优分当主文同一运行;文中没有给出这差异的明确原因。
来源证据50题盲评对GAM胜68%、平20%、负12%,两主标注员来自作者机构;100错误例每类25。 A.5;G ↗
我的解读偏好样本与人员背景有限;时间归一化44%是25个时间错误例中的占比,不是全体时间问题错误率。
开放情况与使用许可
公开仓库含图存储、索引、观点协调、归纳、检索代理、评测脚本与测试,采用MIT。README仍注明预发布分支,不应称已完成归档正式发行;基准数据单独获取,无新训练模型权重。
LICENSE代码MIT;基准与依赖模型遵循各自许可。论文arXiv非独占托管许可,图2注明来源用于方法评论。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
不同说话人的观点不合并,同一来源的冲突更新以派生视图保留原节点,设计直接针对归属和时间混淆。
去观点类型使更新准确率73.08%降至56.67%,去归纳使多跳F1下降4.86点,支持两种机制具有互补作用。
公开构建、检索与评测实现,并报告存储增长和具体失败,不把图结构视为无误记忆。
反方 · 哪些结论还不够
去代理的固定流程同时失去交集与自适应工具选择,巨大差距不能单独归因于自由推理或迭代次数。
上下文上限和回答提示统一,但中间工具与检索预算未严格匹配;RoG仅零样本迁移,不能否定充分微调的图路径学习。
有效期、事实类型和来源都是模型抽取结果;时间归一化仍出错,来源边存在也不保证被实际访问。
综合判断
有用的可追溯记忆架构:将归属、时效和证据作为数据结构的一部分,比只增加上下文更便于审计;当前证据仍不足以证明连续部署或多语言环境中的稳定可靠性。
我会先做的验证
建议实验(尚未执行):固定token与检索预算,加入保留相同工具的确定性自适应基线;用跨语言真实更新、删除和恶意记忆输入测试,并逐项核验事实类型、相对日期、来源回溯率及15/18锚点配置差异。