Cola2:让连续潜变量负责语义,再把生成结果写回上下文
压缩token后,如何避免潜变量提案与最终文字逐渐失配?
Cola2把语义压缩、连续潜变量生成与离散文本解码拆开训练,并在每个生成块结束后重新编码实际文字。论文的重要边界是:压缩率降低不等于整体计算或延迟同比下降。
图解主要方法
压缩token后,如何避免潜变量提案与最终文字逐渐失配?
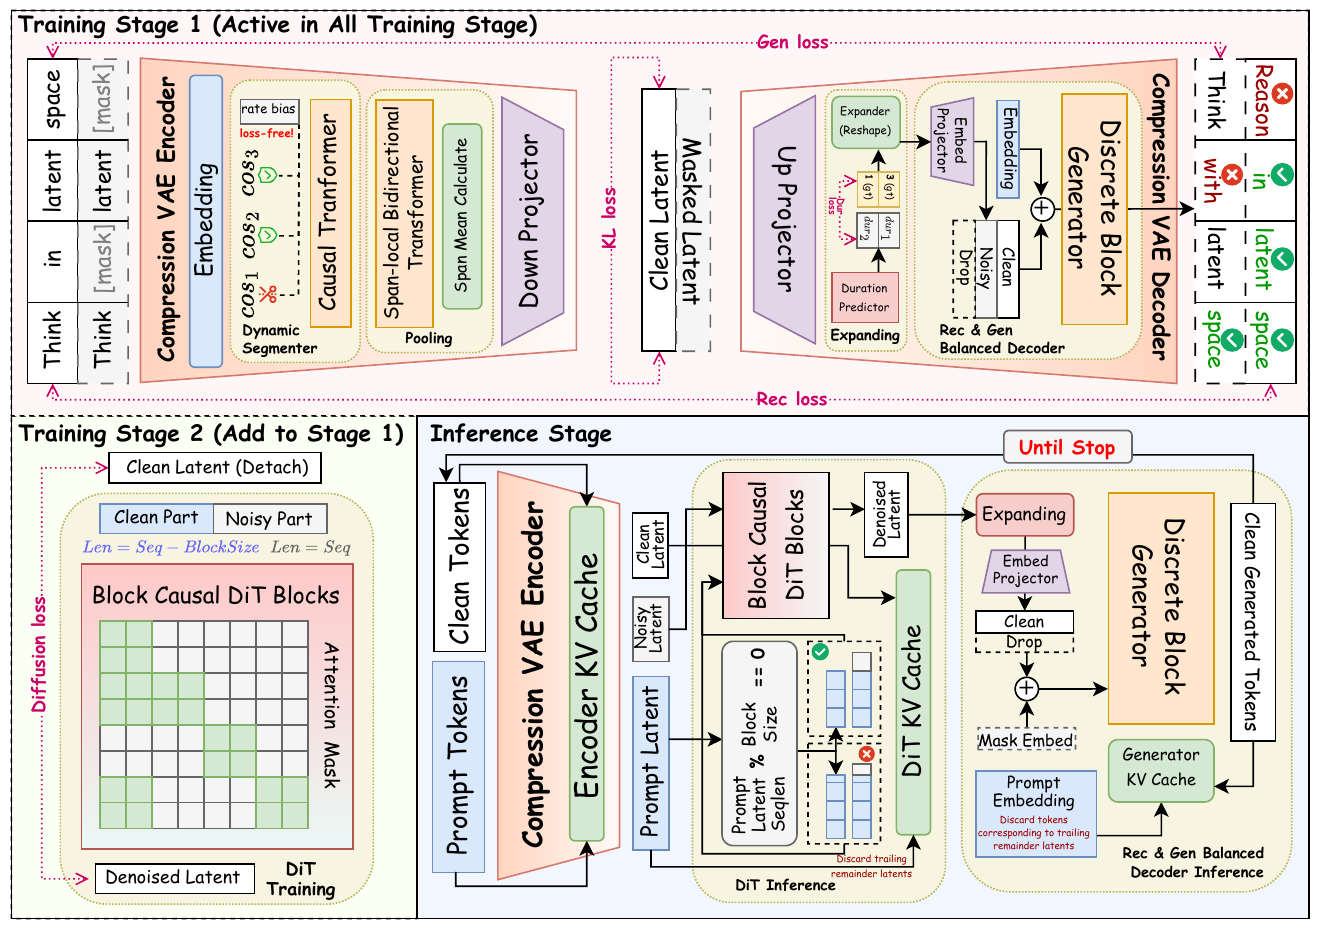
- 1
图1上半部:按语义边界分配潜变量
相邻表示相似度与动态偏置决定span边界,偏置通过反馈接近目标压缩率;span内双向汇聚、潜变量间因果编码,形成带KL约束的连续表示。时长头负责预测每个潜变量应展开多少token。
- 2
图1训练部分:避免只会复制输入
解码器接收干净、加噪或丢弃的潜变量;额外遮住编码器中的span,要求从剩余上下文预测缺失内容。连续DiT读取detach后的潜变量,扩散损失不回传编码器,但token目标仍可更新表示。
- 3
图1右下:提案—解码—反馈—提交
块因果DiT先采样潜变量,再由离散生成器落为文字;固定原span重新编码已生成token,把修正后的潜变量写入持久KV,而非保存未落地的提案,降低下一块条件失配。
- 4
区分受控实验与最终大模型配方
最终检查点借用Qwen3-4B解码器和嵌入,经历52.43B、125.83B、167.77B来源token三个阶段;第三阶段冻结EMA编码器,仅继续训练DiT。不能把该配方与从零训练的小模型消融混为一谈。
实验与证据
已阅读正文与方法、实验相关附录,核对实验条件与原图;未独立复现。
来源证据固定压缩率下,动态分段的平均任务分数25.0,高于固定分段16.8与随机分段20.6;生成式表示监督也带来提升。 §4 受控消融 ↗
我的解读支持边界位置和监督目标的重要性,尚不能归结为单纯减少序列长度。
来源证据最终模型处理346.03B来源token,八任务平均60.10;Llama对照66.25、Qwen3-8B为75.87。 Table 4、Appendix I ↗
我的解读模型继承预训练解码器,来源token不等于全部历史训练成本,不能宣称从零训练的数据效率提高数十倍。
来源证据计算核算包含DiT多步去噪、离散解码、CFG、重编码及缓存提交;token轴缓存仍然存在。 Appendix H ↗
我的解读论文明确区分理想并行调用轮数、FLOPs、显存与真实延迟,尚缺统一硬件的端到端速度证明。
开放情况与使用许可
核对论文及作者项目页;本次未在项目页发现可核验的代码或权重下载入口,不将论文公开称为实现开源。
LICENSECC BY 4.0
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
实际文字反馈能修复连续计划与离散实现的偏差,提供比简单压缩更可解释的研究方向。
反方 · 哪些结论还不够
分段、时长预测、双重缓存和CFG都增加复杂度;不同模块的初始化与额外计算妨碍直接与AR模型比较。
综合判断
方法链与消融有价值,性能和效率结论应限制在报告的任务与核算范围。
我会先做的验证
未执行的验证方案:固定质量目标和硬件,逐项计时提案、解码、重编码与缓存提交,比较固定span/动态span、是否反馈的长文本漂移。