语言通信瓶颈:模型说对了,另一个模型能还原吗
用表达式往返实验拆开生成、理解和共享协议
作者把算术表达式交给一个模型写成英语,再让另一个模型恢复表达式,用符号等价检查信息是否保住。自然语言的歧义会造成角色相关的错误;结构化协议和微调有帮助,但论文的生成端故障归因仍只是模型面板启发式。
图解主要方法
图 1 的往返通道如何隔离传达损失,为什么角色交换不是等价实验?
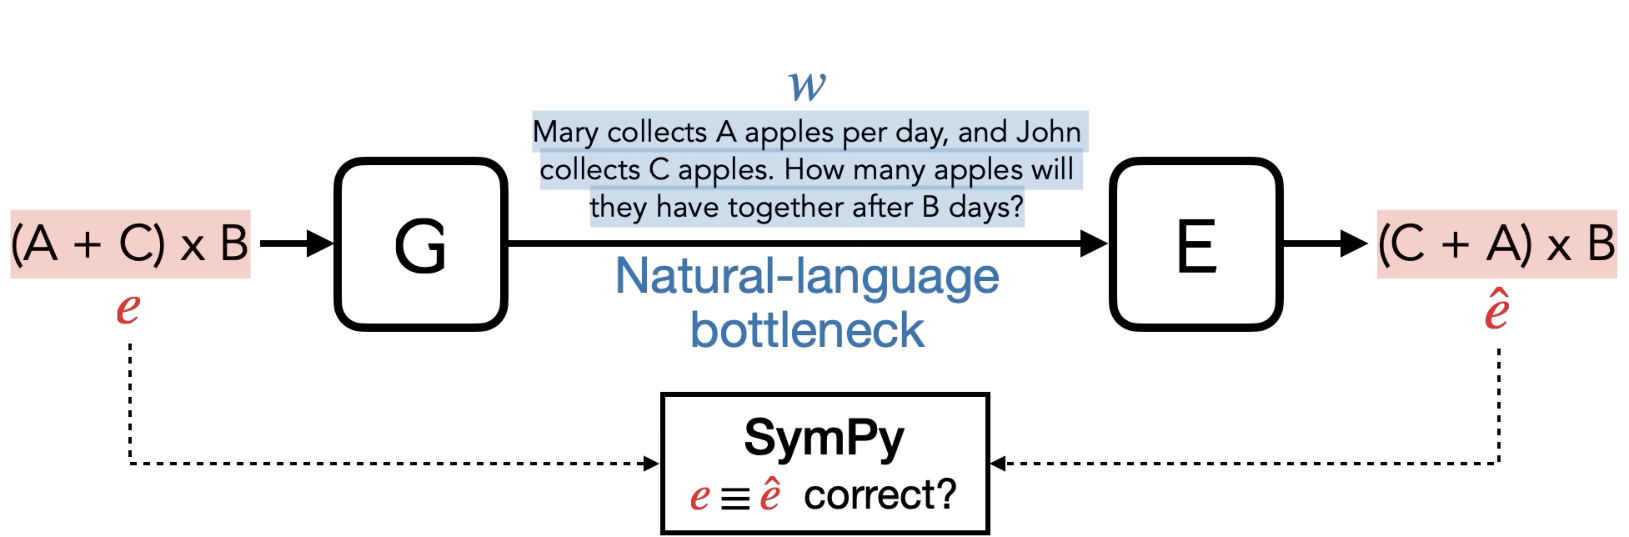
- 1
从受控表达式生成任务
枚举二叉树骨架,填入四则运算、A–H 变量和整数,去掉退化表达式,共 2450 项、2–8 个运算和深度 2–6。树的分支方向会改变描述难度,输入本身不依赖自然语言真值标注。
- 2
限制生成端只交付自然语言
生成模型用两三句英语解释计算,不能直接粘贴公式;提取端只看这段文字。温度为 0、关闭思考;生成零样本、提取三样本,16×16 配对矩阵包含格式违规的零分项,角色能力不能互换。
- 3
用符号等价检查任务信息,而非字符串相同
SymPy 检查恢复表达式和原表达式的代数等价性。因此等价变形可以通过,不要求恢复同一棵树;这测的是算术意义保留,而不是精确语法序列传输。
- 4
区分可测失真和推断出的责任
如果面板上没有提取器恢复成功,作者把失败归向生成端;有提取器能成功则说明文字可能包含足够信息。但所有提取器可能共享盲点,独立错误假设并不保证成立;附录中的清楚描述也出现全体提取失败,不能把该归因当成人类裁定。
- 5
用结构化通道和微调检查可修复性
对照 JSON、S-expression 等格式;Qwen 14B/32B 的结构化表达明显优于自然语言。QLoRA 用约 3600 条合成消息训练三轮,还测不同元数的装配任务。算术微调测试仍共享运算和树形分布,不能称为完全分布外泛化。
实验与证据
以下为作者报告;已阅读 v1 全文及附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【完整矩阵】GPT-5 生成、Gemini-3.1-Pro 提取为 92.9%;反向 88.5%,GPT-5 自身往返 91.3%。 主要往返矩阵 ↗
我的解读生成和理解有不同强弱,不能只凭自测成绩挑多智能体搭档;不同面板的行均值也不能横比。
来源证据【结构化对照】Qwen 14B/32B 的 JSON/S-expression 约 85–88%,自然语言约 51–70%。 格式对照实验 ↗
我的解读语义明确、解析友好的接口具有实际价值;但小模型也会被陌生结构格式拖累。
来源证据【微调】十模型面板上微调生成端约 51.9–59.5%,该面板未训练 Gemini 基线 45.1%;装配转移仍存在 12.4 个百分点的落后案例。 微调与装配附录 ↗
我的解读改善有任务与模型边界,不能把同分布训练收益写成任意协作能力提升。
来源证据【失误归因】启发式将汇总失败的 73.6% 归给生成端。 失败归因与附录 L ↗
我的解读该比例依赖面板覆盖及错误相关性,是诊断线索,不是已证明的语言表达责任比例。
开放情况与使用许可
论文说明代码拟在录用后发布;此次未确认作者正式实现,不按已开源处理。
LICENSE论文 CC BY 4.0;尚未核实软件许可。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
受控输入和机械等价判定避免把评委偏好混进通信成功率,跨模型矩阵也暴露了配对差异。
反方 · 哪些结论还不够
英语短消息与符号任务离开放式协作仍远;模型共同失败不证明原消息不含答案,故责任分配应谨慎。
综合判断
工程上值得先尝试共享结构化协议;研究上最可靠的结论是通道与角色影响信息保留,而非某一模型普遍不会表达。
我会先做的验证
未执行的验证方案:在真实工具任务中用相同预算比较自然语言、JSON 和带校验器的协议,增加独立人工责任标签,并报告非法格式、遗漏和歧义分别占比。