Runoff:先独立考虑,再消除候选顺序影响
如何减少选择题和智能体菜单中的排列敏感性,又不支付全部轮换成本?
Runoff先逐项判断是否适合,再只对高概率候选做规范排序和循环轮换,将多数无关选项排除在联合比较之外。开放模型实验能消除所测洗牌下的答案翻转,但这不是正确率保证;API非确定性、概率并列和小菜单成本需要分别处理。
图解主要方法
如何减少选择题和智能体菜单中的排列敏感性,又不支付全部轮换成本?
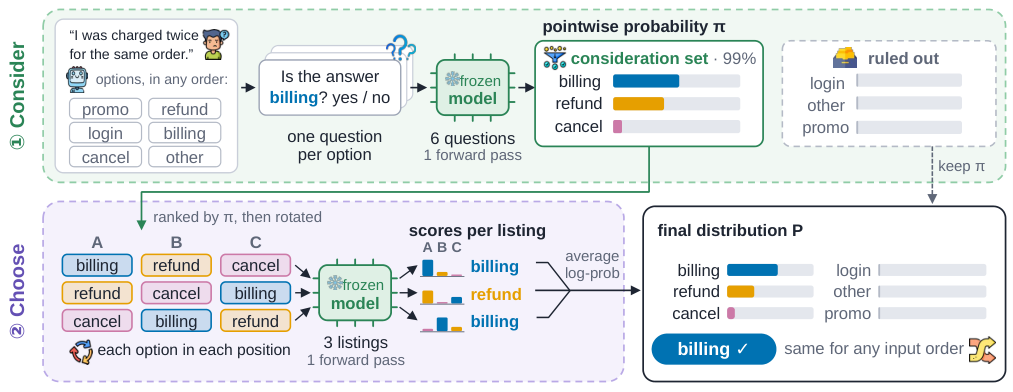
- 1
逐项建立无顺序的候选分布
每个选项独立询问是/否,以对数优势构成softmax概率π。选取累计质量至少0.99且不少于3项的最小概率层级集合,临界并列一并纳入。候选之外的概率质量保留。
- 2
规范排序后再做循环比较
把候选按π排序,对这份规范列表做m次循环平移,平均候选的对数概率。图3展示每个候选在每个位置出现一次;关键是先规范排序,否则仅轮换输入仍依赖初始顺序。附录证明要求π互异与相同请求确定性,不能忽略并列排序规则。
- 3
只重分配候选集合内部质量
将联合比较结果归一化为r,再乘候选集合原有总质量,外部选项保留π。工作量由K²选项槽降到K+m²;共享前缀与分支注意力可打包成两次前向,这不等于任意远程API只需两次串行调用。
- 4
把决策器嵌入电脑操作菜单
对屏幕上可点击元素产生菜单,沿用相同系统状态做选择。菜单规模和候选数量会影响延迟;确定性决策只解决选项排列问题,不消除视觉识别、选项描述或任务规划错误。
实验与证据
已阅读正文1–8与附录A–G,包括提示模板、证明和完整实验表,核对实验条件与原图;未独立复现。
来源证据Qwen3-8B平均正确率65.8、翻转0,对比AnyJev66.8、11.6;Gemma 4 12B为72.2、0,对比73.8、7.1。每题测一次洗牌。 表2:两个开放模型、五组数据 ↗
我的解读零翻转来自有限洗牌实验与有条件证明,不能等同遍历所有排列;正确率略低也说明稳定答案未必更对。
来源证据Banking20上Qwen 308→77ms、Gemma 525→121ms;少选项JevBench中Qwen反而67→77ms。 表4:作者报告推理计时 ↗
我的解读大菜单节省明显,小菜单可能变慢;不能将4倍提升泛化到所有工作负载。
来源证据主文将Tev1 Runoff翻转列为0,但完整表平均2.3%,其中MMLU-Pro7.3%;附录说明API非确定性。部分专用模型训练含Banking77。 附录D表9对照主文表3 ↗
我的解读应报告表间不一致及训练重叠,不把所有模型宣传成零翻转或严格零样本比较。
来源证据369任务中运行316,排除53个受代理或Drive依赖影响的任务;Qwen35B完成27对21,9B完成14对9。部分600秒超时改1800秒重跑。 第6节与附录G:OSWorld代理实验 ↗
我的解读这些是完成任务数,不是百分比。不同超时重跑数量和单次评测限制因果结论,不能作为完全等预算的端到端加速证明。
开放情况与使用许可
论文为CC BY 4.0;正文所链接仓库主要为相关基线,尚未核实独立Runoff实现与权重,不能标为代码开源。
LICENSECC BY 4.0
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
把位置偏差与无关候选干扰分开处理,提供了可分析的规范排序机制与明显的小候选计算收益。
反方 · 哪些结论还不够
证明依赖确定性和互异概率;API结果有非零翻转,低候选数可能更慢。未证明概率校准,未消除标签语义偏差;电脑操作样本筛选与超时重跑需复现实验控制。
综合判断
适合作为有限菜单决策的稳定化组件,部署要同时测正确率、并列规则和延迟,不能只追求零翻转。
我会先做的验证
未执行的验证方案:固定硬件、菜单和总时间,比较随机全排列、多次相同API请求及概率并列案例;单列K与m、尾延迟、正确率,并复测全部可执行OSWorld任务。