Cortex:把上下文经验固化为参数记忆
拿走上下文后保留多少收益,连续更新又会忘掉多少旧知识?
Cortex 用同一模型带上下文时的回答分布监督不带上下文的学生,在前馈层中更新低秩参数或增加新通道。它把单次、批量和连续记忆写入放到同一框架中,区分目标能力吸收与非目标能力保留;连续事实编辑仍依赖回放,不能理解为冻结旧参数即可永不遗忘。
图解主要方法
拿走上下文后保留多少收益,连续更新又会忘掉多少旧知识?
- 1
先构造未来会遇到的问题
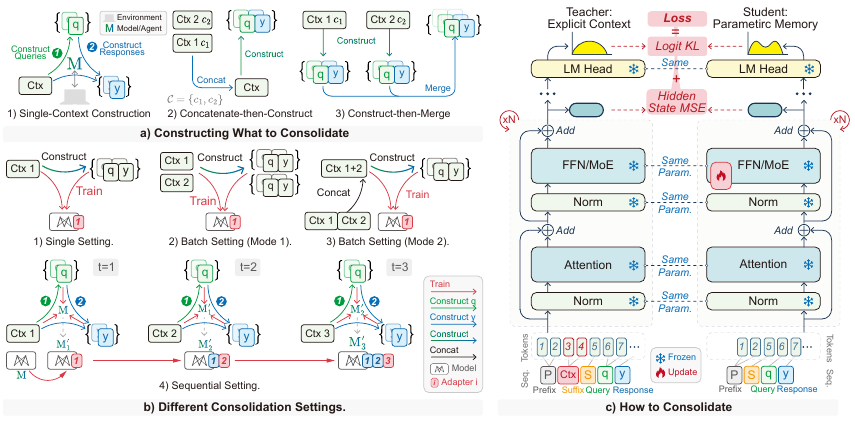
图2左上从待固化上下文 C 构造查询 q,再由带 C 的冻结模型生成回答 y。普通任务采用自生成查询;智能体任务采用环境查询并筛选成功轨迹。批量上下文可先合并再生成,也可分别构造后合并。查询与测评隔离,避免把测试答案写回参数。
- 2
让有上下文教师监督无上下文学生
图2右侧教师接收 C、q 和回答前缀,学生去掉 C。训练结合教师 top-1024 词元的分布蒸馏与前馈层隐状态均方误差,温度为2;使用固定回答的 teacher forcing,并非在线采样学生轨迹的强化学习。注意教师截断支持与学生全词表归一化的区别。
- 3
比较两种参数写入位置
Synaptic 用 LoRA 更新前馈层 gate/up/down 并可合并回原形状;Structural 添加新的 SwiGLU 通道、冻结原块,新增 down 投影零初始化。MoE 使用始终激活的共享支路,不能把它的存储及推理开销当作零;固定路由器参数也不保证上游状态变化后路由不变。
- 4
连续更新需要查询回放
图2左下每轮保留先前适配器,新增适配器学习新经验,同时保存至多100条历史查询并重生成旧回答,再混合固定通用问题。只保存查询比保留完整上下文紧凑,但新增支路仍会改变旧行为;回放还增加训练步数,需要另做等算力比较。
实验与证据
已阅读99页PDF的正文与公开附录A–D,核对实验条件与原图;未独立复现。
来源证据Qwen2.5-14B 上固定顺序写入50条兼容 zsRE 事实,Structural 的固化率 CR 为88.9±3.5,保留率 RR 为99.8±0.8;Synaptic 为80.6±3.7与97.2±0.8。CR 是恢复上下文收益的比例,RR 是指定保留集相对基线的比值。 第5节与连续编辑附录:50条事实、3个种子 ↗
我的解读我的解读:99.8不是“所有知识保留99.8%”。通用保留集只覆盖指定 MMLU、SQA、GSM8K 子集,且小的上下文收益分母会放大 CR 波动。
来源证据Structural 的编辑有效性95.3、泛化93.1,但可迁移推理仅49.4;去历史回放后最终 CR 从88.9降至45.9。每条更新新增约0.73728M参数,50条累积约36.86M。 附录连续编辑细项与回放消融 ↗
我的解读我的解读:直接问答改善不等同于跨关系推理;结构增长与回放共同贡献,不能只归功于新增神经元。
来源证据100项任务、3次运行中,基线60.3、带上下文64.7、Structural62.0、Synaptic56.3;其 CR 分别约38.5与−92.3。 智能体实验:τ2、GPT-OSS-20B ↗
我的解读我的解读:存在明确负迁移,方法并非对所有模型和任务稳定有效。人格和抑制任务的局部指标也不能外推为通用安全或彻底遗忘。
开放情况与使用许可
论文全文公开;本次打开作者所指 github.com/zjunlp/cortex 返回404,未验证代码及权重可下载,不计作开源。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
我的判断:将上下文收益、参数记忆和非目标行为分别度量,让持续学习从“记住几个样例”走向可审计的吸收与遗忘分析。
反方 · 哪些结论还不够
固定事实顺序、有限保留集和额外回放预算限制了结论;Structural 会持续增大模型,抑制文本重现也不代表信息被彻底移除。
综合判断
适合把稳定文档或经过验证的经验写入受控模型,尚不足以支持无限期自动记忆或无需回放的持续学习。
我会先做的验证
未执行的验证方案:在同一模型上固定总训练 token 与新增参数预算,随机化事实顺序,分别测直接召回、组合推理和无关能力,并按每次更新记录延迟与累计参数。