CoT前缀:评测接口怎样把正确信息读成错误答案
要求先解释却立即评分选项标签,测到的可能是输出格式错位
给模型加上“逐步思考”后立即比较A/B概率,与让模型真正生成推理再抽取答案,是两种不同事件。论文在ScienceQA发现前者大幅掉分,而匹配探针仍可读出答案信息;这提醒我们先检查解码协议,不能把接口失配直接称为推理能力退化。
图解主要方法
图1中Direct、CoT-prefix和自由生成为何可能读出不同答案?
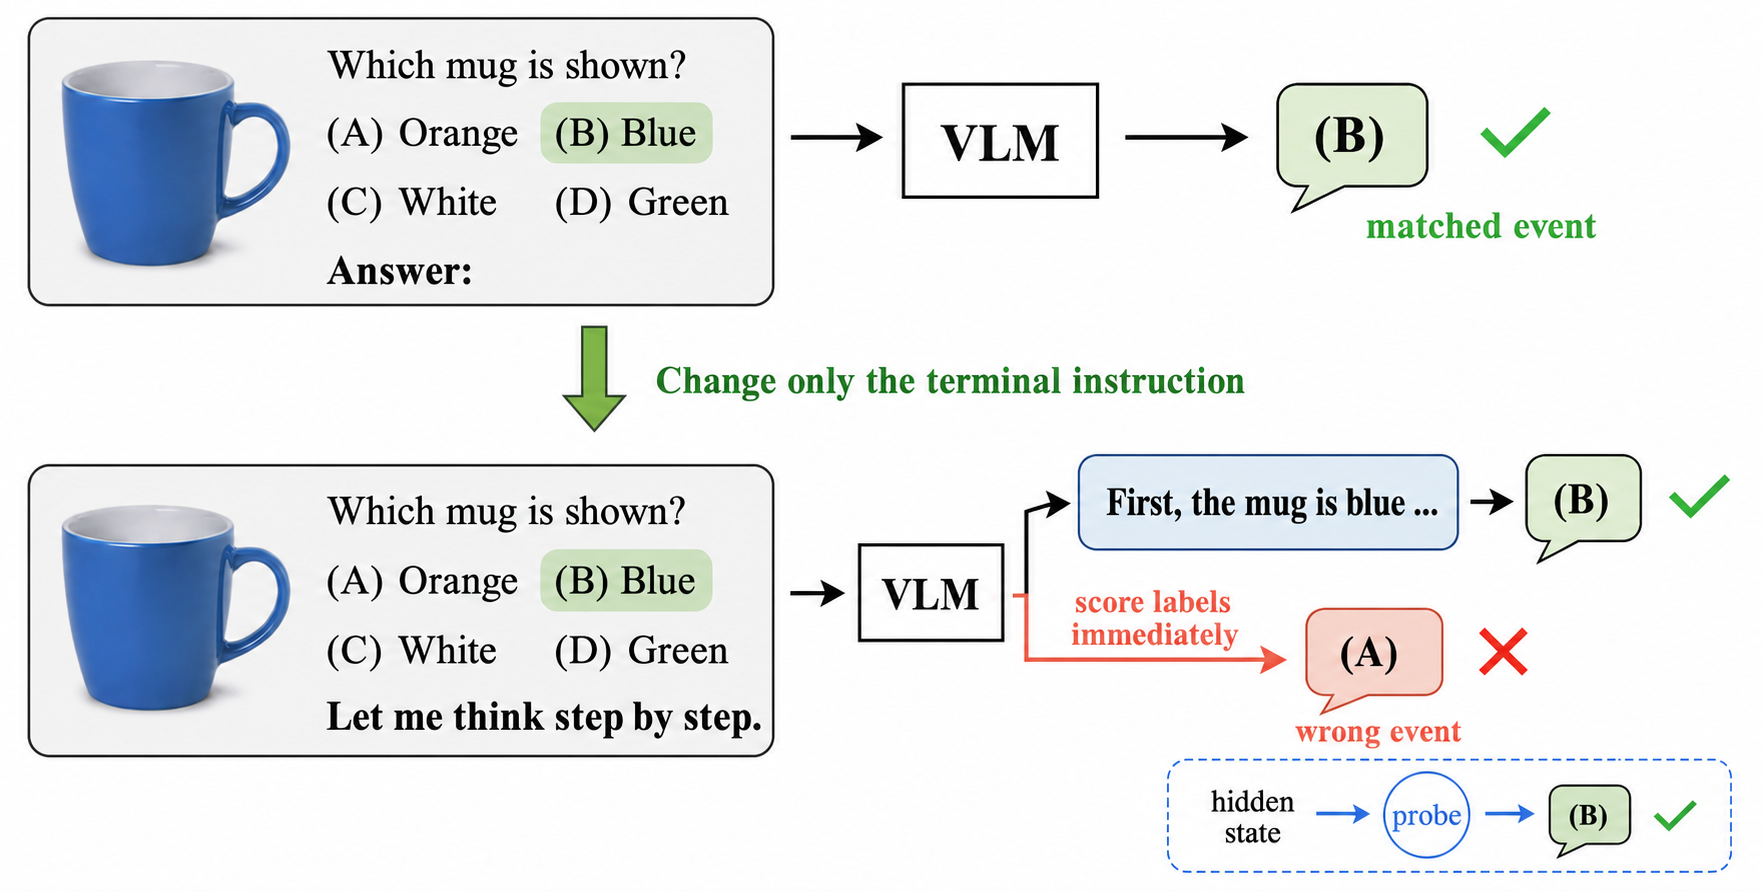
- 1
区分三种被评分的事件
Direct要求直接输出标签;CoT-prefix要求解释但仍在第一个位置评分标签;自由CoT先生成再抽答案。图中的A/B差异来自“现在应输出什么”的条件变化,而不只是题目理解。完整选项字符串评分又是第四种接口。
- 2
用冻结隐藏状态训练匹配探针
在Qwen2.5-VL-7B的3584维隐藏状态上学习到五标签的线性读出,按官方训练和验证划分训练,再测4241题及其2017张带图子集。探针能恢复信息,说明隐藏状态有可读答案线索;不能据此证明原模型本会因果使用这些线索。
- 3
用概率与选项重排定位偏置
论文检查标签总概率、分层探针和五个重排种子。CoT-prefix大量偏向第一槽位;重排内容后第一槽仍是A,因此实验尚未分开位置偏好和字母偏好。数据有52.5%二选一题,第一槽真值基线也不能误设为20%。
- 4
只改输出头检验可修复性
在冻结隐藏表示时给输出头加rank32 LoRA,用3000样本训练,检验答案读出能否改善。它缩小差距,但没有完全恢复Direct,也不能据此把所有错误都归因于输出头。
实验与证据
以下为作者报告;已阅读 v1 全文及可用附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【主实验】ScienceQA全4241题,原生标签评分80.76%→45.48%;匹配探针84.27%→78.94%。自由生成75.24%,215个解析失败计错。 表1与探针设置 ↗
我的解读我的解读:大掉分与被评分事件变化有关;探针与自由生成使用不同读出和训练条件,不是可直接替换的模型能力分数。
来源证据【反例】完整选项字符串评分52.32%→55.41%;MMBench标签评分93.31%→99.11%。 接口对照与表1 ↗
我的解读我的解读:该效应依赖任务和评分接口,不能概括为思维链总会损害视觉语言模型。
来源证据【输出头干预】CoT-prefix在输出头适配后达到70.90%,Direct为80.60%。 输出头LoRA实验 ↗
我的解读我的解读:支持读出有可修复部分,但残余差距和额外监督不能忽略。
开放情况与使用许可
全文及可用附录已读;本次未核实作者专属评测实现或适配权重公开。
LICENSE论文原图许可见图注;评测实现与适配权重许可未确认。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
以同一模型和题集拆开提示、生成、标签读出,能直接帮助审计选择题评测中的假性退步。
反方 · 哪些结论还不够
只覆盖有限模型和任务;第一槽与标签身份未完全解耦,探针可读性不是原策略的因果解释。
综合判断
评测报告应明确是否实际生成推理、标签映射和解析失败口径,再讨论能力变化。
我会先做的验证
未执行的验证方案:固定题目,同时随机化标签字符与内容位置;等预算比较直接标签、完整选项、自由生成和强制答案分隔符,并单列解析失败、标签概率质量与各子集准确率。