CoTrace:训练终端智能体时,执行框架也是数据的一部分
按提示、工具和观测处理的来源筛选轨迹;小语料有效不等于总成本更低
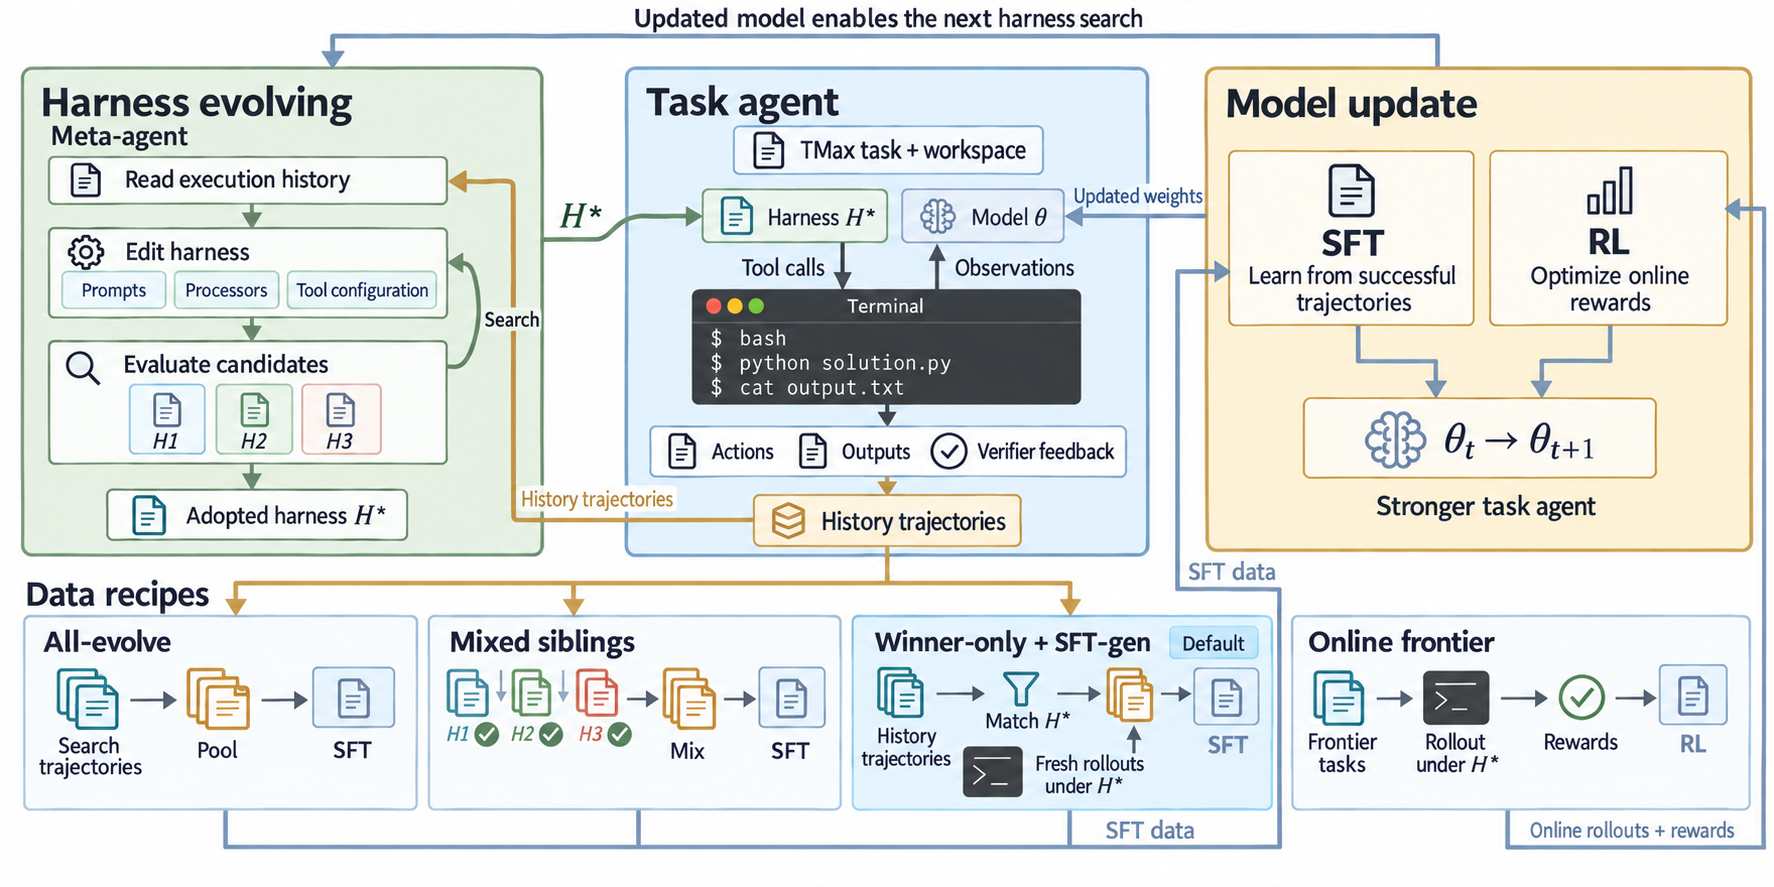
CoTrace交替优化模型权重与执行框架,将运行失败交给框架修改,将与当前框架匹配的验证成功轨迹用于监督训练,并持续补充新任务。9B模型在反复用于选择版本的102题promotion split上由78到88,RL系统到90;但独立运行框架会改变迁移结果,SFT在SWE-bench Lite的配套系统仍不如基础系统。
图解主要方法
智能体的成功轨迹换了提示、工具和错误恢复环境后,还是合适的训练目标吗?
- 1
把运行轨迹分成不同用途
依据最早未恢复故障区分环境、评分器、工具包装和模型重复错误,低置信归隔离区。框架搜索看可复现运行故障,监督训练只用验证成功且格式完整的轨迹;论文规则表的训练目的地不代表直接模仿失败答案。
- 2
记录真正的运行来源
指纹包含提示模板、工具绑定与观测处理器,不只是框架名称。保留与当前采纳框架匹配的成功轨迹,优先当前数据、历史最多40%,通常每题一条,不足则在相同框架下补采新轨迹。
- 3
先固定权重改框架,再固定框架改权重
两代各5候选的框架搜索先做结构、探针与可执行性检查,再在102题promotion split比较新解题和新失败;净增才采纳,完整无基础设施故障的平局可接受。模型更新也用同一原则回退,防止只报告最乐观候选。
- 4
用SFT或在线RL更新模型
SFT用LoRA秩32、alpha64、2epochs、4096序列和completion-only损失;在线RL在采纳框架下采100任务、2304episode,二元结果奖励、组内优势、DPPO二元总变差阈值0.1及参考KL0.01。RL是另一路实验,不是所有SFT配置后必然继续。
- 5
更新课程并检验整对系统迁移
SFT任务须已解出且轨迹已进入训练才退休,补满50个演化任务;RL依经验成功退休。外部测试分别比较同模型不同框架,区分模型能力、格式失败和无补丁结束,不能只比较权重文件。
实验与证据
完整正文及附录A–G已读,包括算法、超参、逐阶段采纳账本、迁移统计与早期试验;图6视觉核验。未执行模型训练或作者终端程序。
来源证据9B SFT78到88:框架累计+4、模型+6;RL78到90:框架+5、模型+7,后续85候选被拒绝。 表1、8、11 ↗
我的解读这是102题版本选择集上的账本,最终保留90不等于最后训练候选90,也不证明未见任务同幅提升。
来源证据混合候选149–308轨迹/轮,匹配30–50;训练prompt/completion对分别618–1335与526–948。 表2、10 ↗
我的解读单轨迹产生多训练对,五倍轨迹数量差不能写成五倍梯度计算节省。
来源证据匹配SFT47GPU小时/轮、5轮约235;混合54/轮、3轮约162。 3.3;附录表5 ↗
我的解读更低每轮成本伴随更高整链总成本,摘要中的高效需限定口径。
来源证据4B SFT65到69全部由框架贡献,三次模型候选均拒绝;RL67到79由模型贡献。 表1、8;E.6 ↗
我的解读方法不是所有规模都能靠SFT提升;匹配成功轨迹只有2、3、2时,补采与可用语料稀缺仍限制训练。
来源证据一次2×2交叉评估为78/82和82/86,差分交互为0。 表3;E.8 ↗
我的解读该转移说明框架与权重收益可加,不支持二者必有协同放大;其他阶段尚未完全交叉验证。
来源证据Terminal-Bench89题,基线框架三次:基础18.7±1.5题、SFT18.3±2.5,RL约高1题。 4.3;图5 ↗
我的解读这里是解题数而非百分数;主循环10–12题收益没有直接迁移,差异在试验波动内。
来源证据SWE-bench Lite300项:配套系统基础37.3%、SFT35%、RL41%;统一mini-swe-agent34.7%、24.7%、36.7%。 表12 ↗
我的解读更换框架能挽回接口损失,但SFT配套系统仍低于基础;不能称全部模型训练都改善外域表现。
来源证据配套系统RL对基础赢31输20,McNemar p=0.16;RL对SFT赢36输18,p=0.02。 E.5 ↗
我的解读只后一比较达到常用显著性阈值;不能将41%对37.3%的差异写成已统计确认优越。
来源证据SFT同权重换框架无补丁155降64,解析失败57;RL在第三方框架格式失败15。 表12;D.6 ↗
我的解读收益大量来自程序执行路径,而不是仅由最终解决问题能力提升;到达评分器后的成功比例接近。
来源证据外部SWE框架把预算120调整250步;Tmax特定HTTP依赖保护在此不触发。 E.5 ↗
我的解读迁移是经任务协议适配的系统,不是原封不动复制运行环境。
来源证据附录G早期15题试验中,按能力路由与分类平衡各400轨迹,无差别混合107。 表16;D.3;C.5 ↗
我的解读只能将两种400轨迹设置称等预算;不能照抄段落把三者全称等量,且需澄清这些TB题与外部评测的重叠。
开放情况与使用许可
作者主页列为ICLR 2027投稿,未称录用。论文称提供已采纳配置,但正文及作者条目未给可核实的完整仓库、检查点或数据下载;专有元智能体搜索也不能仅凭论文复现。
LICENSE论文及图6为CC BY 4.0;训练轨迹、执行配置、模型权重和完整实现许可尚未核实。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
9B匹配语料获得两次采纳的模型更新,合计增加6题;混合候选框架语料的三次模型更新均被拒绝。
固定权重换执行框架,SFT在SWE-bench Lite从24.7%到35%,无补丁实例从155到64,直接显示运行接口的重要性。
反方 · 哪些结论还不够
主对照同时改六类数据选择因素,不能归因于配置指纹匹配一个变量。
每轮47GPU小时低于54,但5轮总235高于3轮162;更少轨迹也不意味着训练样本或总计算按比例更少。
作者称外部集未用于主循环,但附录有15题Terminal-Bench早期试验,基础框架也经Terminal-Bench手调;需要披露重叠与选择影响,不能笼统称完全未接触。
综合判断
证据支持将模型和执行框架作为一个可版本化系统评估;尚不足以宣称匹配语料普遍最优、外部泛化显著提升或整个流程总成本更低。
我会先做的验证
建议实验(尚未执行):固定总token、轨迹任务覆盖、回放比例与新鲜度,仅切换配置匹配;用多独立演化链和从未参与调参的测试集报告置信区间,并公开运行配置、完整失败日志及外部试验题目重叠。