Deep Fusion Memory:把检索记忆预测进冻结语言模型
减少外部检索,是否真的保留了可验证知识?
训练小型预测器从上下文生成记忆槽,再经门控交叉注意力融合到冻结LLM。论文显示特定问答平均分和检索次数改善,同时暴露基础模型退步、跨任务差异与成本核算边界。
图解主要方法
减少外部检索,是否真的保留了可验证知识?
- 1
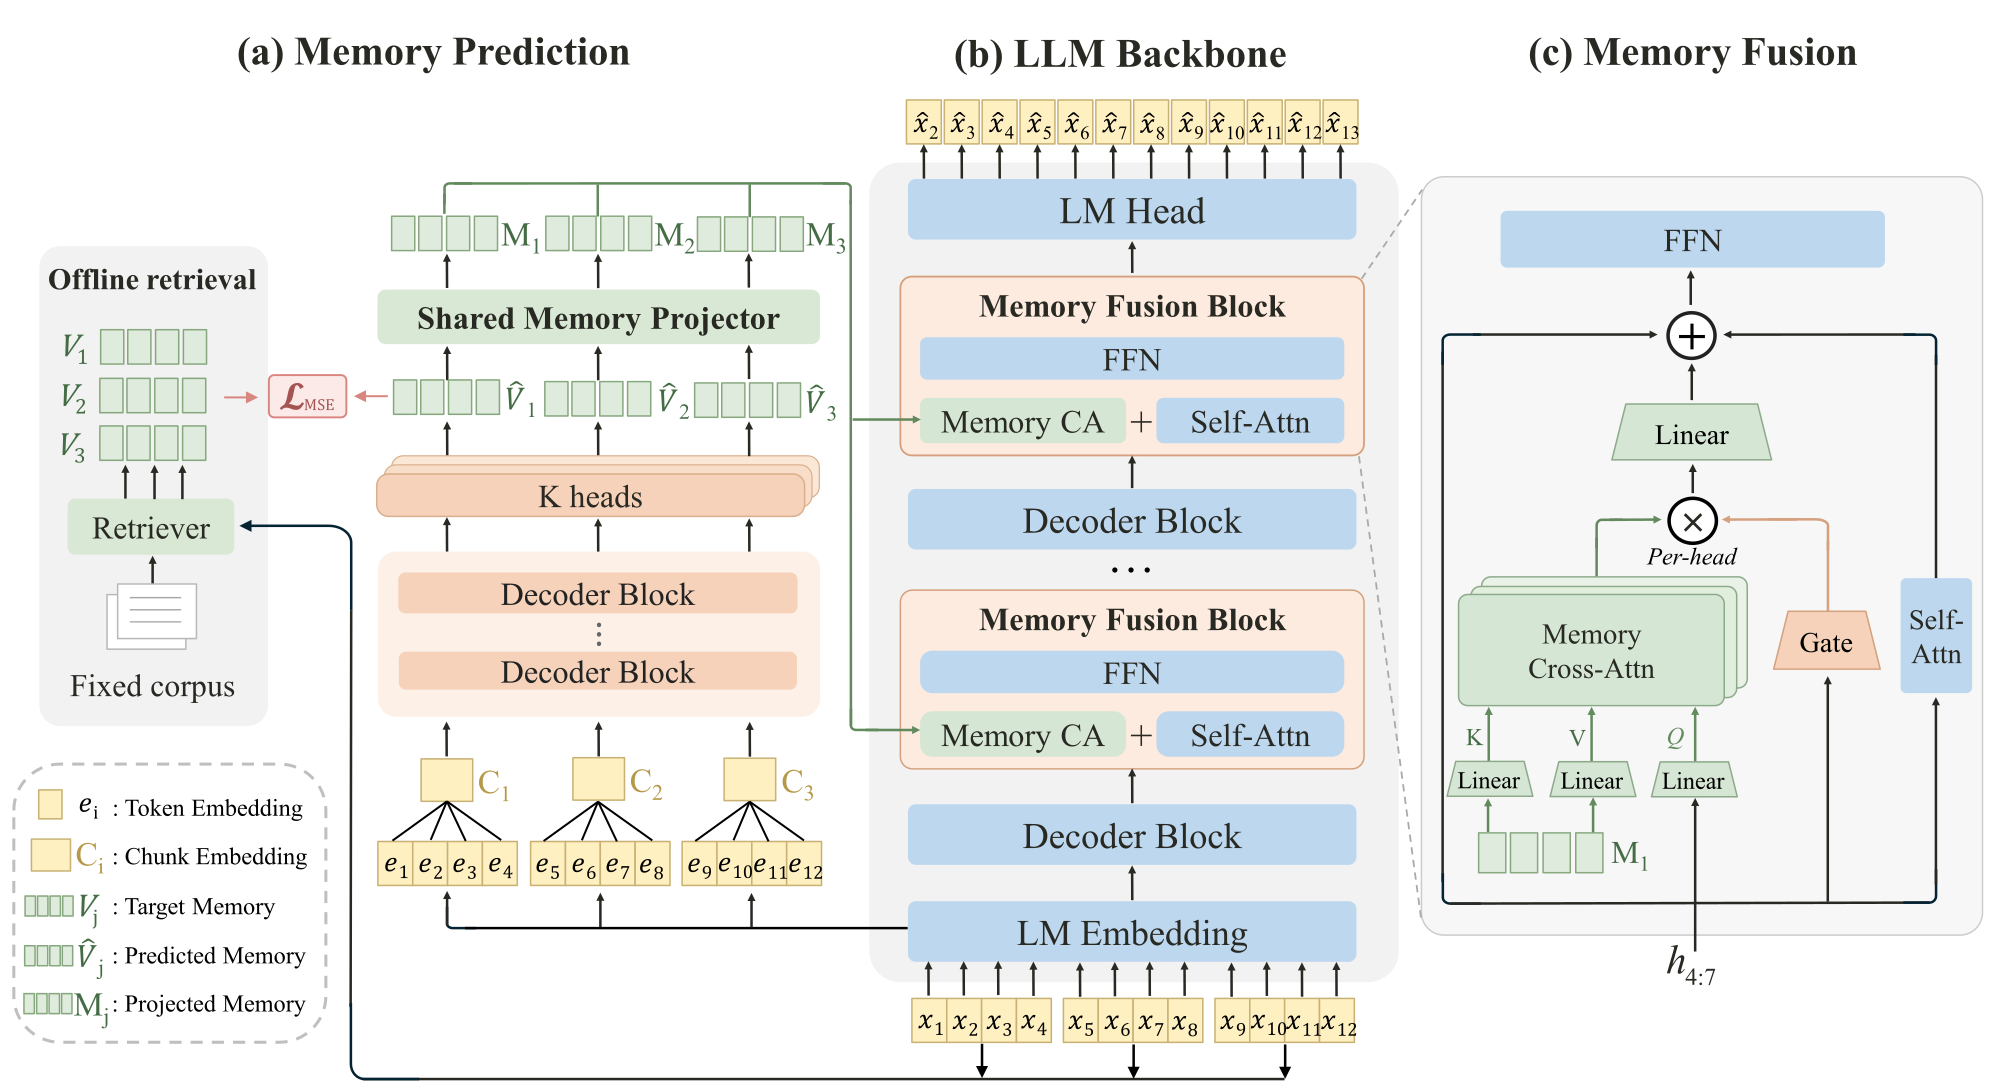
离线构造记忆教师
用训练知识库检索得到目标记忆,作为预测器的监督;这把部分检索工作提前到训练期,不能把训练侧索引和教师生成成本视为零。知识库使用截至2018年12月的Wikipedia约4B token。
- 2
从局部历史预测记忆槽
预测器约0.75B参数,4B模型版本约0.6B;主体28层、隐藏维1024。将此前32个token池化,预测16个记忆槽,并保持因果边界。问答评估使用当前可见提示,不读取未来答案。
- 3
多层门控深融合
在冻结LLM第9、16、24、31层注入记忆交叉注意力,通过可学习门控控制贡献。记忆在生成答案时固定,论文设定没有持续更新答案期间的记忆缓存。
- 4
联合优化预测与语言目标
训练语言建模损失加权重为1的记忆MSE,让预测器既靠近离线教师又服务输出。消融必须分清融合层数、门控初始化与模型容量,而非把所有收益归因于记忆语义。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据Mistral配置中xRAG为24.14、DFM为27.21,提高3.07个百分点,即相对12.71%;Qwen由23.80到26.46,提高2.66个百分点,即相对11.19%。 问答平均分 ↗
我的解读论文相对百分比不是绝对百分点,且跨数据集平均不能替代逐任务证据。
来源证据Qwen在WebQA基础模型41.78高于DFM39.47;Mistral的2Wiki中RAG31.02高于DFM25。门控bias=0得到27.90,高于默认-2的27.21;两层融合27.54也高于默认四层。 负面任务与消融 ↗
我的解读记忆注入会伤害部分已有知识或推理,更多融合层并非单调更好;单次消融分数不足以判定稳健最优配置。
来源证据论文报告32倍更少检索查询、2048倍更少返回槽;16张A800的所列训练耗时由64小时到24小时,统计未覆盖全部知识库构建。 计算与检索条件 ↗
我的解读查询数、返回槽数不是FLOPs、存储或端到端成本的同义词。其优势需要包含预测器和离线数据处理重新结算。
开放情况与使用许可
已核对论文正文与公开附录;未确认可运行的官方实现、权重和对应许可证,不能将论文承诺发布写成已经开源。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
冻结主模型而训练可插拔记忆预测器,提供了减少在线检索依赖的具体路径。
反方 · 哪些结论还不够
预测记忆不等于可追溯检索证据;知识更新、幻觉校验和若干任务退步仍是部署障碍,实验也没有穷尽系统成本。
综合判断
适合作为知识压缩研究,尚不能据此宣称比检索增强生成更可靠或更易更新。
我会先做的验证
未执行的验证方案:固定知识版本与推理预算,加入新事实、冲突证据和可撤回事实测试;同时记录引用正确率、更新成本、预测器时延和全流程GPU小时。