OpenDS:让深度搜索回到真实网页与长任务
代理找到正确答案,和它可靠地完成研究,是同一个问题吗?
200道真实网页研究题及统一工具协议,把长程浏览、工具故障和证据定位纳入评测。领先模型正确率仍约四成;人工与代理预算不一致,不能直接把分数解释成全面超越人类。
图解主要方法
代理找到正确答案,和它可靠地完成研究,是同一个问题吗?
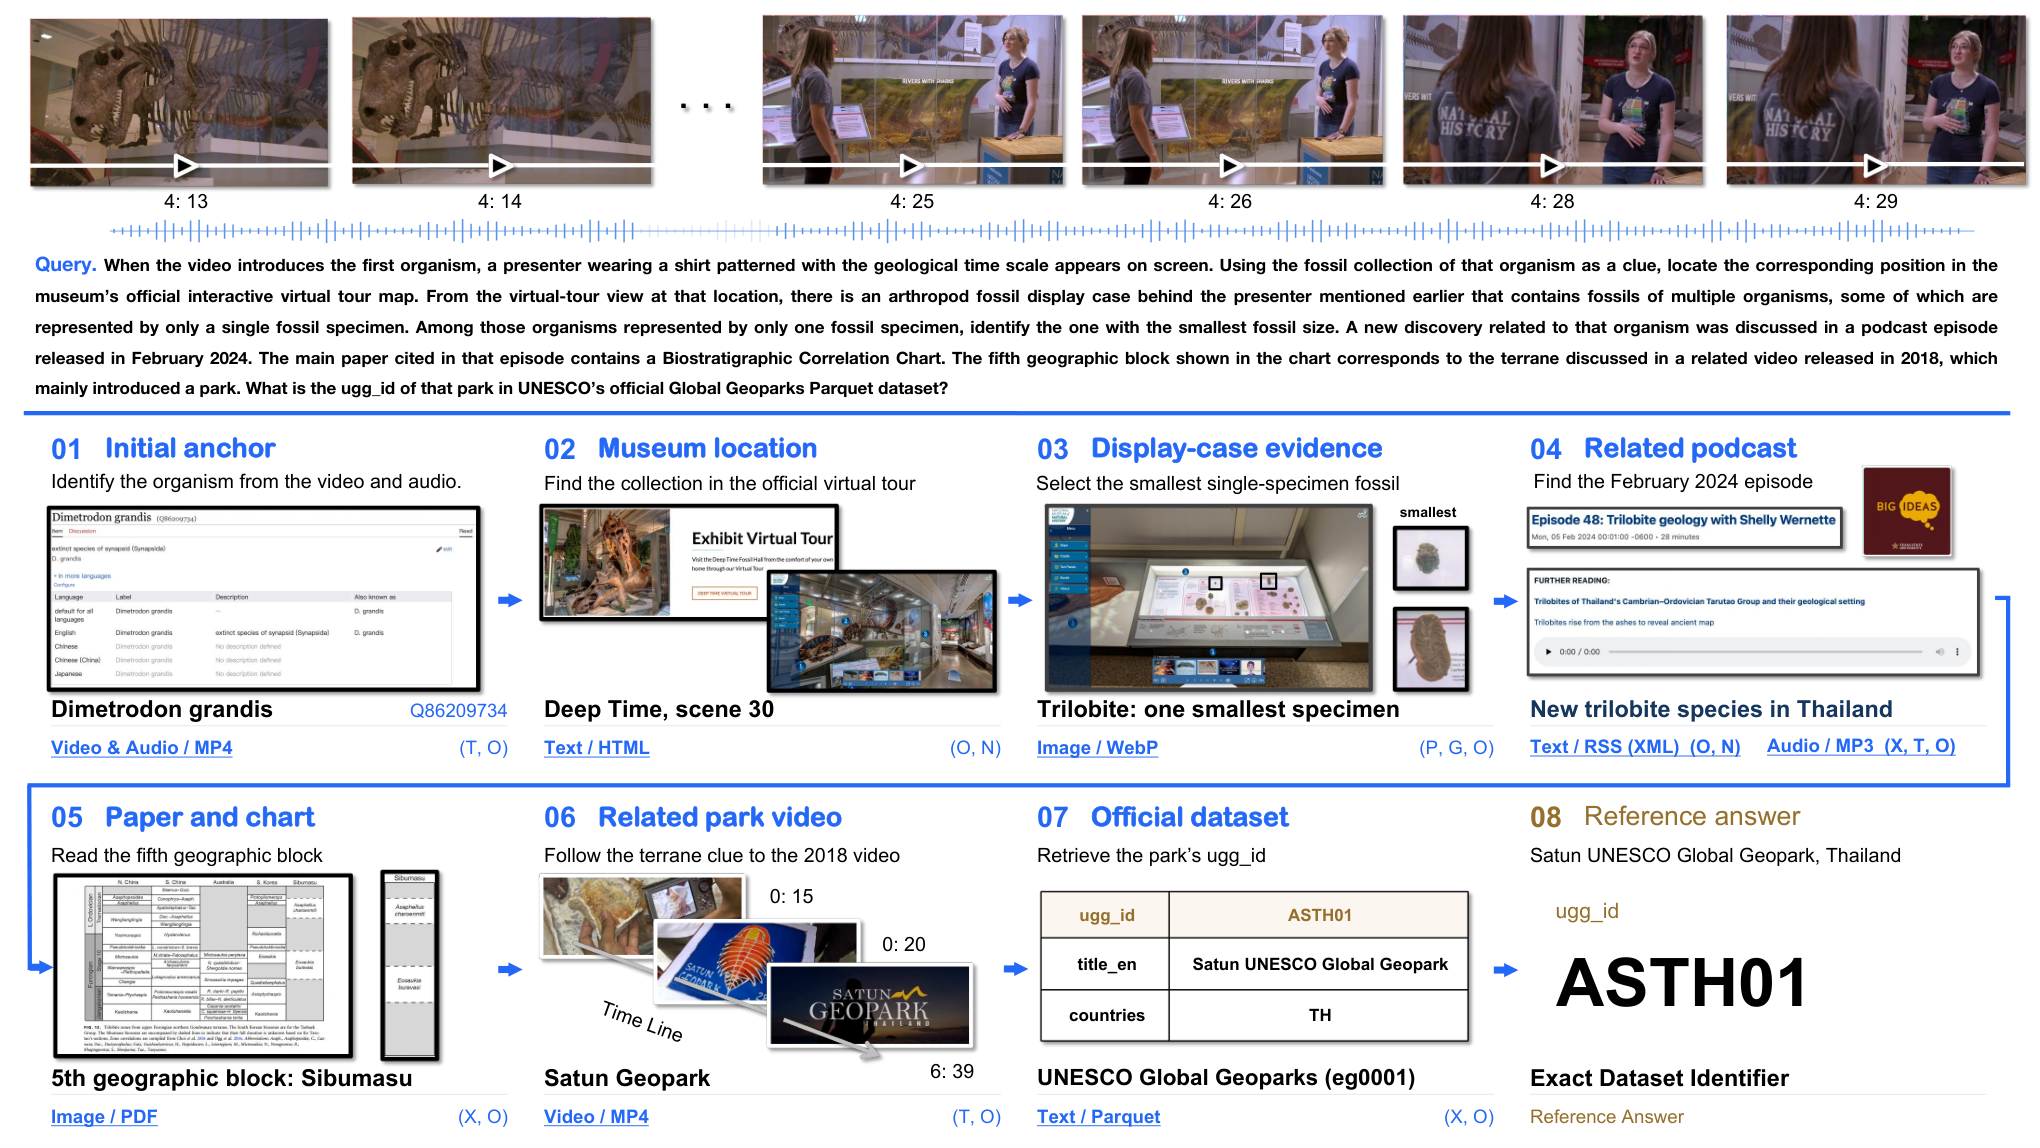
- 1
从视频构造可定位的真实问题
从500个视频候选中覆盖8类领域,利用唯一Wikidata锚点扩展证据并反向设计问题,最后保留200题;10名独立审阅者核查。这降低题目含糊性,但并不消除网页变化与答案泄漏。
- 2
统一代理工具和运行上限
12个模型共享16类工具,单题最多1小时和100次调用。上下文保留最近4次工具观察,旧观察压缩至2000字符、搜索留2条、图像250单位;这些截断会影响研究路线。
- 3
分离终止与答案评分
收尾阶段额外2次调用、5000token且禁用工具;Qwen3.8-27B裁判主要判断最终答案的语义等价,不审计整条证据链。能自然结束任务不意味着答案正确。
- 4
审计失败与人类基线
50人每人做20题,合计1000次尝试、每题5人;使用常规浏览器、不用LLM且无相同固定预算。分析调用失败占比和耗时,可定位研究代理被基础设施拖累的方式。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据GPT-6 Astra为39%,即78/200;另一领先模型为38%,即76/200。 代理成绩 ↗
我的解读仅差两题、缺少置信区间时,不宜宣传稳定排名;任务动态性也要求保留评测时点。
来源证据人类单次尝试成功率21.1%,五人至少一人完成的题目比例57.5%,平均耗时38.8分钟。 人类条件 ↗
我的解读21.1%和57.5%是不同统计单位;模型对人的比较同时受到工具、预算与多次尝试规则影响。
来源证据失败调用仅占2.83%–9.42%,却消耗19.27%–61.90%的工具时间;一项模型自然终止比例69%,答案正确率39%。 工具和终止 ↗
我的解读少量失败足以吞噬时间预算。策略与成绩的相关分析不能证明更换策略必然提升,也没有实证完成自我改进闭环。
开放情况与使用许可
Yu-xm/OpenDS仓库已有工具、评测及测试代码,根许可证Apache-2.0。Yu2020/OpenDS-World数据页可见CSV和200个视频文件,但未核实明确的数据许可;代码Apache不自动授权视频再分发。
LICENSECC BY-NC-ND 4.0;原图保持不变
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
问题、工具协议和失败日志一起开放,为真实网页研究提供了比纯静态问答更接近使用场景的检查入口。
反方 · 哪些结论还不够
最终答案裁判不能证明证据来源可靠;网页随时间变化,人工比较并非严格同预算,200题小差距容易被过度解释。
综合判断
适合评估代理的实际研究过程,特别是故障时间和证据可追溯性;分数不是无监督自动发布的通行证。
我会先做的验证
未执行的验证方案:复跑同一批题并冻结网页快照,在同一时间/调用预算下核对引文和完整证据链;对失败工具重试策略做随机对照,报告置信区间。