DexSuite:把灵巧手评测拆成可比较的交互阶段
跨机械臂、夹爪和灵巧手的任务,哪些差异能统一,哪些不能?
DexSuite在Genesis中统一任务接口、机器人配置和示范收集,提供30项任务与多种手臂末端组合。它的价值不仅在规模,而在于揭示:能抓起来与完成多阶段操作之间仍有很大落差。
图解主要方法
跨机械臂、夹爪和灵巧手的任务,哪些差异能统一,哪些不能?
- 1
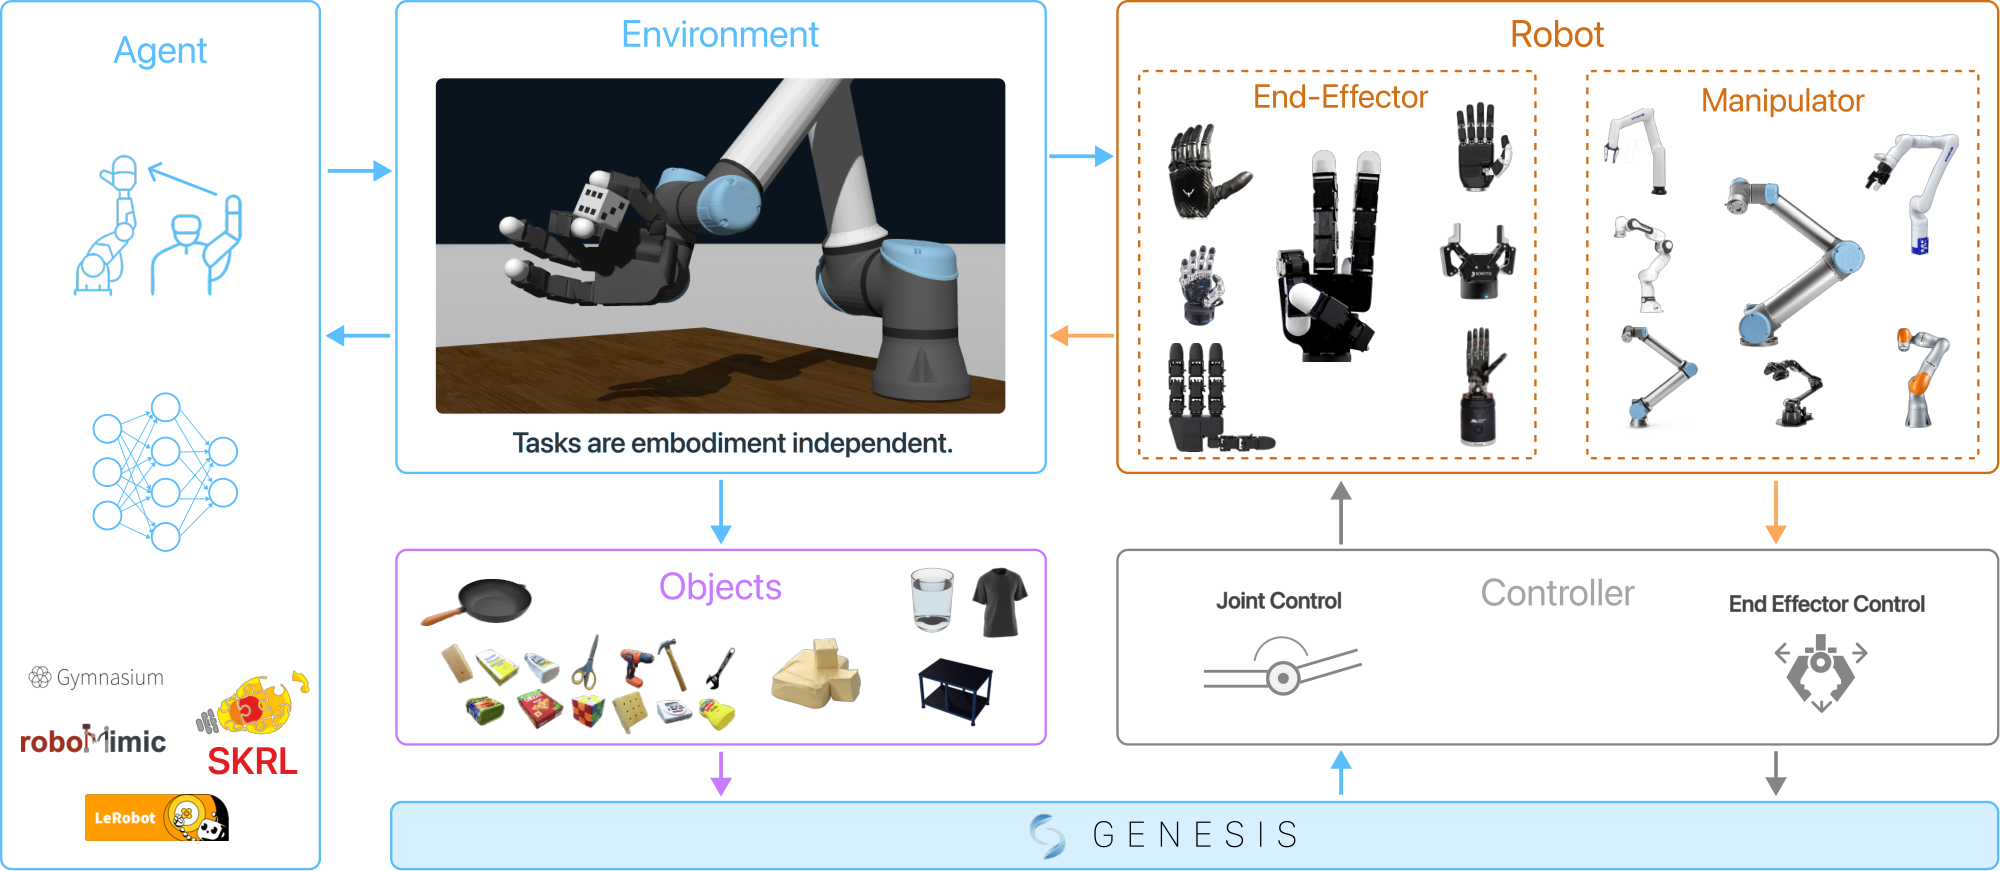
图2:分离任务与机器人描述
环境、物体、机械臂和末端执行器分别配置,通过统一TCP、手臂逆运动学及手指关节控制衔接。库覆盖10种手臂和12种末端,但并非论文对每一种组合都做了性能评测。
- 2
用工作空间采样适配不同手臂
重置时按各机械臂可达工作空间采样,减少根本够不到目标的无效任务。这提高复用性,也让不同手臂看到的初始分布并不完全相同,跨形态公平性还需单独定义。
- 3
触觉是可选的模拟通道
FlexiTac使用12×32、2毫米间距的taxel,通过接触穿透与摩擦近似读数;并非所有末端都有同一种触觉。图2中的传感与控制接口不能被当作真实皮肤传感器标定证明。
- 4
把成功示范与失败阶段分别统计
4700条成功模拟示范来自700条人工、1200条脚本和2800条学习策略,20Hz记录图像与状态。基准再比较多类BC、Diffusion Policy和ACT,并把失败定位到接近、抓取、放置、对齐等阶段,避免总成功率遮蔽瓶颈。
实验与证据
已阅读正文方法、基准协议、结果及失败诊断,核对实验条件与原图;未独立复现。
来源证据实际测试11任务、16个任务-机器人配对,未覆盖全部30任务。每配对通常50个人工示范,最后两项用200脚本示范;每50epoch用50次rollout选检查点,最终3个评估随机种子各50次。 基准协议 ↗
我的解读三个评估种子不是三个独立训练种子;最高验证检查点会引入选择偏差,论文对ACT观察到约7个百分点高估。
来源证据堆叠任务状态策略约16%/9%,图像策略不超过2%;水果放置状态9%而ACT27%,移锅ACT89%。喷洒各方法不超过1%,烤面包为0。 结果与失败诊断 ↗
我的解读视觉不总比状态差,任务阶段与数据来源会改变排序;更高自由度本身并没有自动带来更高成功率。
来源证据额外50次失败分析显示堆叠首放置与第二物体处理均是瓶颈,钻头任务48次在最终对齐失败;喷洒约一半抓取失败。 诊断样本 ↗
我的解读分阶段标签能帮助决定补什么示范,但这里只是模拟诊断,没有真机迁移成功率。
开放情况与使用许可
官方项目页与HF组织可见多个示范数据集;此次未确认项目页提供完整框架代码仓库与统一代码许可。数据条目可见也不等于所有数据均有同一授权;4700条总量为论文口径,未逐文件复算。 抽查lift_auto数据卡标Apache-2.0、50条轨迹与20Hz;这一条目的许可与数量不外推为整个4700条集合。
LICENSE论文 CC BY 4.0;代码与权重许可另见开放范围
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
统一接口与阶段级失败分析有助于把策略差异和形态差异拆开,尤其适合多步骤接触任务。
反方 · 哪些结论还不够
不同初始工作空间、成功示范筛选、检查点选择与触觉覆盖不一致限制直接横比,未证实sim-to-real。
综合判断
适合搭建内部灵巧操作评测矩阵,不能用任务库规模替代真实机器人覆盖。
我会先做的验证
未执行的验证方案:选两种手臂同一末端、同一可达区域与示范预算,多训练种子报告阶段成功率,并增加接触摩擦偏差与少量真机迁移试验。