DexTacWAM:把指尖触觉写进世界动作模型
触觉压缩、预测表示与策略头的作用要分别验证
DexTacWAM 将双手光学触觉压成两个潜在视图,与视频共同预测,再用中间特征生成动作。主表 70.6 分混合了二元和分步得分,不应直接写成 70.6% 任务成功率。
图解主要方法
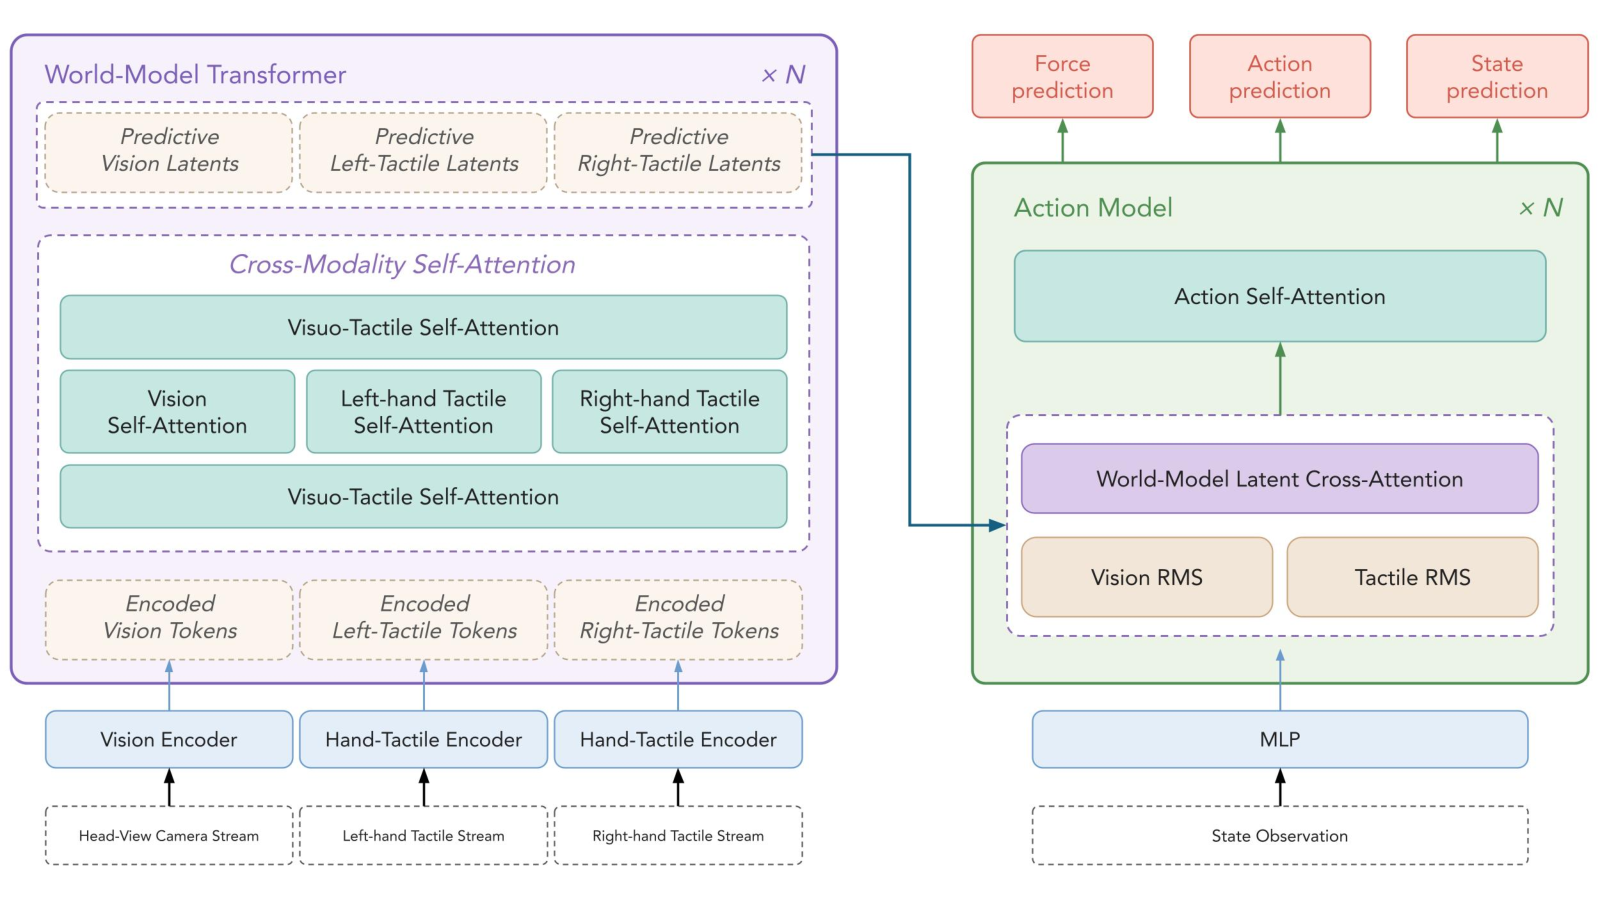
图 1 中触觉进入预测模型之后,动作头究竟读取什么?
- 1
把五指密集触觉压成一个手部视图
22 自由度 Sharpa 手的十个指尖提供灰度光学标记图,经 1×1 灰度转 RGB 适配器和冻结视觉 VAE 编码。每手五指加查询 token,经位置与手指身份编码、时空注意力池化为 6×8×128 潜变量,残差初始为零以保留视觉先验。
- 2
先学习触觉重建与接触变化
488 段、约四小时数据分 464 训练和 24 测试,用流式预测前后的触觉重建训练编码器。四小时是采集数据时长,不是总训练耗时;压缩目标要同时保留静态接触和变化。
- 3
将视觉与双手触觉共同预测
2B 世界模型把视觉和左右触觉作为三种视图输入 DiT,模态内自注意力后做跨模态交互。每任务约百段成功演示用于适配,没有依靠大规模触觉中期预训练,也没有充分覆盖失败恢复。
- 4
从预测特征直接接动作头
160M 动作模型通过跨注意力读取世界模型的单次前向特征,视觉与触觉键值分别做 RMS 归一化。并非先生成一段完全去噪的未来视频再执行;力、动作、状态多头辅助训练,60 维力仅为监督,推理时不作为力输入。
- 5
用模态压缩降低计算但保留测量范围
将逐指视图压到双手视图,把相关 token 从 3168 减至 864。运行速度取决于相机配置、动作分块和模型头;论文的头部计时不等于全机器人从传感器到电机的端到端延迟。
实验与证据
以下为作者报告;已阅读 v1 全文及可用附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【六任务】每项二十次,综合分数 70.6,对比 RDP 38.0;交接三步、擦拭五步得分与二元任务混合。 主实验表 ↗
我的解读我的解读:应分开报告评分和成功率,避免百分号改变指标含义。
来源证据【二元子集】四任务合计 55/80=68.8%,对照 24/80=30.0%;Wilson 区间约 57.9–77.8% 与 21.1–40.8%。 二元任务统计与基线设置 ↗
我的解读我的解读:子集支持显著差距,但外部对照使用六维力而非同样密集触觉图,动作约定也不同。
来源证据【匹配消融】四任务保持触觉数据、编码器和动作空间,去除世界预测后分数 74.7→26.6。 世界模型消融 ↗
我的解读我的解读:比异构外部基线更直接支持预测表示对策略的贡献。
来源证据【RTX 4090】动作头相关推理 363→281.6 ms,约 1.29 倍;每块覆盖 54 步、30Hz,即 1.8 秒。 效率实验 ↗
我的解读我的解读:较长动作块给推理留出时间,但不能由此推出每一步都有实时触觉纠错。
来源证据【泛化与编码】未见碗色 13/20、堆叠 12/20;触觉事件召回 0.725、保留比 0.894。 泛化及编码器实验 ↗
我的解读我的解读:保留比不是 89.4% 的绝对召回率;新硬件和失败恢复仍缺证据。
开放情况与使用许可
已打开作者项目页及其链接,当前未找到本研究可核实的训练代码或模型权重;网页模板和作者链接不构成实现发布。
LICENSE代码、权重许可证尚未确认。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
匹配消融和明确的模态压缩设计使世界预测的控制贡献较容易定位。
反方 · 哪些结论还不够
成功演示、异构基线、分块延迟与有限硬件覆盖限制普适性;视频保持实验中的置信区间不能证明所有视觉能力都无损。
综合判断
值得用于研究密集触觉如何补足遮挡下的视觉状态;部署前要专门验证接触突变与失败恢复。
我会先做的验证
未执行的验证方案:在同动作空间、同密集触觉输入和等算力下比较预测与直接策略,插入滑移、掉落及材质变化,记录每次接触修正延迟与恢复成功率。