DSP:让机器人先学会玩,再用世界模型选动作
少量无目标示范如何变成可重复采集的数据来源?
DSP先模仿人类无目标玩耍,随后用同一策略自主采集接触转移,训练动作条件世界模型。规划时由玩耍策略提出候选,由目标奖励挑选;本文版本的RGB表格、结论与正文存在不一致,因此将硬件效果保留为作者报告。
图解主要方法
少量无目标示范如何变成可重复采集的数据来源?
- 1
学习的是互动先验
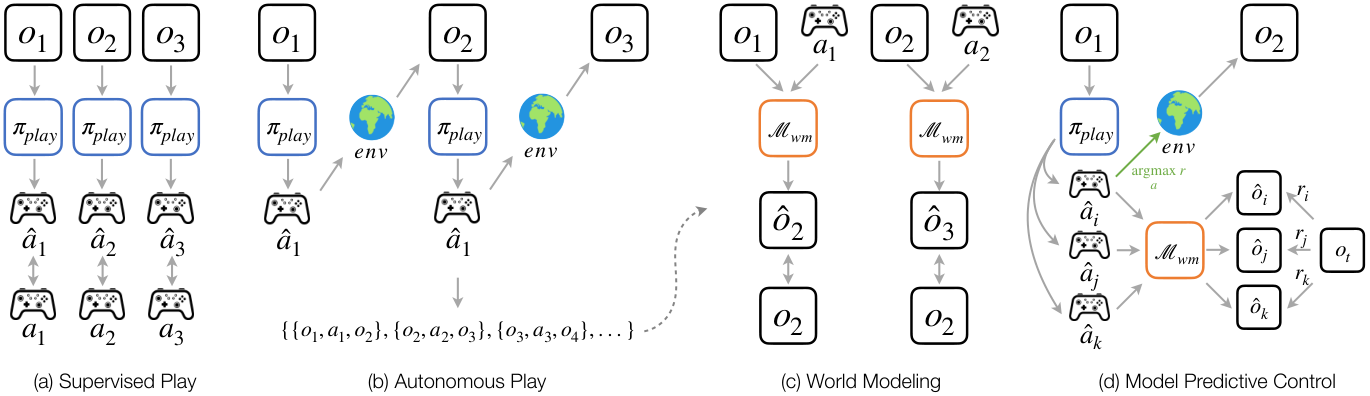
图2a以无目标遥操作轨迹训练扩散Transformer,输入观测历史,输出关节动作块。人类提供接触与换抓结构,而非每个最终任务的解法;这种示范先验仍是一种人工监督。
- 2
自主玩耍扩展转移
图2b部署策略记录观测—动作—后续观测。图2c用Diffusion Forcing给不同时间步不同噪声级别,学习给定历史和候选动作的未来状态;主要重定向实验使用手状态和带标签立方体姿态。
- 3
用目标给候选排序
图2d采样1024个候选,正文规划设置为预测50步、执行25步后重规划,以预测序列中的最佳目标奖励排序。目标只进入MPC评分,玩耍策略和动力学模型保持无目标;掉落重生后继续的仿真协议应单列。
- 4
用模型内自玩蒸馏
可选步骤从5.4万个历史状态各采24个目标,生成约130万MPC标签,训练带目标的闭环策略。减少在线搜索成本,但继承模型误差,不是新增130万真实成功示范。
实验与证据
已阅读正文全文(未见独立附录),核对实验条件与原图;未独立复现。
来源证据初始和目标相差超过90°,2500控制帧;0.6rad阈值下MPC91.4%、hindsight BC53.9%。701K计数帧对照PPO344M帧,后者该阈值86.7%。 仿真重定向:128个固定种子试次 ↗
我的解读约490倍差异是训练交互帧口径,不含示范、模型训练及规划计算,且PPO在更严精度条件下仍有优势。
来源证据Sharpa22关节、Manus示范、ZED标签跟踪;硬件时限120秒。1024候选的端到端重规划中位133.6ms、p95 141.1ms,RTX5090。 硬件协议与时间成本 ↗
我的解读异步动作块执行与重规划耗时是不同频率;不能把15–18Hz执行宣称成每步完成一次完整MPC。
来源证据正文RGB段把34.4/53.1/76.6%归给RGB策略、56.2/78.1/89.1%归给加入MPC;表II却以RGB-space/State-space命名两行。结论还保留硬件结果需冻结协议及部分结果待插入的文字。 公开版本内部不一致 ↗
我的解读不将这些数值当作已澄清的因果比较。保留方法与已说明的条件,等待作者统一协议、表格和最终结果。
开放情况与使用许可
作者FAR-hands/play_policy仓库包含数据采集、策略训练和规划实现;README仍写明代码、检查点和数据的许可证待作者选择。虽提供下载说明,本次未下载权重/数据,不能认定已经授予开源使用许可。论文及原图CC BY 4.0不自动覆盖这些资源。
LICENSECC BY 4.0(论文)
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
同一玩耍先验同时服务数据采集和规划提案,能减少模型在完全随机、缺少接触支持的动作空间里搜索。
反方 · 哪些结论还不够
当前版本有明确表文冲突及临时结论;单立方体、位姿标签、掉落重生和较长时限限制外推。自主玩耍的安全性来源于示范,不构成形式保证。
综合判断
值得跟踪的数据采集—模型—规划闭环;硬件成功率和RGB增益需作者澄清后再作为选型依据。
我会先做的验证
未执行的验证方案:固定不重生的闭环试次、最终姿态与持续保持条件,比较同预算hindsight BC、MPC与蒸馏策略,统计掉落、人工重置及规划算力,先要求作者澄清表II。