DLite:让草稿模型不再携带长历史 KV 缓存
保留目标模型的历史,用当前锚点表示完成轻量草拟
DLite 将推测解码草稿器的计算限制在一个局部块,用目标模型当前 token 的多层隐藏状态提供长历史信息。它移除的是草稿器的历史缓存,目标模型仍保留 KV;加速依赖可访问目标内部表示和标准验证。
图解主要方法
保留目标模型的历史,用当前锚点表示完成轻量草拟
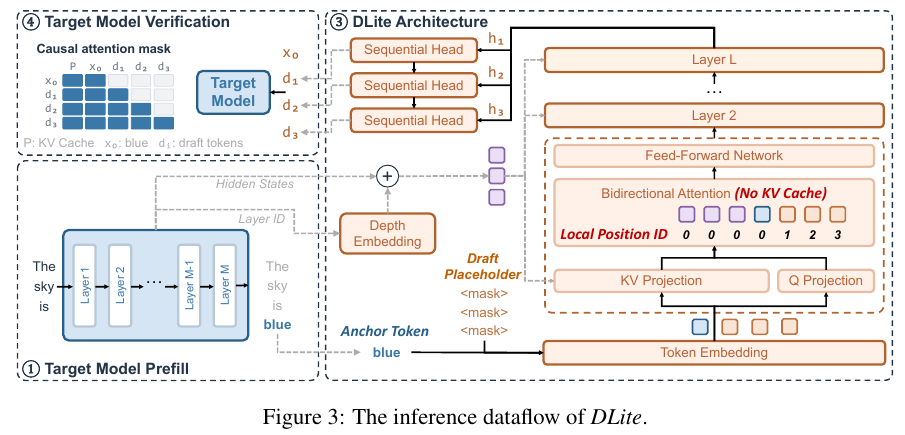
- 1
从目标模型提取当前锚点
图3左侧先由目标模型完成正常计算,只抽取当前锚点 token 的多个深度隐藏状态并加入层级编码。历史信息已经被目标模型压缩进这些表示,因此草稿器不必再读一条随上下文增长的历史 KV 序列。
- 2
并行骨干加轻量顺序头
锚点与局部占位符进入5层双向草稿骨干,局部位置编码只描述当前块。低秩循环头补充块内前缀依赖,尽量兼顾并行生成速度与候选之间的一致性;一次词表投影给出草稿。
- 3
以严格验证保持目标分布
目标模型照常验证候选,接受的 token 再进入下一轮。训练先学习历史可见教师,再蒸馏到无历史草稿器,最后在稳定目标上微调;这与放宽接受规则换速度的有损路线不同。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据训练使用约190万提示,含130万 OpenPerfectBlend 与60万 Nemotron V2,经目标模型重生成;序列长度4096,使用32张 H800。主训练依次为8轮交叉熵、2轮蒸馏、6轮稳定目标训练。 训练与蒸馏设置 ↗
我的解读草稿器不是无训练成本的插件;目标模型变化、隐藏层接口变化都可能要求重新适配。
来源证据Qwen 4B/8B、7个草稿 token 的 SWE 提示评测分别获得2.68/2.74倍加速,长对话为3.88/3.96倍。SWE 使用50条40–64k提示,其他长提示也按独立请求测试,BFCL工具时间被排除。 H800长上下文比较 ↗
我的解读这些是模型解码收益,不能直接声称软件修复或完整智能体任务快同样倍数。
来源证据Qwen 8B Alpaca 并发64时 DLite 为1.63倍,对照方法1.58倍,优势缩小;另一4B MT条件并发16的吞吐8162略低于对照8177。文中10–20%的 KV 占用测量来自另一个 DeepSeek 配置。 并发与适用边界 ↗
我的解读高并发可能让其他瓶颈主导;不能把不同模型的显存测量与 Qwen 加速直接拼成同一部署收益。
开放情况与使用许可
GitHub 已有实际推理代码并采用 MIT;核对到 Qwen3-8B-DLite 的配置与 safetensors 权重文件。该权重条目未提供独立模型卡许可,不能把代码 MIT 自动套到全部权重;SGLang/vLLM集成仍列在计划中。
LICENSECC BY 4.0
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
将草稿器成本从长历史长度中解耦,是长上下文推测解码的一条明确工程路线;消融与并发数据也显示了何时收益减小。
反方 · 哪些结论还不够
需访问目标模型隐藏状态,不能直接套在只有文本输出的黑盒 API;训练、教师和系统集成成本仍在。目标 KV 没有消失,完整工具链时间也未被覆盖。
综合判断
值得在长提示、目标模型固定且系统可改造的服务上试验;不要把草稿器无历史缓存写成整个模型无需 KV。
我会先做的验证
未执行的验证方案:固定目标模型与精度,在真实多轮工具任务上加入工具耗时和失败重试,对比不同并发下正确完成率、显存峰值及端到端尾延迟。