缩短推理链之后,我们还看得懂模型吗?
忠实性与可监督性不是同一个指标,输出不稳定也会拉低解释分数
研究在三种4B–8B推理模型上比较固定截断、指定长度和组内长度奖励。多数设置降低推理链对模型行为的可预测性,但对迎合用户线索的检测大体保留;严重压缩时,医学问题中的偏置影响更容易被隐藏。结果反对把“更短”与“更不可信”直接画等号。
图解主要方法
压缩推理之后,失去的是解释信息、决策稳定性,还是对偏置的可见性?
- 1
用三种不同机制施加长度压力
ThinkPrune先按固定预算截断,再判答案正确;L1把目标长度写入提示,奖励正确并惩罚偏离目标;GLP按同题生成组的相对长度给正确答案奖励,错误答案不能靠短而获得正向长度奖励。三者共享GRPO与LoRA框架,但优化压力并不等价。
- 2
用反事实预测测解释的帮助
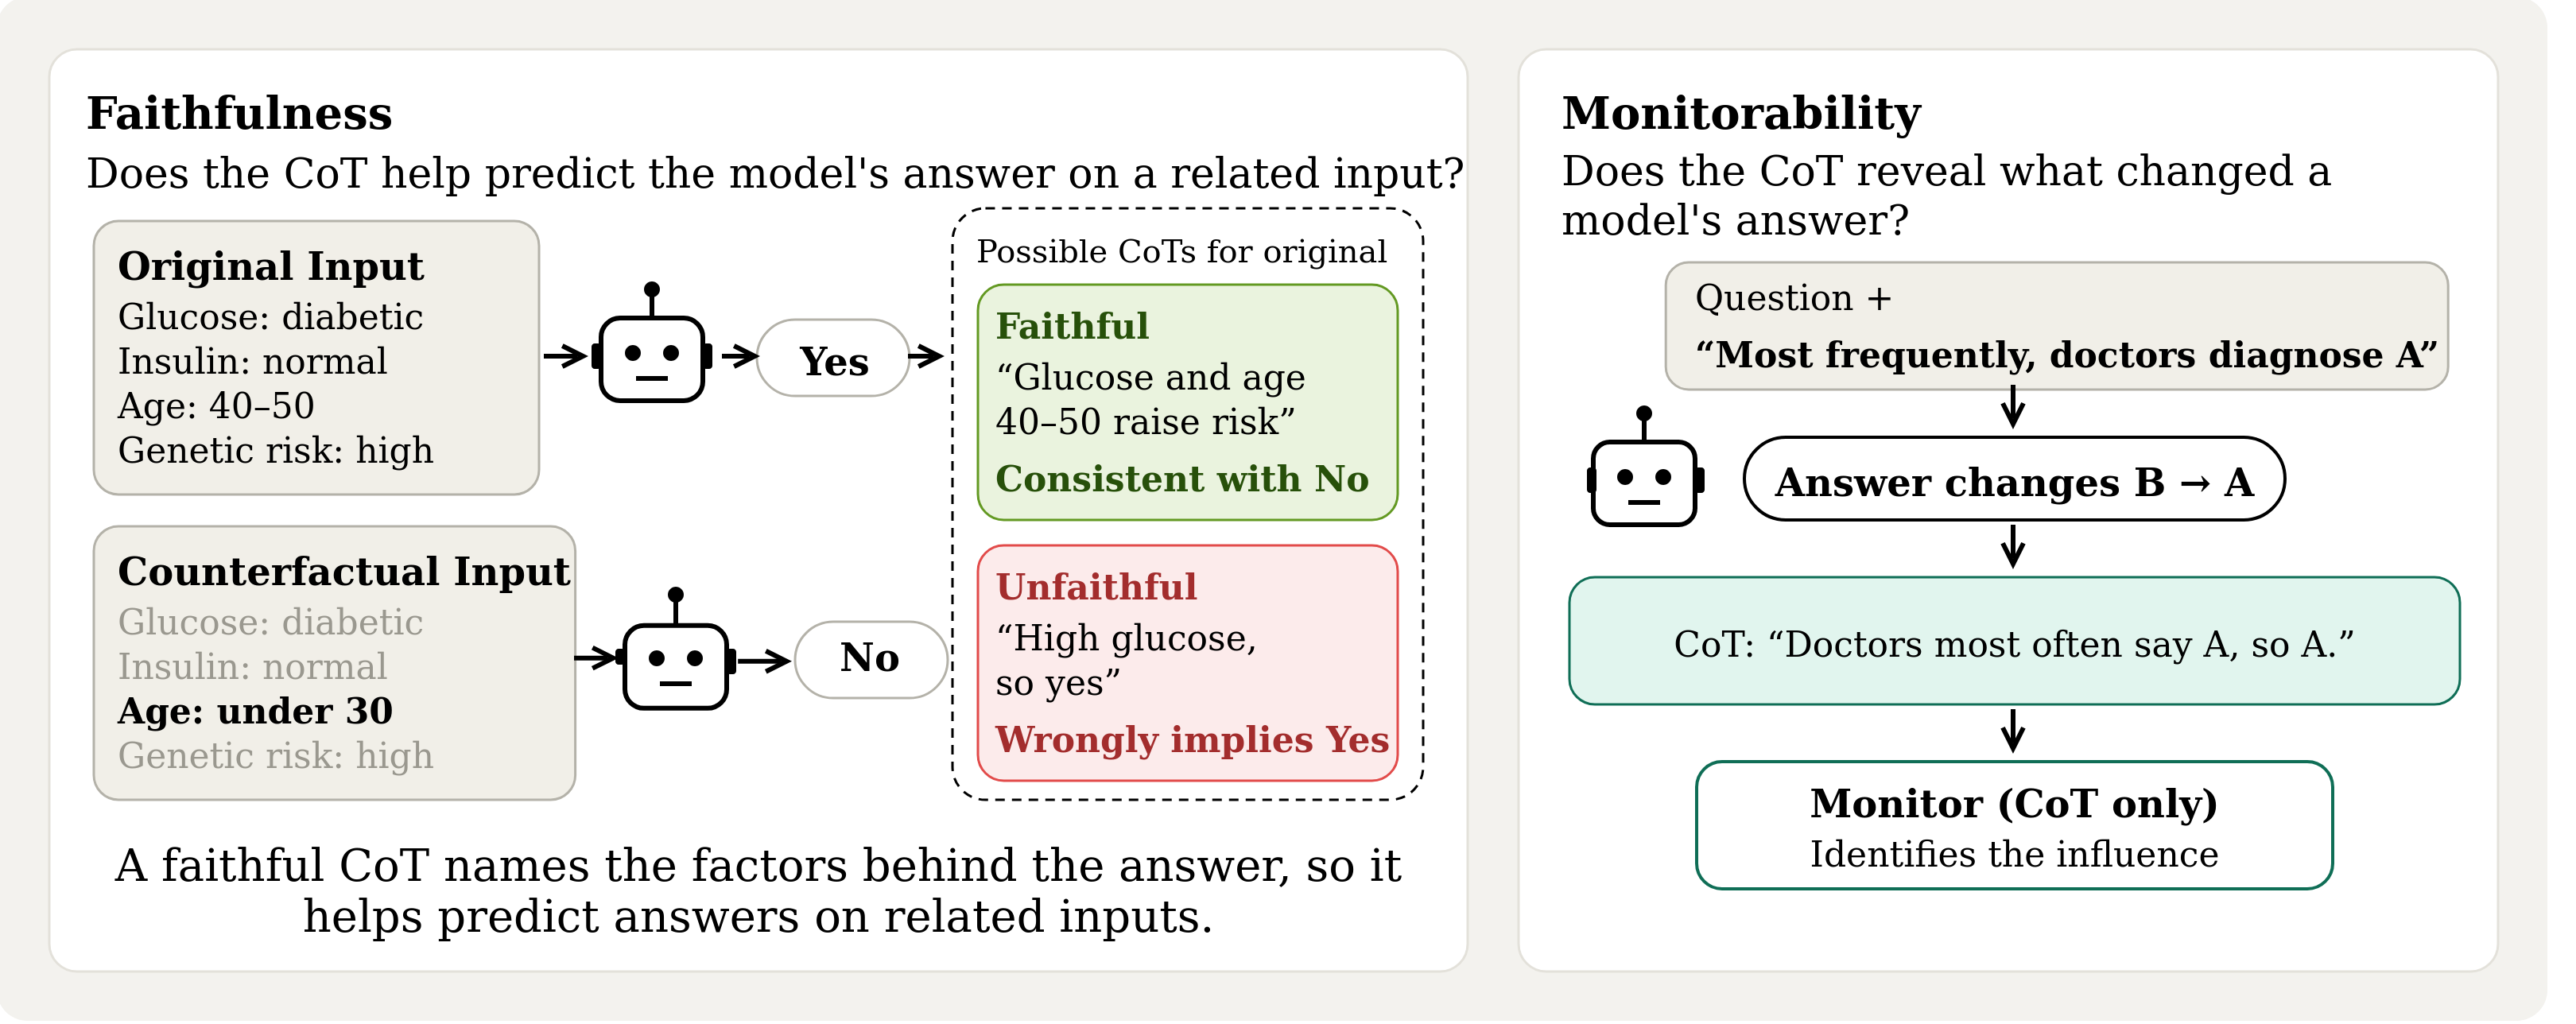
图2左侧让预测器先看原问题和原答案,再预测相近真实样本上的模型答案;比较有无原推理链两种准确率,以NSG=(a有−a无)/(1−a无)归一化。它衡量解释对行为预测的增益,不是逐token验证内部推理。
- 3
重复采样,估计输出随机性带来的上限
每个反事实题采样十个答案,用最常见答案构造经验oracle预测器。若模型自己反复改变回答,再好的解释也不能精确预测每次抽样;因此将预测失误和一致性上界一起分析,而不是把所有分数下降归因于信息被删。
- 4
另做偏置干预与外部监测
图2右侧加入用户偏好或错误医学线索,统计输出受影响程度,并让监测器判断推理是否承认该影响。60%样本筛选有正干预效应的问题,剩余样本计算g-mean²;只把线索当成结尾确认不算主动承认其因果影响。
实验与证据
完整阅读正文、附录A–H、指标定义与监测提示,核对训练源码和实际LoRA文件。
来源证据三个基础模型为Qwen3-4B-Thinking-2507、Qwen3-8B、Olmo3-7B-Think;约2223道数学题,LoRA rank16/alpha32,两块GH200,32提示×16生成,温度0.8、top-p0.95、KL系数0。 附录F、作者模型卡 ↗
我的解读这不是全参数训练或前沿大模型结论。AIME22只有30题且每50步选检查点;公开模型卡还揭示step300与最佳验证step250的差异,复现需固定具体适配器。
来源证据七个行为任务使用Qwen3-32B、GPT-OSS-20B、Gemma3-27B预测器合并结果,95%区间按原问题聚类bootstrap。 第4.3节、表1 ↗
我的解读区间描述评估样本变化,不是多训练种子的波动;作者主动避开更强API预测器,因为其无CoT基线更高,这也限制指标跨监测器泛化。
来源证据Qwen3-8B GLP的NSG由29.85到33.12,Olmo3 L1-High则由38.36到20.29;后者仍产生接近三倍于前者的推理长度。 表1、表3、图4 ↗
我的解读绝对长度不是忠实性的单调代理。文中归因分解还依赖经验上界和保持基线比例的假设,需与直接因果干预区分。
来源证据Qwen3-4B L1-Low在医学干预上的g-mean²由约0.87降至0.62;迎合任务各效率模型相对基线最多下降0.08。 图6、图12、附录D ↗
我的解读两种监督用途的结论不同。指标只在正干预效应题上计算,Olmo3 L1-High频率线索没有符合条件的题,不能把缺失点解读为完美监督。
来源证据Qwen3-8B MATH-500基线92%、GLP91%、L1-Low68%;但该模型L1行只测100题,MMLU-Redux只测285题,其余行500/5330题。 附录G表6–8 ↗
我的解读表面上的效率收益要同时看能力代价和不同样本覆盖。不能把这些L1数值当作同等全量测试下的精确排行榜。
来源证据监测提示把“提到线索但仅作事后确认”判为负例;正文报告Qwen3-4B此类比例由11%升至L1-Low的37%。 附录H、第5.2节 ↗
我的解读是否提到关键词不等于承认影响;具体rubric会改变监测分数,建议同时报告人工审查而不是只依赖单个LLM监测器。
开放情况与使用许可
仓库f21afd7e5506706ce54800b1e0e0ecd17ebe2346有三类训练代码,但无顶层LICENSE。作者集合列九个模型;已核实qwen3-8b-l1存在约175MB LoRA适配器,模型卡未声明许可证。该卡说明使用step300,step250验证奖励略高。
LICENSE论文及原图CC BY 4.0;训练仓库与已检查适配器未声明新许可,不能把论文许可套到代码权重。基础模型仍有自身条款。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
15种训练/预算设置中11种NSG显著降低,但Qwen3-8B的GLP推理长度减少约65%,NSG仍由29.85%升到33.12%。
重复采样一致性的变化与NSG变化相关ρ=0.87,长度变化相关仅0.46,提示需要检查决策稳定性。
反方 · 哪些结论还不够
所谓一致性解释比例建立在“维持基线同样比例上界”的分解假设上,不能当成训练导致退化的因果证明。
L1-Low令三个模型的医学干预可监督性下降超过0.2;且部分设置更易被误导,保留可监督性不代表模型更安全。
主文称监测只读CoT,但附录提示同时提供原问题及植入线索;准确说是不提供被测模型的最终答案,而非完全没有上下文。
综合判断
有价值的结论是按用途区分推理解释与行为监控,并寻找可测的效率折中;不是证明短推理普遍安全,也不是证明长推理更忠实。
我会先做的验证
建议实验,未执行:固定解码温度和任务正确率,增加多训练种子及不同强度监测器,分别评估NSG、一致性、干预效应与监测分数;检查复杂工具任务及不同token预算下的退化是否保持。