ELF-REG:让连续扩散语言模型同时学习局部与全局语义
自回归教师表征对齐、REG token 与提前停止采样
ELF-REG 在连续语言潜空间里去噪:用冻结自回归教师对齐逐位置表征,并加入共同去噪的全局 REG token。它减少部分任务达到目标分数所需的训练轮数,但提示编码、教师成本和评测协议必须与去噪次数分开计算。
图解主要方法
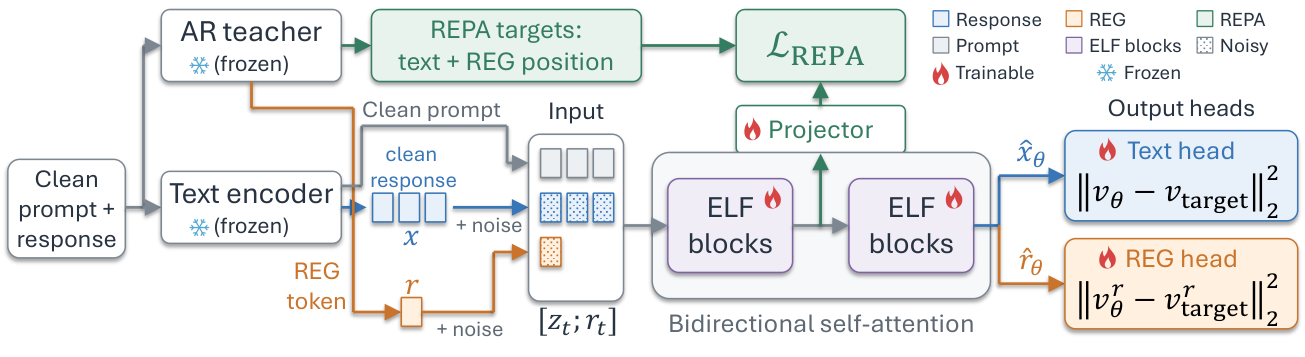
图 1(a) 的 REPA 和 REG 分别向学生传递什么监督?
- 1
冻结编码器,把回答变为连续潜表示
Qwen3-Embedding-0.6B 的第 20 层提供语言嵌入,提示保持干净,回答加入噪声。双向注意力的 ELF 学生预测连续流速度,再经文字头解码;不是按词从左到右生成。推理仍需要提示编码器,不能只用去噪器参数量描述整套成本。
- 2
REPA 对齐局部语义,REG 承载全局监督
冻结 Qwen3-1.7B 教师:第 20 层作为逐位置 REPA 目标,第 24 层最后内容 token 提供全局表示。投影器将学生中间特征对齐教师;额外 REG token 与回答一起加噪、联合去噪,通过自己的头学习全局目标。教师只用于训练。
- 3
把正则化与自条件采样结合
局部对齐损失引导中间表示,全局 REG 的速度损失与文字潜变量损失共同训练;自条件把前一步干净预测回送学生。附录移除 REG 的推理消融表明,它的作用主要可能来自训练塑形,不能仅凭存在这个 token 就断言部署时承担推理规划。
- 4
在主时间网格前段提前解码
early-stop 的比例为 8:运行 NFE−1 次去噪后,直接解码预测的干净潜变量。NFE 包括一次解码调用,却不包括提示编码器;提前停止是采样路径变化,不能把“少八倍步数”直接写成端到端快八倍。
实验与证据
以下为作者报告;已阅读 v1 全文及可用附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【同系 ELF-L 对照】GSM8K 在 64 NFE 下 51.85→55.96,MATH-500 在 128 NFE 下 10.55→13.39,HumanEval 128 NFE 下 19.66→22.56;均汇总 16 个生成种子。 表 1、2 与附录评测 ↗
我的解读我的解读:生成种子不是独立训练复现;数学、代码分别训练,不能当成同一个通用模型的三项成绩。
来源证据【训练成本】代码配置 GPU 小时 317.3→407.9,GSM8K 为 347.9→333.9;参数计数不含冻结提示编码器,任务 token 数也不含上游预训练。 预算附录 ↗
我的解读我的解读:更少任务训练 token 不必然更便宜;跨方法比较还受输出长度、数据规模和预算统计边界影响。
来源证据【机制及反例】代码第六轮 REPA-only 为 24.56,加 REG 为 28.92,推理去掉 REG 后仍 28.66;MBPP-500 pass@10 的基线 40.50 高于本方法 39.92。 REG 消融与代码评测附录 ↗
我的解读我的解读:支持 REG 的训练收益,且改进不是所有采样指标都成立。代码引导参数在 MBPP/HumanEval 调整,应关注测试集选择影响。
开放情况与使用许可
已核对匿名官方仓库根目录、评估入口、README 与 MIT LICENSE。模型库实际列出任务检查点,准备数据也有文件;模型库未提供独立许可证字段,不能将代码 MIT 自动套到权重。部分匿名源码路径访问受限,未完成逐模块实现审计。
LICENSE实现 MIT;教师、嵌入模型和各数据集沿用各自许可。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
将教师逐词表征和全局摘要作为两种独立监督,可用消融判断扩散语言模型缺少的是表征还是采样预算。
反方 · 哪些结论还不够
教师与提示编码器成本、不同模型的生成长度和代码超参数选择,使“更高效”需要限定实验口径。
综合判断
适合研究连续扩散的任务适配与早停;尚不足以证明替代通用自回归模型的总体成本优势。
我会先做的验证
未执行的验证方案:固定提示编码器、数据与输出长度,对齐端到端 GPU 小时,分别关闭 REPA、REG 和 early-stop;在未参与调参的代码题上同时报告 pass@1、pass@10、延迟和显存。