EmbodiedLab:机器人能不能亲手做出可信测量?
把操作、读数、推理和收拾实验台串成一次可核查实验
EmbodiedLab让智能体面对未知参数的实验装置,自己决定如何操作、读取和分析,覆盖30项实验与五个学科。成功不仅要求答案正确,还要有本轮真实操作产生的读数证据,并按任务要求恢复实验台。它是物理仿真实验室基准,不是真实湿实验室部署验证。
图解主要方法
把操作、读数、推理和收拾实验台串成一次可核查实验
- 1
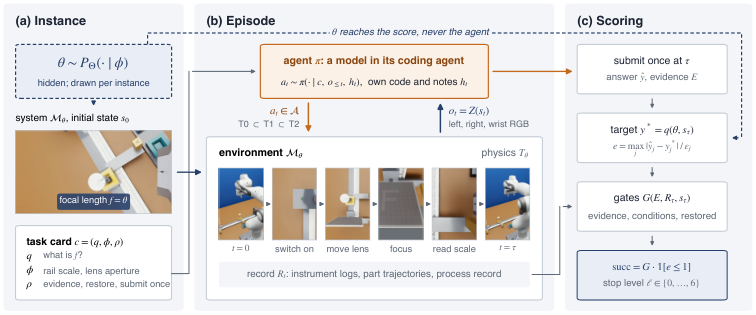
图3a:隐藏参数,防止背答案
每个实例重新采样系统参数θ,只给目标和装置说明,不给实验步骤。焦距、弹性系数等目标由隐藏物理参数决定,智能体必须制造有信息量的观察,不能直接从任务文本读取答案。
- 2
图3b:行动改变可见证据
Franka机械臂、双指夹爪和三路相机操作Isaac Sim中的14类装置。Agent通过代码控制、拍照和合法仪器接口读数,形成动作—观察闭环;记录的不只是最终数字,还有取数时的配置和过程。
- 3
图3b接口:区分模型本领和工具帮助
T0提供关节、逆运动学及RGB观察;T1加入分割、毫米级特权深度和掌握真实地图的运动规划;T2再提供从强模型轨迹提炼的技能。T2来自同类实验示范,属于诊断辅助,不应把提升算成纯零样本科学能力。
- 4
图3c:答案、证据和收尾共同过关
只能提交一次,答案需关联本轮记录ID,满足有效读数、实验条件、拟合与仪器容差,并恢复指定台面状态。L1至L6分别定位操作、搭建、首次读数、充分证据、正确结果及恢复,便于辨别失败发生在哪一步。
实验与证据
已阅读正文及附录A–F,核对实验条件与原图;未独立复现。
来源证据T0下Opus为43.3%,Astra为40.0%,Sol为28.3%;T1后前两者为53.3%、46.7%。各模型使用自身编码运行框架。 主结果:30任务、六种智能体系统 ↗
我的解读比较的是模型加工具框架的系统,不是隔离模型能力;T1还增加特权几何信息。
来源证据最强系统达到正确知识结果的比例约51.7%–55%,但完成率更低;Sol有23%运行答案正确却未恢复实验台。 阶段分析:答案正确仍可能失败 ↗
我的解读完整实验流程比问答难,收尾要求会显著影响排名,不能仅用最终分数推断科学推理优劣。
来源证据T2下DeepSeek从T1的13.3%升到40%,Kimi从20%升到33.3%;错误归因中操作、观察与恢复合计占75%–100%。 辅助和失败归因 ↗
我的解读技能帮助主要消除执行瓶颈。归因按最早决定性错误,不能读成所有错误互相独立或真实实验室也有相同比例。
来源证据公开README逐项列出容差、模拟时间和墙钟预算;例如单摆容差0.3%、模拟200秒,部分实验容差用纳米而非百分比。 协议与官方实现 ↗
我的解读不是统一容差或统一耗时考试;光学、化学等仍由仿真模型定义,真实传感噪声和材料差异有待验证。
开放情况与使用许可
官方仓库含experiments、sdk、services和运行脚本,代码Apache-2.0;Isaac Sim及第三方资产依其各自许可。已阅读实际文件清单与README,未启动GPU仿真。
LICENSE论文与所引原图:CC BY 4.0
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
我的判断:把“获得知识”拆成主动制造证据、正确解读及可复查的提交,能暴露语言回答基准看不到的具身瓶颈。
反方 · 哪些结论还不够
仿真采用理想化物理与装置模型,工具层级中存在特权信息;同任务提炼技能可能高估跨实验迁移。没有充分证据说明高分能转成真实实验室自主科研。
综合判断
适合诊断科学智能体的操作与测量链路;应同时报告接口层级、阶段分数和时间预算,而非只比较模型名。
我会先做的验证
未执行的验证方案:选焦距、弹性与电路三类实验,固定T0接口与运行框架,多次重采样参数和噪声;用真实装置小样本复核读数偏差,分别报告知识结果、证据有效性及复位成功率。