EMem-Bench:机器人记忆要保留什么、覆盖什么、何时检索
场景、最新空间状态与事件经验的三层记忆
EMem-Bench 用 2554 个仿真任务检验历史信息是否真正支持后续操作,并提供三层记忆系统 EMem。关键不只是存得更多,而是区分场景身份、可覆盖的当前状态和需保留顺序的历史事件,再按当前任务取回。
图解主要方法
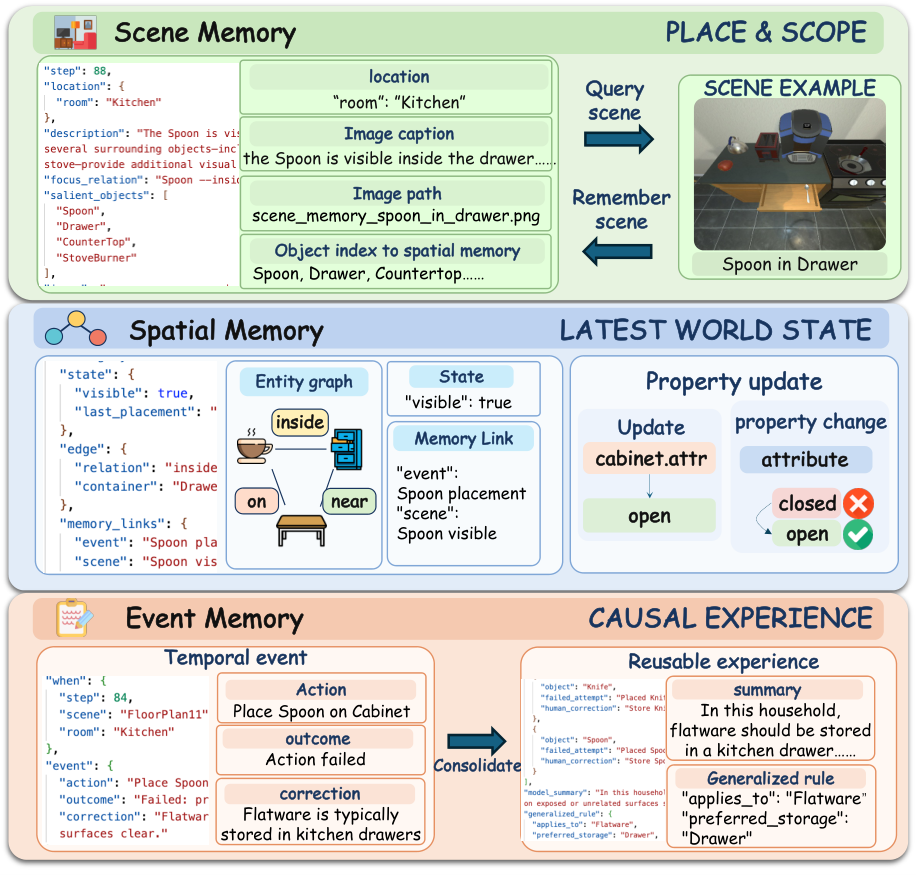
图 6 为什么把同一段经历写入三种不同的记忆?
- 1
场景层保留身份与可见细节
场景记忆以地点和作用域组织描述、对象及可用图像,帮助之后找回只在早期见过的外观与位置线索。历史按发生顺序写入,构建时不使用未来目标问题,避免答案反向指导该记住什么。
- 2
空间层覆盖过时关系
空间记忆记录对象属性和最新关系,例如柜门由关变开、勺子从抽屉移到桌上;互斥旧状态被新证据替换。它表示最新已知状态,不是无噪声的真实世界数据库,误识别或漏观察仍可造成错误覆盖。
- 3
事件层保留经过,并谨慎合成经验
事件记录动作、结果和纠正关系,不用后来的状态抹掉事件发生过的事实。至少两个纠正证据才能合并成可复用经验;图中的“典型存放位置”属于从交互中归纳的规则,不是每次动作都能直接套用的硬约束。
- 4
分级检索后生成短动作序列
检索先匹配结构字段,再词汇、最后语义回退,最多返回 12 条记录。EMem 一次可规划最多八个原子动作,再结合反馈写回记忆;对照基线每次通常只输出一个原子动作,规划粒度差异必须与记忆收益一起审视。
实验与证据
以下为作者报告;已阅读 v1 全文及可用附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【完整基准】2554 任务分为 1036/1052/263/203 四类,平均成功率按四类等权;GPT-5.4-mini 35.3→58.9,分别去掉三类记忆后为 47.9/46.9/47.3。 主结果及记忆消融 ↗
我的解读我的解读:消融支持三类记录互补,但总平均不是全部任务直接混算;序列规划和历史视觉输入也与部分基线不同。
来源证据【800 个匹配任务子集】直接增加历史图像后平均成功率 36.6→26.2,输入 token 41770→206489,每步耗时 4.1→39.1 秒,不含渲染。 历史视觉消融 ↗
我的解读我的解读:在此输入与模型组合中,更多图像带来干扰和成本;不能推导所有长上下文记忆都无效。
来源证据【8B 训练】Qwen 8B 从 25.4 到加 EMem 的 36.2,再到训练后的 46.0;LoRA r=4、alpha=8、单轮,1816 优化步,轨迹划分 77/8/8。 训练附录 ↗
我的解读我的解读:8852 个训练对话轮不等于同数独立场景;这是记忆工具使用的监督适配,未证实真实机器人迁移。
来源证据【错误复发率】ERR 针对规定触发条件下、已经成功绑定的错误动作测复发,非法动作不计;标准 K=1 时为任务级二元事件。 指标定义附录 ↗
我的解读我的解读:ERR 的特殊分母使它不能与全部动作的错误频率混用,应与成功率共同阅读。
开放情况与使用许可
已确认官方仓库包含记忆、任务构建和评估源文件;Hugging Face 有 2554 条任务清单及真实观测文件。代码与数据分开授权,公开资源不等于全部 API 基线可离线复现。
LICENSE代码 Apache 2.0(独立 embodied_memory/LICENSE);数据卡标为 CC BY-NC 4.0,含非商业限制。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
将历史事实、当前状态和可泛化经验分开,能够直接定位机器人究竟忘了什么或更新错了什么。
反方 · 哪些结论还不够
仿真环境、动作粒度及历史视觉条件限制归因;无真实机器人试验,记忆内容本身也可能错误。
综合判断
可用作记忆模块的可重复压力测试,迁入机器人前需先验证时间戳、实体身份和状态覆盖规则。
我会先做的验证
未执行的验证方案:保持每次调用可输出动作数和视觉历史一致,比较全历史、单库检索及三层记忆;注入对象改名、搬移与误观测,测成功率、陈旧状态使用率和检索成本。