Exact Feedback:检查器说对了,不代表语言模型改得对
把多轮修订作为控制过程,观察重复、停滞与重置
这项研究用可以精确验算的字数、词汇与组合约束,观察模型收到正确反馈后如何修改。它不仅看最后有没有成功,还追踪重复输出和纠错方向:外部检查器能定位错误,不等于模型能够稳定执行对应修改。
图解主要方法
图 2 的生成—验算—修订循环如何区分检查失败与控制失败?
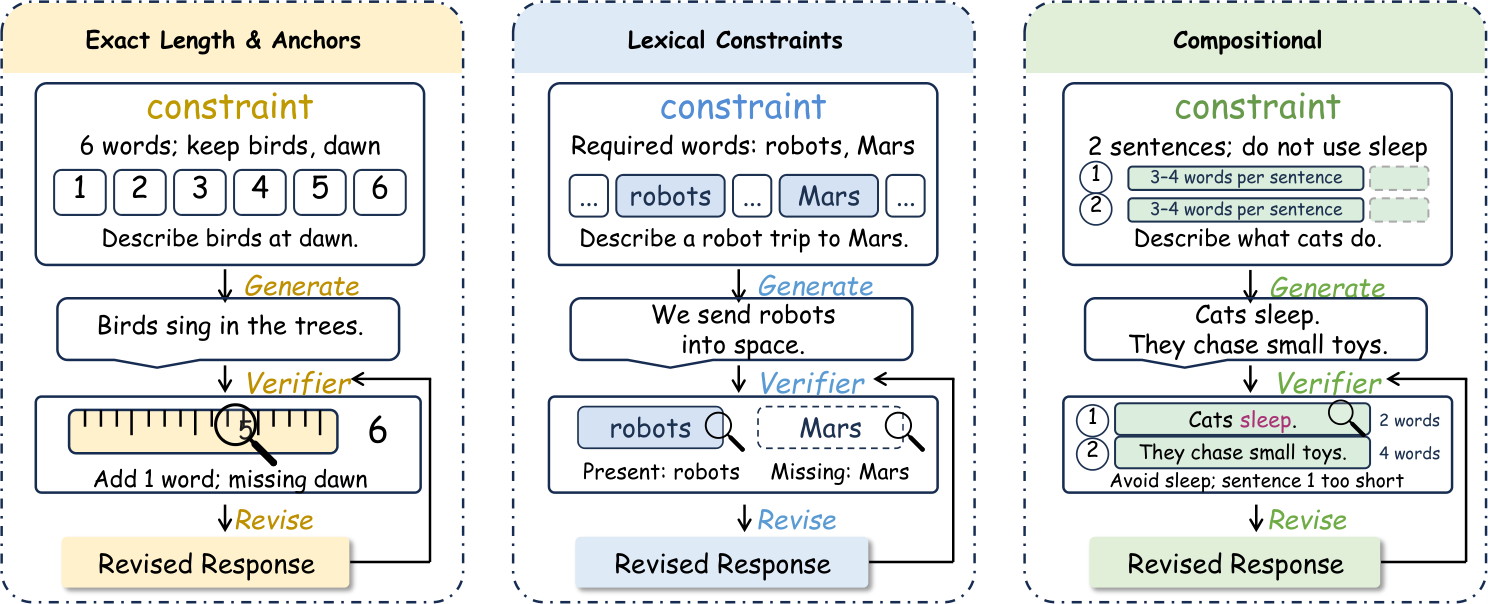
- 1
先定义可执行的文本契约
三类任务分别要求精确长度且保留锚词、包含/排除指定词,以及句数、句长和词汇的组合条件。确定性验证器给出违反条件与差额;锚词只约束最低内容保留,不证明改写后的语义完整或文章质量。
- 2
保留整条修订轨迹,而非只看终点
让同一控制器在最多八轮内接收准确反馈,记录当前误差、下一步修改和最终联合成功率。逐轮按 UTF-8 字节判断是否完全重复;这比“字数没变”严格,也可区分循环停滞与方向错误。
- 3
用固定初稿与请求差额做行为探针
固定初稿交叉实验减少初次生成难度的影响,再在不同实际/请求改动量上观察中位响应。24 个发现样本、48 个确认样本与纠错网格分开使用;规律可重复并不代表每次修改准确。
- 4
在同一失败状态试重置与机制干预
重置上下文、改变历史和有限表征干预分别测试能否逃离重复。模型检查点与调用接口一起构成控制器,不能把原生接口之间的差距仅归于权重;探针关联也不自动成为注意力或激活机制的因果解释。
实验与证据
以下为作者报告;已阅读 v1 全文及可用附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【主实验】19 个控制器、三类各 480 任务、八轮设置共尝试 27360 条轨迹;一个 API 拒绝案例在对应配对分析中形成 479 个共同样本。 主结果与配对协议 ↗
我的解读我的解读:实验规模是任务轨迹数,不是相互独立的训练运行;拒绝与缺失的分母要按比较重新对齐。
来源证据【重复后的失败】不同模型已失败且已出现重复的条件子集中,重复复发率报告为 84.8%、78.7%、90.2%。 重复状态分析 ↗
我的解读我的解读:这是条件风险,不能写成模型全部输出有九成重复;反馈正确也无法自行打破既有循环。
来源证据【重置的有限收益】选定 83 个 Llama 失败状态与 120 个 GLM 失败状态,最终成功分别由 9/83 到 18/83、4/120 到 10/120。 重置与扩展轮数实验 ↗
我的解读我的解读:逃离原字符串不等于完成全部约束;延长至 32 轮的选定 144 个失败案例仅 12 个成功,另有 19 个触及上下文限制。
开放情况与使用许可
官方仓库确有复现实验、输入和分析代码;RELEASE_STATUS 明确排除原实验输出与证据归档,完整离线重分析依赖另供 evidence。未找到本项目顶层许可证,第三方 notices 不能替代原创代码授权。
LICENSE代码可查看,但原创代码许可未确认;论文 CC BY 4.0 不自动授权代码。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
可验算任务排除了模糊评价器的主要干扰,让“看懂反馈”与“按反馈修正”成为可独立测量的能力。
反方 · 哪些结论还不够
约束文本不是一般写作质量;失败状态重置的选择性样本及接口差异限制跨模型因果归因。
综合判断
对依赖检查器反复返工的智能体很有参考价值,应设置停滞检测和可解释的退出条件,而非只增加轮数。
我会先做的验证
未执行的验证方案:固定初稿、验证器和调用接口,对比累积历史、有限窗口与重置;预注册停滞判定,按全部任务和触发子集分别报告成功、语义保留、调用次数与重复率。