EAPN:让机器人重规划的随机噪声跟着实际执行进度走
跨动作块保留相关性,减少反复换策略;它需要训练,且真机领先只有少量试次
异步动作块生成时,即使前缀接得上,每次重新抽噪声仍可能让后半段切换到另一种行为。EAPN用跨调用共享、按实际执行步数平移的随机轨迹,加上块内时间相关噪声和历史条件,帮助新动作块延续当前模式。
图解主要方法
异步重规划怎样同时保持动作前缀与随机行为模式的时间一致性?
- 1
保留已承诺的动作前缀
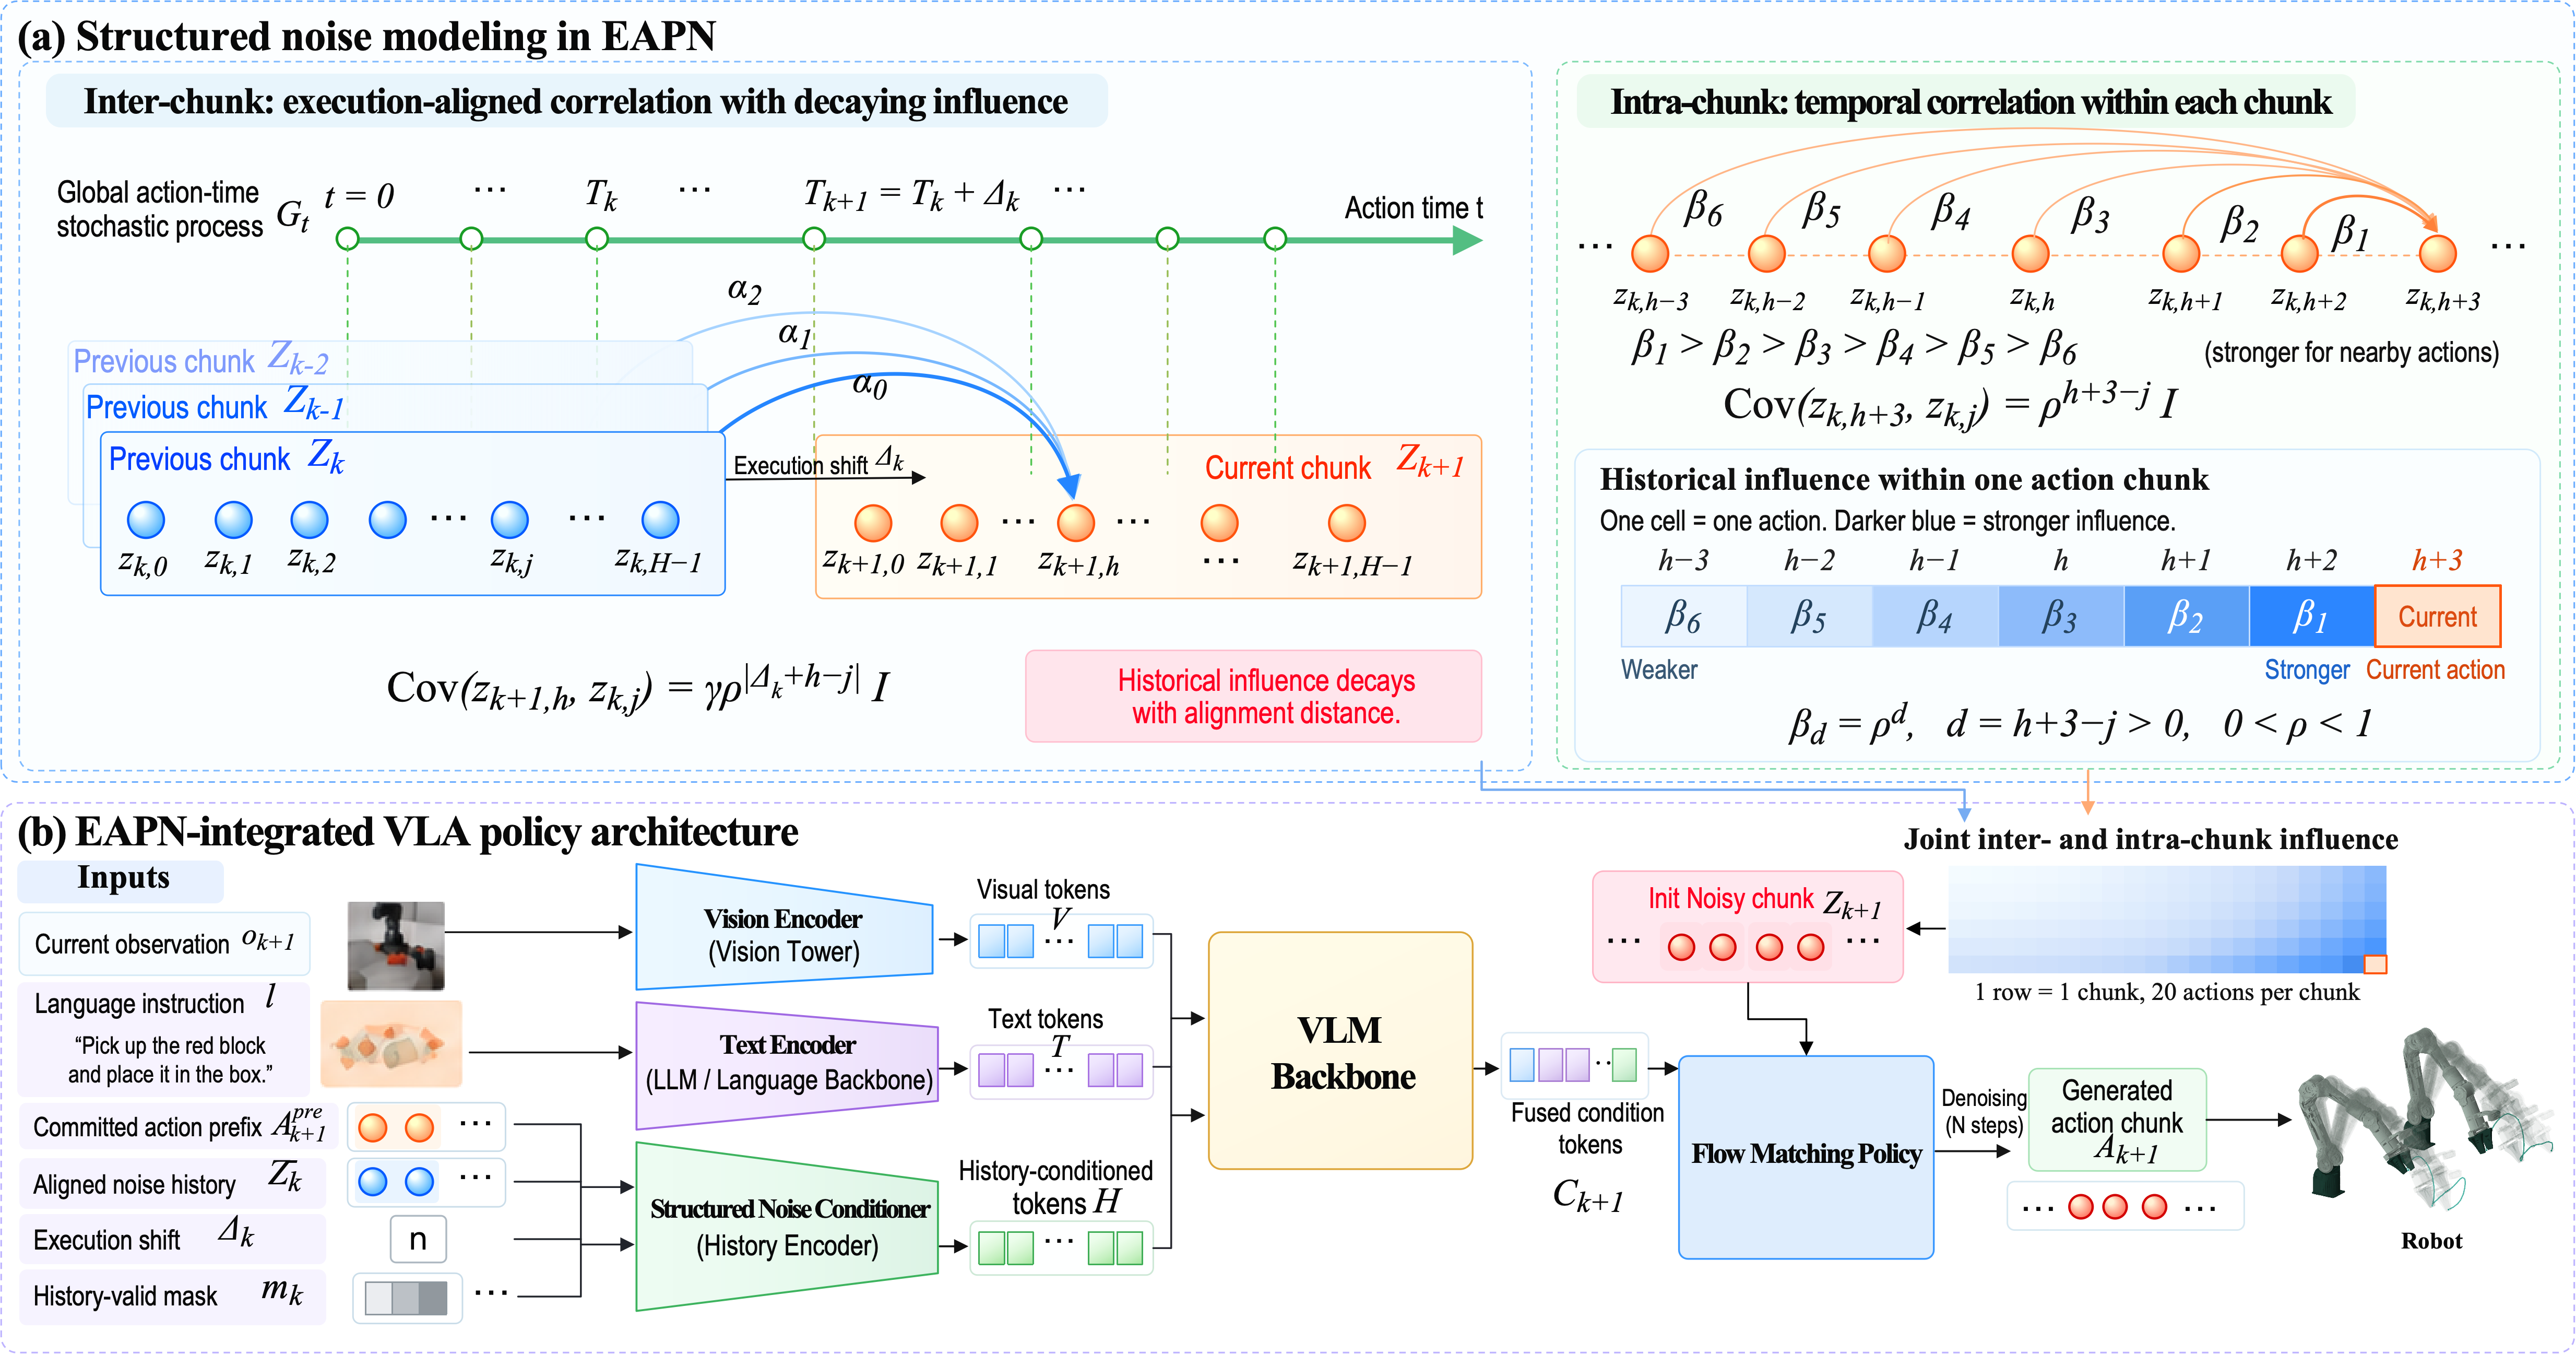
图2下方沿用训练时RTC:推理期间机器人继续消耗旧缓存,新块前D步固定,只对后续动作生成。D描述当前延迟/固定前缀长度,Δ描述两次窗口之间实际执行了多少步,二者不必相等。
- 2
沿物理动作时间传播共享噪声
图2左上用持续AR(1)过程G表示跨调用随机轨迹,每次按实际Δ推进;另建当前窗口私有AR(1)过程U。以√γG+√(1−γ)U混合,ρ控制时间衰减,相关性在实际对齐位置而非同token下标最强。
- 3
将历史噪声显式编码为条件
把上次噪声移到当前时间窗口,连同Δ、D和历史有效掩码送入历史编码器,每个流步骤读取这一条件。没有历史对应的位置不能冒充有效;episode开始需清空动作与噪声历史。
- 4
联合训练结构化噪声与后缀流
训练采样延迟和位移,构造共享过程下的相邻噪声;随机丢弃整个历史以适应首次推理。只在未承诺后缀上拟合动作减噪声的流速度。单token仍服从标准高斯,但联合协方差改变,所以不能视为无训练采样插件。
- 5
异步执行后记录真实消费量
生成结束保存当前随机状态;下一轮用缓存真实消费步数推进,而非假设固定延迟。结构化随机性保留一定创新,但应另测目标突然改变时是否过度坚持旧模式。
实验与证据
完整阅读37437字符公开全文及参考文献,无附录;视检图2并打开官方项目页。未运行策略、模拟或真机试验。
来源证据π0.5的16条留出轨迹逆推噪声,同episode余弦均值0.774、跨episode0.043;观测间隔5→45帧时相似度0.855→0.378。 图1、图3 ↗
我的解读显示局部时间结构,不能隔离重叠输入及动作对相关性的影响,也不是直接因果证明。
来源证据D3IL Avoiding:DDPM-ACT351/480成功,EAPN379/480;73.13%→78.96%,MSR3.969%→3.167%,Switch Gap0.001913→0.001672。 表I ↗
我的解读成功率增加5.83个百分点;MSR只计同障碍阶段可分类的相邻重规划对,不含正常阶段推进。
来源证据Kinetix mjc_swimmer:ttRTC46.60%,加跨块噪声76.89%,再加块内噪声78.85%,完整79.26%。 表II ↗
我的解读主要贡献是跨块相关;完整模型的Switch Gap1.55略高于无完整历史条件版本1.54,不能声称所有连续性指标最优。
来源证据LIBERO低延迟K5、D1至4,EAPN均值96.4–97.0%;D4为96.6%,ttRTC92.2%。高延迟K25另行训练,D5为88.3%低于ttRTC89.8%,D15为75%高于73%。 表III–IV ↗
我的解读这是两组独立训练协议,不是同一模型从D1到D15的一条延迟曲线;增益随任务和延迟变化。
来源证据Object Storage用216训练episode,20次60秒测试:EAPN18/20,VLASH17/20,ttRTC16/20。 表V ↗
我的解读领先VLASH5个百分点但只有一次成功差异,样本规模不能支持稳健显著性的强断言。
来源证据双臂叠衣用3056训练episode,3种衣服各10次,限3分钟:EAPN29/30、VLASH28/30;一个示例33秒对56秒。 第IV-F节、图6 ↗
我的解读衣服覆盖有限,示例时间不是全测试平均耗时;不把个案速度提升推广为普遍加速。
来源证据项目页标注AgileX-Piper,并给D20、K25两个同任务同种子视频实例,记录jerk下降21.4%和15.1%。 官方项目页 ↗
我的解读只是两条代表性轨迹;本轮读取网页与说明,没有据此声称独立测量了视频或复现总体jerk分布。
开放情况与使用许可
官方项目页有方法、定量表和视频入口,未提供训练代码或模型权重下载;本轮未核实可运行实现。演示页面公开不等于策略开源。
LICENSE论文为arXiv非独占托管许可。原图2仅作必要方法评论,版权归作者;实现和权重许可未核实。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
D3IL在相同初始条件的480次测试中同时改善成功率、模式切换和动作衔接间距,支持相关噪声的连续性动机。
Kinetix消融显示跨块噪声带来主要收益,LIBERO大延迟及两项真机任务提供了不同环境的证据。
反方 · 哪些结论还不够
完整EAPN并非所有指标最佳:LIBERO高延迟D5低于ttRTC,低延迟Long任务也有退步,不能写成全面优于。
真机比VLASH分别只多1次成功,33秒对56秒是一个视频片段,不是平均时延或统计显著加速。
从16条轨迹逆推噪声的相关性是观察性动机,重叠动作和观测本身也相关;不能据此证明噪声独立采样就是全部失败原因。
综合判断
把执行对齐扩展到随机状态是清晰且有实验支撑的改进方向;当前证据支持特定训练与延迟范围中的连续性收益。仍需完整参数、重复种子以及环境突然变化时的响应测试。
我会先做的验证
建议实验,未执行:固定同一策略和训练预算,分别消融跨块相关、块内相关及历史编码器,在随机推理延迟和突然改变目标/障碍的场景测试成功率、模式切换、反应时间和jerk,报告跨种子区间并检查历史重置失败。