FAITH:安全已不可行时,让机器人减少预计伤害
把安全过滤与任务奖励分开训练;实测安全率不构成形式化保证
FAITH学习状态—动作的峰值伤害价值,用前馈残差网络代替在线投影,再让PPO在过滤后的环境中优化原任务回报。没有动作满足学到的安全条件时,同一过滤器转而优先减少预测峰值伤害。
图解主要方法
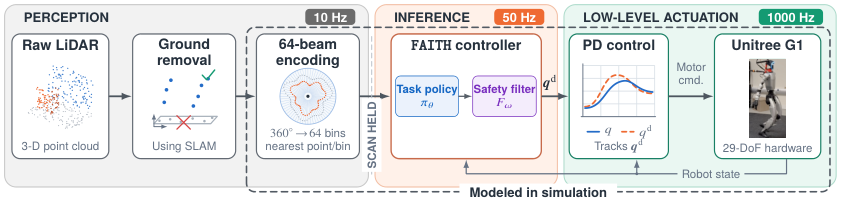
图6的10Hz、50Hz和1000Hz分别控制什么,为何仿真安全率不能直接外推?
- 1
学习未来最坏伤害
安全critic估计采取动作后未来峰值伤害,backup actor近似寻找低伤害后续动作,为Bellman目标提供候选。训练保留危险及边界转移,折扣与函数近似意味着Q≤0只是经验接受条件。
- 2
把在线投影摊销到残差网络
名义动作加网络残差后裁剪到动作范围。损失包含偏移平方与安全违反的hinge惩罚;所有动作都不合格时,惩罚项持续激活,较大lambda优先最小化预测伤害,而不是调用另一套救援策略。
- 3
让PPO适应过滤后的动力学
执行动作由过滤器决定,PPO仍用名义动作的似然比及过滤轨迹回报更新;安全学习在其他模块中进行。backup轨迹进回放而不进入PPO更新,避免把不同策略的数据混当同策略样本。
- 4
把真实感知节拍纳入边界
图6显示10Hz激光经地面移除和64方向分箱输入控制器,扫描间保持观测;50Hz策略与过滤器输出关节目标,1000Hz PD跟踪。仿真训练覆盖的模块不等于对这些真实延迟已做统计验证。
实验与证据
已阅读v1完整正文及其公开附录、核对作者实验与必要原图;未独立复现实验。
来源证据Walking-Avoid在4096条轨迹上安全率99.95%,回报2365±345;无过滤为80.37%、2428±288。 表I / §V-C ↗
我的解读约保留97%回报是该仿真条件下的比较,标准差为episode层面,不能当作跨训练种子置信区间。
来源证据Push-Avoid安全率85.45%,回报80.0±104.9,共同失败子集峰值侵入0.153±0.184。 表II / §VII局限 ↗
我的解读更安全伴随回报下降与主动倒离保护区;区域侵入不是人员伤害量化。
开放情况与使用许可
已核对论文完整实现描述;本次未核实可下载训练代码或权重,不标开源。硬件结果为定性演示。
LICENSE论文及图6使用arXiv非独占托管许可,版权归作者;未核实代码/权重许可。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
双积分器提供解析可行集对照,去过滤动力学和去backup回放消融支持模块设计。
反方 · 哪些结论还不够
理论等价依赖完美过滤器与全局优化;部署网络不满足这些假设。推挤实验共同失败子集也不等于已证明物理不可行集。
综合判断
适合作为高维安全策略的经验研究;主要价值是训练结构与失败处理,不能据此承诺人机共处安全。
我会先做的验证
未执行的验证方案:加入激光噪声、100–300ms延迟和移动保护区,比较同预算PPO、过滤器和解析简化模型;单列跌倒冲击、侵入与任务回报。