FlashDexRetarget:让多段人手示范共享训练,批量生成灵巧手轨迹
成功数字统计训练中曾经通过的轨迹;两种手分别训练,实机展示是轨迹回放而非闭环策略部署
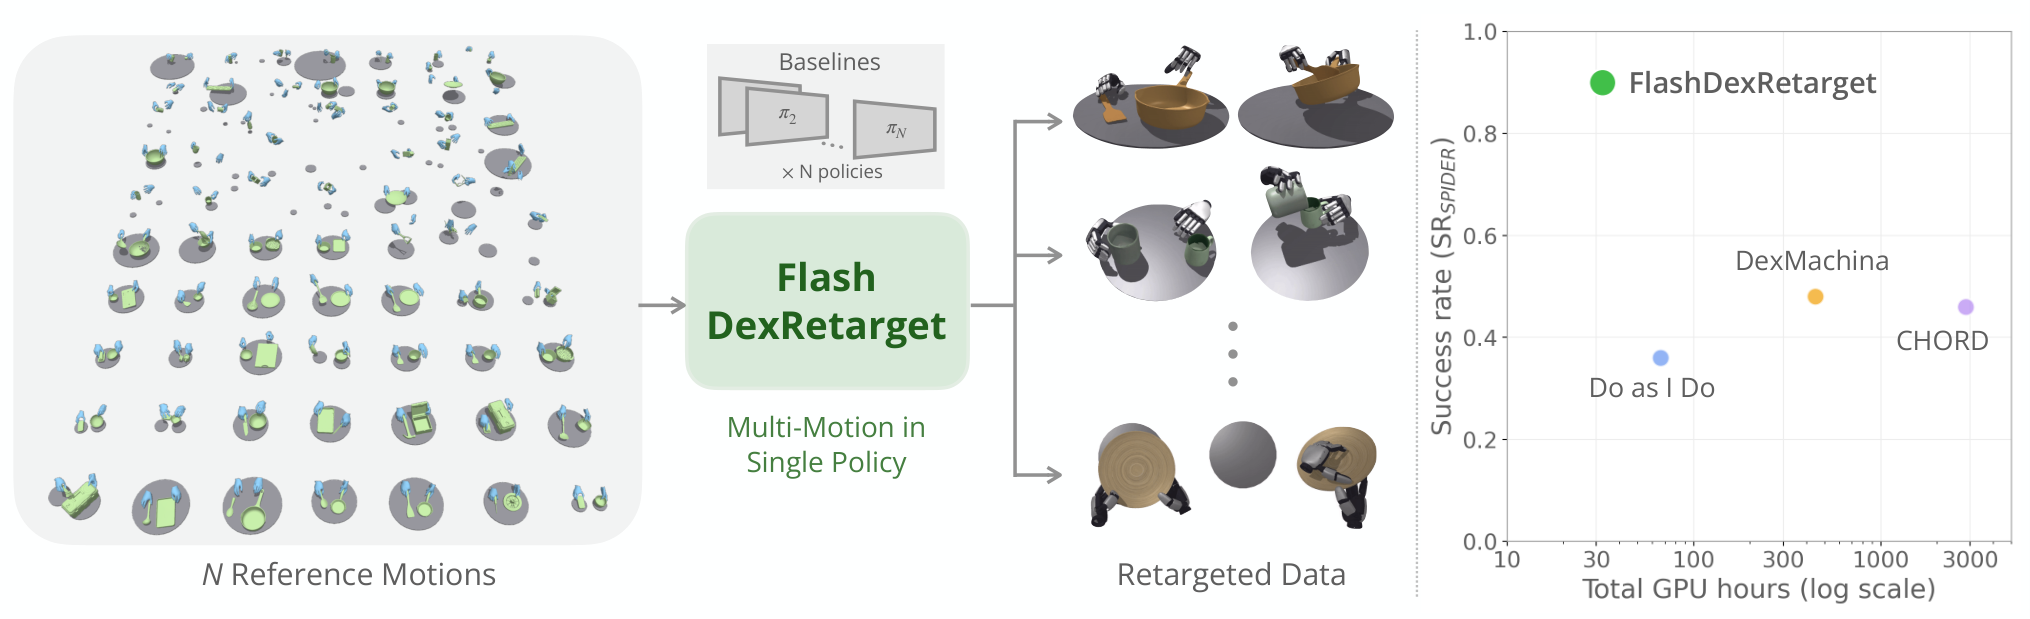
FlashDexRetarget把逐动作优化改为多参考联合训练,以物体表面、手物距离、未来10帧和分手奖励配合FlashSAC复用经验。新版论文中XHand以29 GPU小时收集到90%的宽松指标成功轨迹,Sharpa以44小时达86%。这些是已见参考的累计转化率,不是新动作泛化或最后检查点的稳定执行率。
图解主要方法
把许多示范一起学习,能否以更少总计算生产更多物理可行的灵巧手轨迹?
- 1
多参考分配给并行环境
同一套参考条件策略在多条人手—物体示范上联合训练,每步看到当前模拟状态和未来参考;目标手不同分别训练,不是一个策略跨手直接通用。
- 2
用几何与未来窗口描述交互
在腕坐标系输入当前及参考物体128表面点,附指尖与手腕到物体的距离和法线。SDF预计算在边长60cm的128³网格;未来10帧经共同训练编码器形成128维表示。
- 3
用连续表面和距离奖励替代硬接触标签
表面点归一到半径0.058m,比较当前与参考变换后最差3点位移,统一平移与旋转量纲。机器人有符号距离只在大于人手无符号参考距离时受罚,允许闭合重建空隙;另加手跟踪、模仿和动作正则。
- 4
双手各自学习但共享全局观测
左右手各有演员和评论家,用各自物体与手奖励,双方仍读完整双手状态,只输出本手动作;物理交互把它们耦合,不是独立单手问题。
- 5
离策略复用经验并存档首个成功轨迹
FlashSAC回放由1000万增至5000万,评论家宽度256增至1024。周期性从每条参考首帧评估,首次满足门槛的轨迹存档;统计是整个训练期间累计产出的数据。
实验与证据
读完v1全文与v2完整方法、结果和修订差异;以10月4日v2为准。图1核验,当前项目、实际训练代码、MIT和详细训练指南交叉核对。
来源证据50参考:25单物体、25双物体,来自TACO、OakInk2、HOT3D,排除静止无操作片段;RTX3090仿真。 IV.A;训练指南 ↗
我的解读训练和转化评测使用同一参考集合,衡量优化生产率,不是测试集泛化率。
来源证据v2 XHand:3亿步、29 GPU小时,SPIDER90%、严格MT86%;CHORD46%、0%、2847小时。 表I;IV.B ↗
我的解读近100倍是2847/29及不同完整系统比较;CHORD采用公开PPO实现,DexMachina另改随机状态初始化。
来源证据v2 Sharpa:4亿步、44小时,SPIDER86%、MT80%;旧v1为3亿步33小时、72%与70%。 v1/v2表I;当前项目 ↗
我的解读新版预算增加,不能写成同预算纯性能改进;当前项目已更新,旧项目页仍保留旧数值。
来源证据SPIDER用10cm/0.5rad并跨活动手物体平均;MT物体3cm/30°,另加指尖6cm、指节8cm。 IV.A;指南Evaluation ↗
我的解读宽松标准可能被另一静止物体稀释;公开指南还注明时间平均误差、最差手,非每个时间点都必须达标。
来源证据MOPE/MORE仅在SPIDER成功轨迹计算;XHand10.95mm、0.25rad,CHORD55.70mm、0.16rad。 表I ↗
我的解读样本集合不同,且旋转误差并未全面领先;不可将条件均值当所有尝试质量。
来源证据同3亿步消融:PPO近零、默认FlashSAC约34%、增回放约60%、再增评论家86%。 图3;IV.C ↗
我的解读支持经验复用与容量组合;几何和交互消融同时删除观测与奖励,不能拆成单独奖励贡献。
来源证据200、500、1000参考均训练6亿步,v2图5比较前60 GPU小时累计转化数量。 图5;IV.D ↗
我的解读更多参考带来更多绝对成功条数,不必然代表成功比例增长,也未证明新动作无需训练。
来源证据实机演示擦板、倾倒、合盖,项目明确为选中轨迹回放。 图4;IV.E ↗
我的解读没有报告重复试验成功率;使用未来参考与特权仿真状态的训练策略尚未直接闭环部署。
来源证据发布指南默认5亿步、全GPU约110GB,CPU回放约16GB显存及100GB内存。 仓库训练指南 ↗
我的解读默认参数与论文3亿/4亿步不同;复现需要显式配置预算与缓存位置,不能把24GB显卡等同默认可直接运行。
开放情况与使用许可
当前Holiday-Robot仓库公开训练器、双手网络、环境奖励、重定向、评测及机器人模型文件;旧davian项目仍写代码待发,当前链接已有真实实现。原动作集与MANO不分发,未确认预训练策略检查点包。
LICENSE主代码MIT;机器人模型和外部动作数据、MANO依各自条款。论文及图1为CC BY 4.0,原图保留署名与出处。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
两种目标手均优于所列逐参考基线,包含失败运行的GPU小时,较符合数据生产成本比较。
更严格的物体加手跟踪指标仍有优势,避免只依赖跨物体平均误差形成的宽松成功。
训练与成功轨迹归档代码实际公开,指南明确时间平均、最差手和累计首次通过,便于审查指标。
反方 · 哪些结论还不够
联合训练同时换算法、观测、奖励和模型容量,100倍差距是整套系统对指定CHORD实现,不是单一贡献的因果量。
成功一旦存档就一直计入,不保证最终策略仍会执行,也不测试参考外新动作。
距离奖励只惩罚比参考更远,负SDF也满足最高奖励;不能单靠此项证明无穿透或正确接触力。
综合判断
有说服力的多参考仿真轨迹生产方案,尤其适合摊销数据转化成本;尚不能据此认定通用灵巧手策略或可靠实机闭环控制已经解决。
我会先做的验证
建议实验(尚未执行):固定参考划分和总计算,报告累计成功、最终检查点重复成功、未见动作三者;匹配双手网络参数量,分开消融观测与奖励,并测穿透、接触力、CPU回放成本及实机重复抗扰结果。