FLEX-WAM:让机器人世界动作模型真正响应动作,而非只续写流畅视频
随机分块因果注意力与动作敏感度反馈;80%规划成功只在想象中验收
FLEX-WAM用一个联合流模型生成状态和动作,通过可变块大小支持逐帧低延迟或整块高吞吐。训练先学动作条件动力学,再用梯度校准和动作敏感度反馈保住模拟能力;机器人案例展示预测与现实不符的样本收集,尚未证明闭环执行想象计划或持续学习收益。
图解主要方法
联合生成状态和动作时,怎样防止模型忽略动作并保留低延迟推断?
- 1
多相机先压入共享潜变量
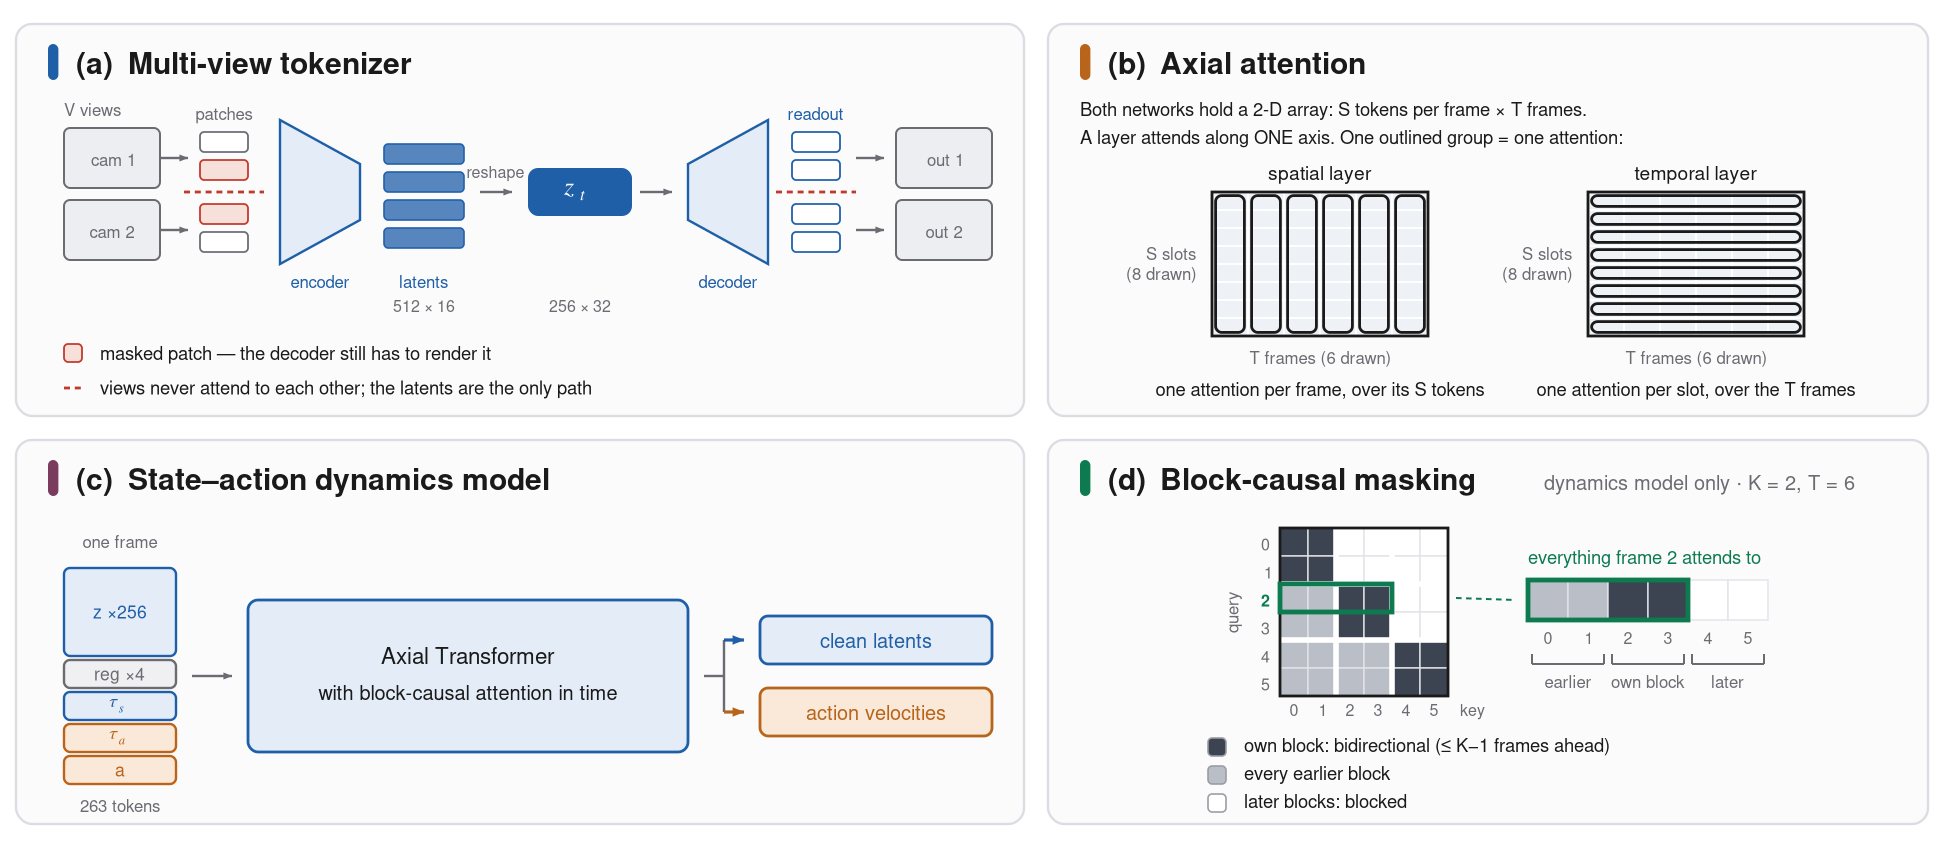
图1(a)的各相机token不能直接互相注意,信息必须经过每帧共享潜变量。掩码自编码器学习重建被遮挡时空块;编码和解码在时间上全因果,避免把未来观察泄漏进当前表示。
- 2
同一网络改变状态与动作的噪声水平
图1(c)每帧含256状态token、4个寄存器、2个噪声级别和1个动作token,共263个。保持动作干净、预测状态时就是模拟器;联合加噪可生成动作与状态,保持状态干净则支持逆动力学。本文没有使用文本或任务条件。
- 3
块内双向、块间因果,复用历史KV
图1(b)(d)交替沿空间和时间轴注意。训练随机取1、2、4、8、16帧块,块内可互看、只能看较早块;部署可以逐帧或整块采样,无需重训。块内双向是共同去噪预测帧,不是读取真实未来。
- 4
按块加噪并校准两个训练目标
同块状态共享状态噪声、动作共享动作噪声,以块级diffusion forcing模拟带预测误差的历史。状态用x预测、动作用速度预测;每500步分别测损失对共享网络的梯度,结合噪声网格上的损失均值重新加权,避免某模态主导。
- 5
先学模拟,再反馈调节联合训练
纯世界模型训练收敛后,用Hutchinson估计动作扰动对潜变量的归一化敏感度,以其峰值约90%为设点调节世界模型模式采样偏置。本实验偏置从近1降到约0.2;这个传感量是局部动作响应代理,不是物理正确性证明。
- 6
规划与真实运行使用不同反馈
MCTS用联合生成提出动作原语并预测结果,再用任务评分选路径。OpenArm部署则把真实相机输入写入历史KV,同时比较预测和实际图像以收集失配样本;论文未执行这些样本的再训练收益验收。
实验与证据
完整阅读57505字符论文及参考文献,公开HTML未附独立附录;视检图1、核对表II–IV与开放声明。未运行模型或机器人实验。
来源证据各领域模型400M、512M或690M,从随机初始化训练,8张H100约15万步、4天,batch64、上下文32。 表I、第III-A节 ↗
我的解读这些是分别针对数据集训练的模型,不是单一检查点无需适配跨全部本体;“同一检查点”指同领域多推断模式。
来源证据690M、B=1、32步KV、8去噪步下策略71.5±1.0毫秒、世界模型72.7±0.3毫秒;UWM对应34.1和34.4毫秒。 表II、第III-C节 ↗
我的解读保留较慢的对照。Cosmos世界模型47.0毫秒使用官方单去噪步,不能把不同推断预算解释成纯架构优劣。
来源证据LIBERO T=64时B=8为SSIM0.778、PSNR20.5dB;UWM0.599/15.6,Cosmos-Policy0.587/16.5。 表III ↗
我的解读基线按自身固定动作块预测终点后递归,FLEX支持历史缓存;这比较的是完整推断设置,不能单独归因于分块掩码。DreamZero无LIBERO检查点,未参与此量化。
来源证据G1块宽消融用256个生成序列与256真值片段测FVD,另测相邻帧LPIPS与动作L2;1024步示例主要检验视觉稳定。 图3、图5 ↗
我的解读平滑并不等于动作正确,FVD也不保证长期隐藏状态或接触物理保持;较低帧差还可能来自运动减小。
来源证据OGBench五任务各20次,在600次MCTS迭代预算下分别17、17、14、14、18次想象成功,总80/100;平均计划157帧。 表IV、第III-D节 ↗
我的解读每个任务都存在成功样例,不代表每次成功;论文明确未真实执行这些计划。树搜索预算与模型单步实时性分开。
来源证据PushT使用4小时真实play数据,停止动作后以DINOv2距离检查是否停在先前状态;OpenArm使用刻意较短的2小时数据展示幻觉物体。 图2、图8、第III-E节 ↗
我的解读前者支持准静态响应诊断,后者只是失配发现案例。没有给出失配检测精确率、召回率或持续学习前后对照。
开放情况与使用许可
论文正文称open-source,但脚注明确代码和检查点为匿名审稿省略、待接收后发布。2026-10-11论文及检索未核实实际官方实现,因此保持pending,不把未来承诺算开源。
LICENSE论文与图1为CC BY 4.0;未核实代码或检查点许可。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
同一检查点在逐帧与分块生成间切换,为部署延迟和批量想象吞吐提供可测控制;LIBERO动作条件预测在所测时域优于两项基线。
先训练世界模型,再以动作弹性反馈调节采样,针对联合训练遗忘动作依赖这一具体问题,而非单纯增大网络。
反方 · 哪些结论还不够
在准静态PushT上停止动作、图像应保持不变的检验较窄;高弹性可能来自错误或过大的响应,需要额外物理干预检验。
OGBench的80/100成功全部为模型想象终态,模型与规划器共享错误时可能乐观,不能改写为真实机器人80%成功。
FLEX-WAM约71.5毫秒的策略/联合推断慢于393M的UWM约34毫秒;各方法模型规模和官方去噪步数不一致,不存在无条件速度领先。
综合判断
对可部署联合世界动作模型的训练平衡与缓存结构有明确贡献。最关键待补证据是想象计划的真实闭环成功率,以及自动收集反例后是否确实改善模型。
我会先做的验证
建议实验,未执行:固定数据、参数量和总训练计算,比较有无梯度校准、固定采样率与反馈采样;在停止、反向、碰撞和接触切换干预下测响应方向与误差。把同一MCTS计划真实执行,分别报告想象成功、真实成功、搜索耗时和模型误报率。