FLORA:把操作视频变成时间段、动作描述和奖励标签
机器人数据引擎的质量、吞吐和非商业许可应如何同时审视?
FLORA由时间分割、动作描述和奖励三个专用模型组成,面向大规模机器人与人类操作视频。它把长视频切成可训练事件并给出结果、密集状态及自定义规则奖励;论文的低成本估算很醒目,但实际公开权重限定非商业研究,成本也不是本机或完整生产流水线的实测。
图解主要方法
机器人数据引擎的质量、吞吐和非商业许可应如何同时审视?
- 1
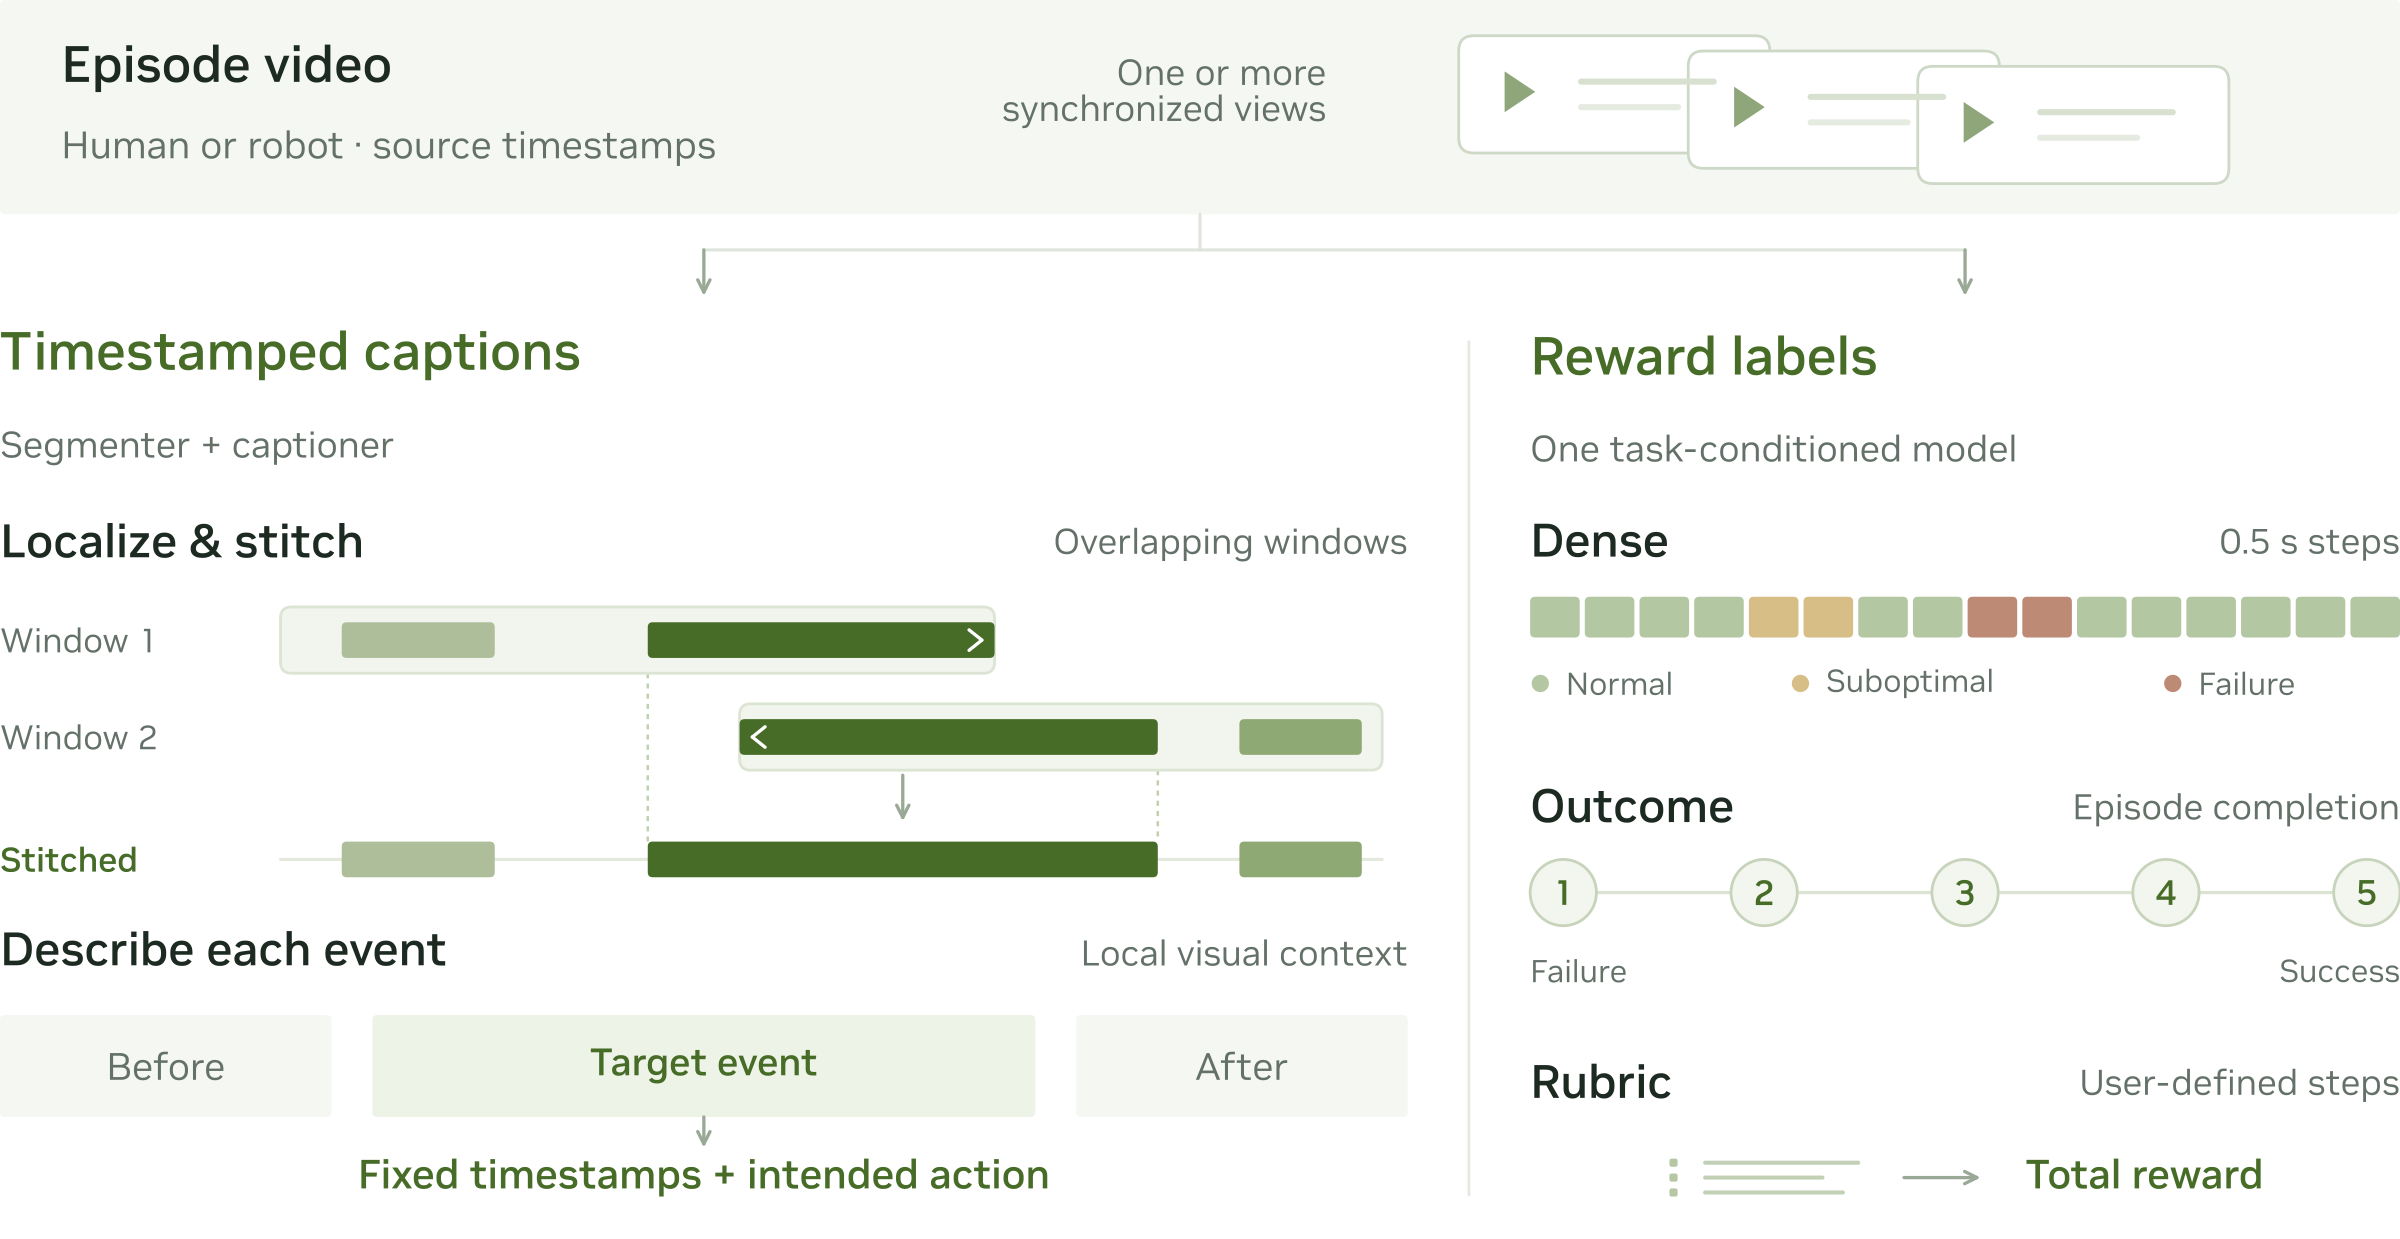
1 · 图6:重叠窗口定位并拼接事件
9B时间分割模型按16秒、64帧、4fps窗口处理,保留中间12秒,两侧各2秒做上下文;跨窗口延续标记帮助拼接并保留并行动作。边界用GRPO组合F1、precision与边界奖励优化,不能把窗口切点当动作真边界。
- 2
2 · 用前后文解释目标片段
27B描述模型读取BEFORE、TARGET、AFTER,邻近片段帮助消歧,但输出只描述目标事件。经SFT和参考描述奖励的GRPO训练;“打算完成什么”和“是否完成”需要不同标签,不能从命令句推断成功。
- 3
3 · 奖励模型区分三种输出
另一个27B模型经SFT输出1–5终局分数、每0.5秒正常/次优/失败状态,或用户rubric分数。密集奖励可看未来4秒,是离线回看标签,不是已经验证的实时故障预警。
- 4
4 · 把吞吐估算还原到具体条件
论文按固定视频集合的处理吞吐和8块GB300、每GPU小时10美元估算成本。公开仓库注明提供vanilla推理示例而非生产推理系统;模型卡提供的权重也不能绕过商业使用限制。
实验与证据
已阅读正文与方法、实验相关附录,核对实验条件与原图;未独立复现。
来源证据WGO取100集、三子集25/50/25等权平均,FLORA分割50.3、描述64.7、联合34.5;联合分数低于Astra39及某Refiner36.4。RoboReward MAE为0.400。 WGO实验与奖励任务 ↗
我的解读不能仅照摘要称所有指标SOTA;表格40.0是MAE乘100展示,不是1–5量表上的40分误差。
来源证据40集4861步,macro-F1 46.2,失败召回53.3%,约11%正常步被误报失败。 密集错误评估 ↗
我的解读足以研究数据筛选,但不适合直接当物理系统唯一安全裁判。
来源证据固定50集74.7分钟视频,条件估算每源视频小时0.7224美元,对比API约88.4922美元,约122.5倍、文中近似125倍。部分API调用缺成本,且版本存在差异。 成本核算 ↗
我的解读不是完整TCO,也不是等质量生产对比;训练、存储、运维和硬件利用率仍未纳入。
开放情况与使用许可
已确认NVIDIA/Flora有三个推理实现目录;HF三个模型包含实际权重或LoRA适配器。三张模型卡均指向NVIDIA OneWay Noncommercial License并明确非商业研究开发;代码LICENSE也有限用途条款。模型卡记载10月15日释放,本文论文首发10月22日,两者不混淆。
LICENSECC BY 4.0(论文及原图)
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
事件边界、目标描述和奖励接口明确,便于将视频转为可检索训练单元,且论文没有只给吞吐而完全回避质量分析。
反方 · 哪些结论还不够
公开示例不等于高吞吐生产系统;短评测集、漏检与误报、离线未来上下文限制在线用途。权重和代码的非商业限制是实际使用门槛。
综合判断
值得做离线机器人数据整理试验,不能把低成本估算直接当商业采购依据或在线安全能力。
我会先做的验证
未执行的验证方案:选独立真实失败视频,人工标注事件边界与成功/失败,固定硬件测端到端每小时成本、拼接漏失、动作标签错误及误报,单独比较去掉未来帧后的监测性能。