FRED:把视频模型的未来表征蒸馏给动作模型
不完整生成未来视频,能否仍得到有用的动作条件?
通过视频模型的单次前向和未来表征自蒸馏,给动作扩散器提供低成本条件。真实机器人和仿真结果有提升,但真实任务多使用部分完成分,模型仍需多步生成动作。
图解主要方法
不完整生成未来视频,能否仍得到有用的动作条件?
- 1
让教师看未来、学生猜未来
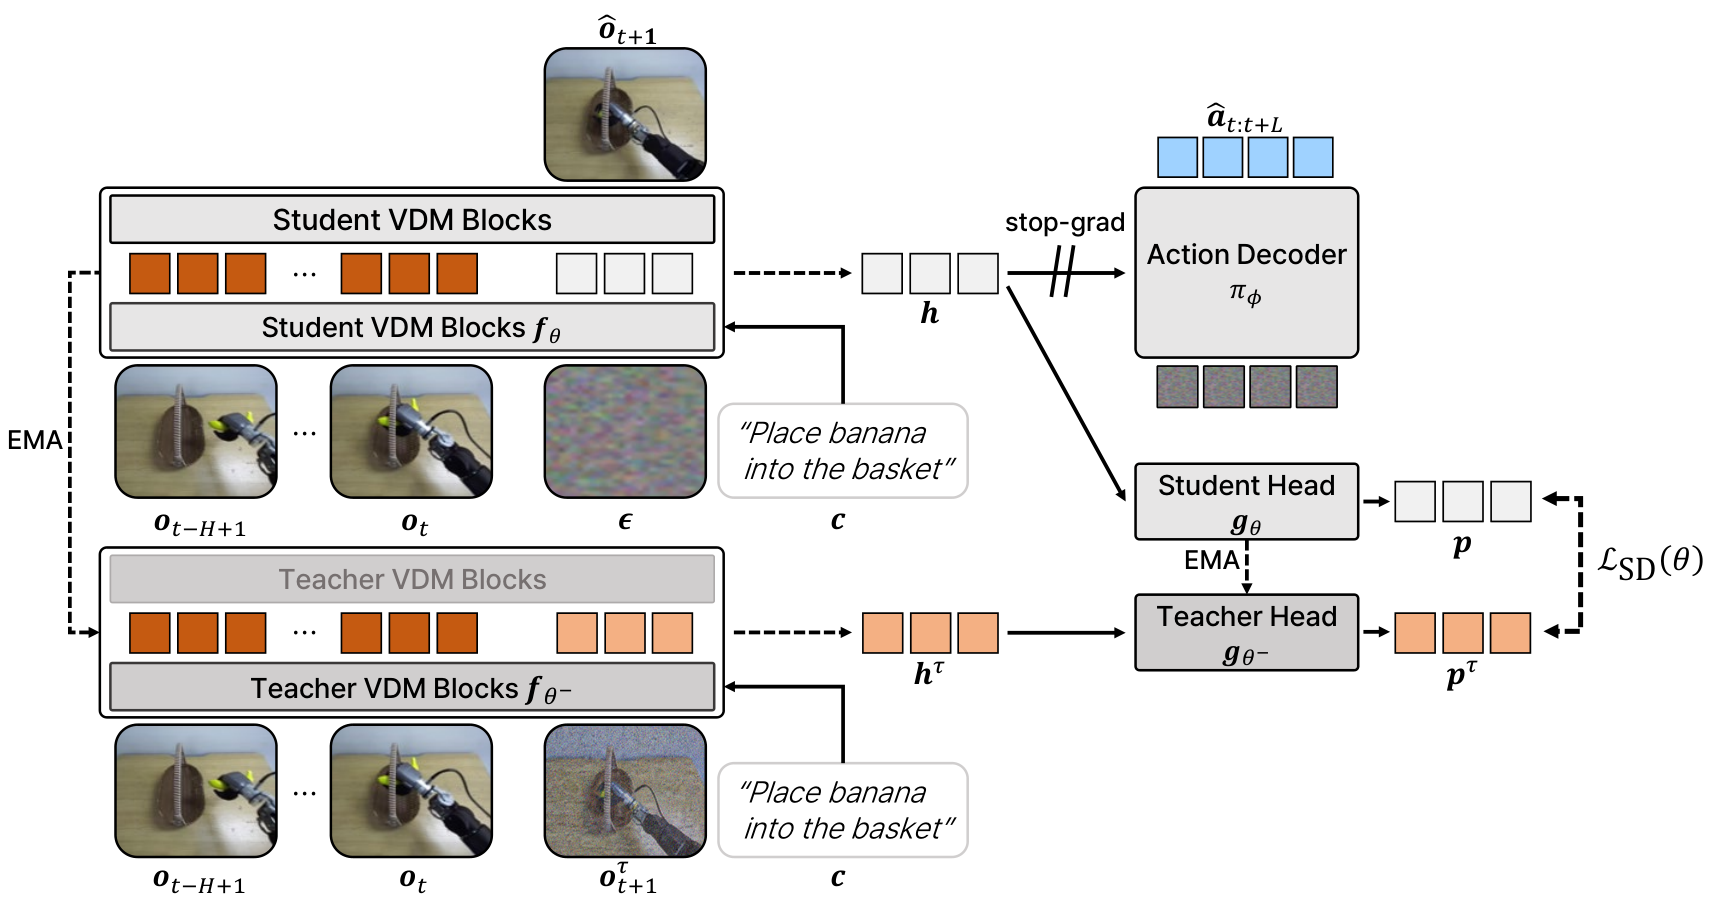
图2中EMA教师输入真实未来的带噪版本,噪声时刻0.25;学生在时刻1接收纯噪声未来。教师与学生分布经中心化、锐化后做KL蒸馏,教师/学生温度0.04/0.1,蒸馏权重0.01。
- 2
联合训练但阻断动作梯度
视频分支用流匹配与未来自蒸馏训练;动作分支读取视频特征,但动作损失不会反传到视频模型。这样可以减少动作目标破坏视频表征,不能等同于证明表征已包含完整物理状态。
- 3
一次视频前向接四步动作去噪
输入包括当前及4帧历史、8帧未来、步幅3;5B视频模型取第18层,14B取第24层。视频只运行一次,动作DiT仍执行4个去噪步骤,所以“一步”不应描述整个控制系统。
- 4
利用人类视频迁移表征
在OpenArm实验中结合机器人示范与人类视频,检查动作跟随和物体交互迁移。语言、历史和数据混合均可能影响效果,需要与未来蒸馏本身分开消融。
实验与证据
已阅读正文与全部公开附录,核对实验条件与原图;未独立复现。
来源证据8项任务每项12次;14B模型的任务进度分从61.7到81.7,OOD从10.4到52.1,接地相关分从39.6到54.2。失败中的部分完成可给0.5,长任务按进度计。 真实机器人 ↗
我的解读这些分数不能统一写成完整任务成功率;VLA基线用腕部加左相机,WAM用两个外部相机,传感配置也是比较边界。
来源证据553条机器人示范约192k帧、1187条人类视频约321k帧;3项迁移任务各12次,部分完成分50对19.4,动作跟随97.2,无人类数据条件为0。 人类视频迁移 ↗
我的解读跟随动作并不等于任务完成;小样本和进度评分限制了泛化强度判断。
来源证据RoboCasa匹配batch64时61.4到68.8,无蒸馏65.1、无历史64.8;附录75.4使用batch256。A100上5B为0.136秒,比DiT4DiT的0.111秒慢;14B为0.406秒,DreamZero为3.255秒。 仿真和效率 ↗
我的解读不同batch结果不能混作同条件提升。相对昂贵视频基线明显加速,但不是对所有动作模型都更快。
来源证据未来识别相关性r=0.89,而控制分支对照为0.24;探针包含15类并从10个epoch选择最佳验证结果。 表征探针 ↗
我的解读相关性和选择后的验证成绩支持表征有信息,不构成未来理解导致任务提升的因果证明。
开放情况与使用许可
suhyeok-jang/FRED已有训练与运行实现,Apache-2.0;已核实FRED-AGI-LAB/fred-wan22-5b-droid模型卡和权重文件,卡标Apache-2.0。其他配置未逐个验权重,不将5B核验延伸为全系列已验收。
LICENSE作者版权;arXiv非独占托管许可
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
单次视频前向、动作梯度隔离和匹配batch消融共同支持未来表征蒸馏有效,且有真实机器人证据。
反方 · 哪些结论还不够
部分分、相机不一致、小规模迁移和计算规模变化使“成功率大幅提升”的简单标题失真;闭环安全与长任务稳定性仍需检查。
综合判断
值得复用的是未来特征训练方式,不是把视频单步推理当作整个系统的单步控制。
我会先做的验证
未执行的验证方案:在统一相机和数据量下分别报告二元成功率、部分进度、碰撞与接管次数;比较有无蒸馏及相同batch,并测真实控制频率和尾延迟。