Gated Memory:在写入记忆前保留事实的上下文
LoCoMo整体只增加1.3个百分点,多跳下降提醒过滤也会切断证据链
Gated Memory在记忆后端之前加入准入、事实拆分和有条件知识补充:只从当前交换形成新事实,历史仅用于指代消解,并保留来源和适用条件。在检索与回答配置不变的LoCoMo测试中,准确率50.6%升至51.9%,但多跳下降;这支持写入质量值得研究,尚不足证明生产收益或隐私保证。
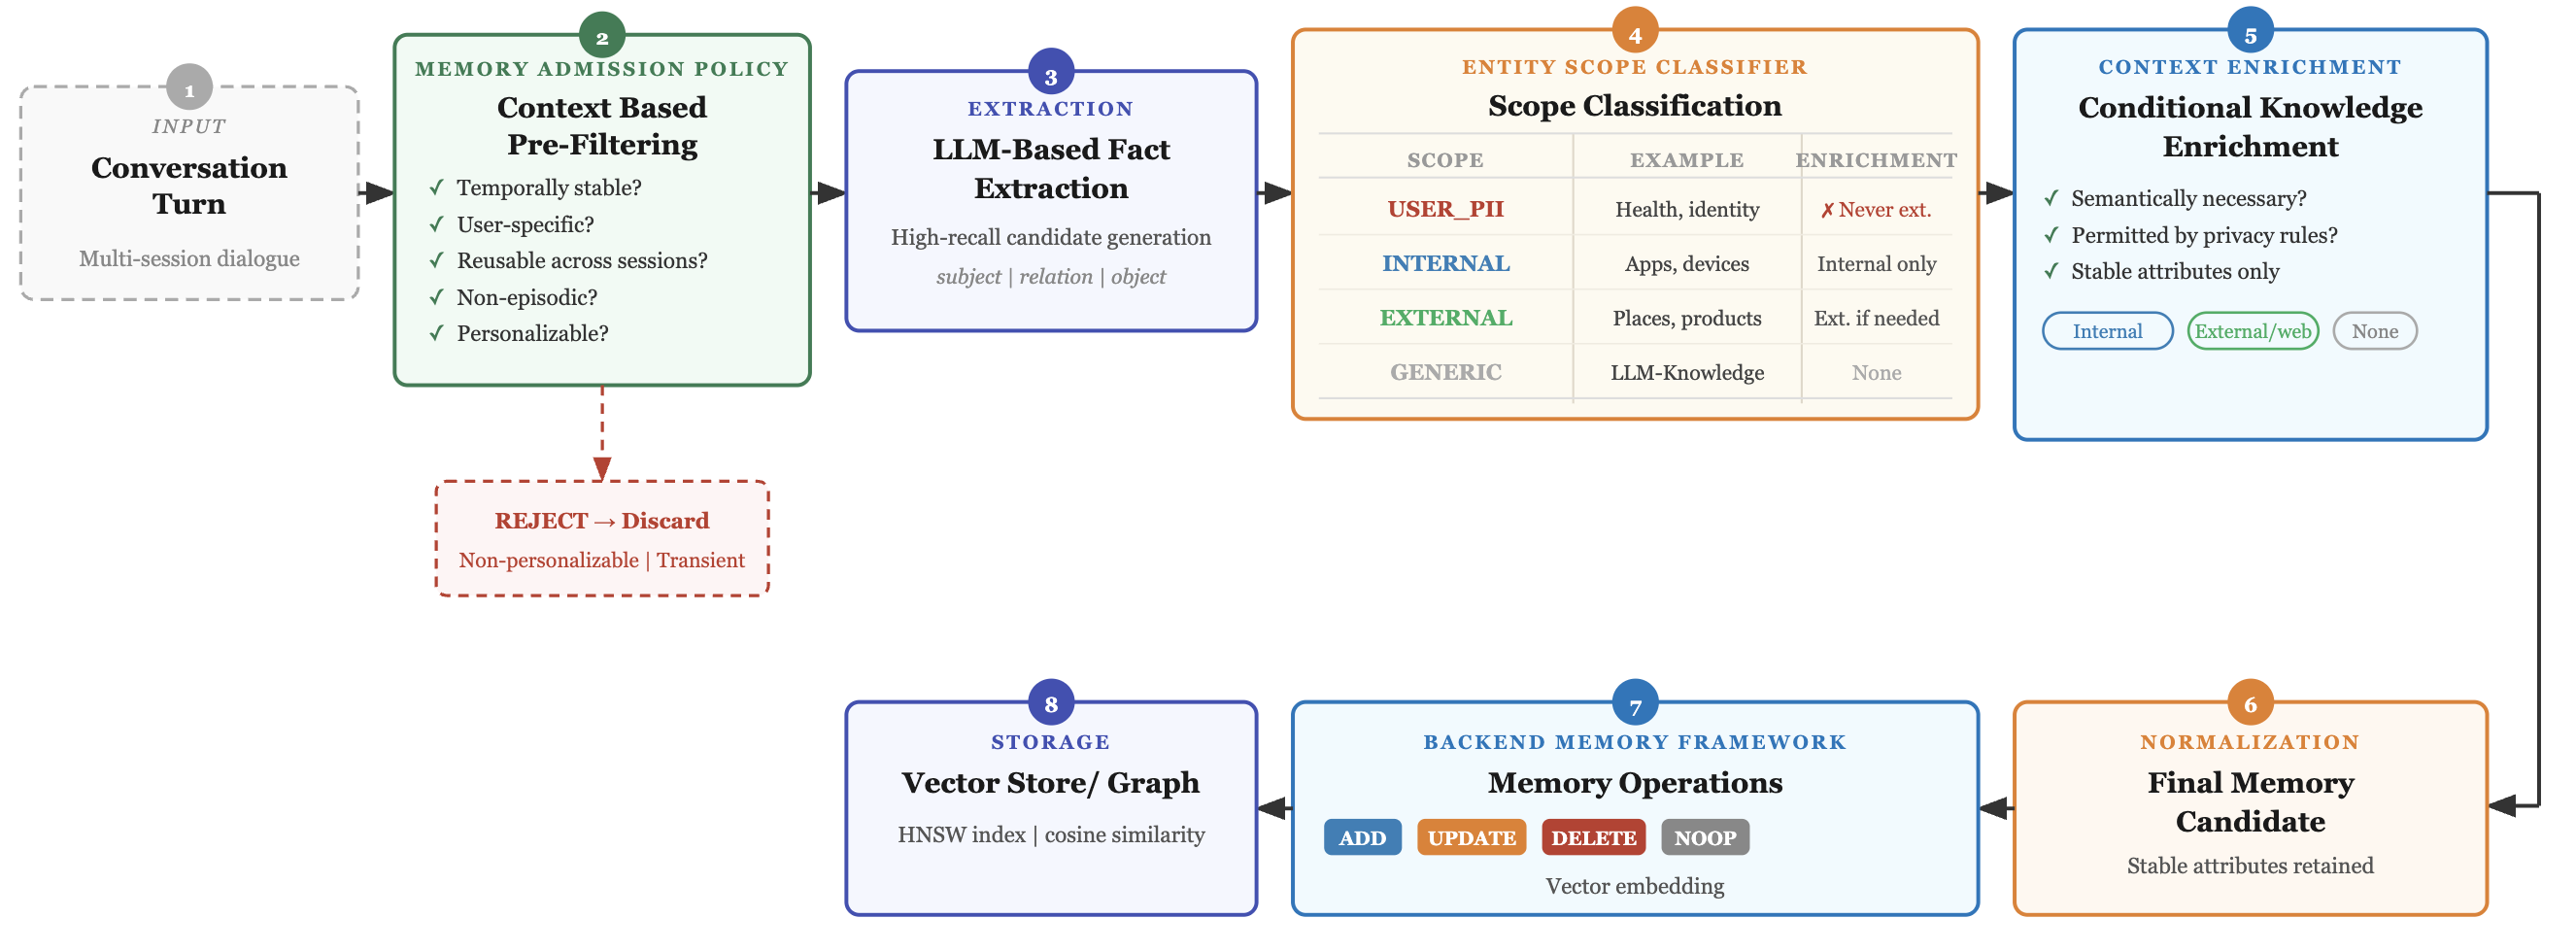
图解主要方法
过滤不值得永久保存的话语,是否也会误删未来推理所需的证据?
- 1
分开当前交换与历史引用
只有当前用户话语及系统回应被当作新事实源,历史窗口只辅助指代和相对时间地点消解。这样减少反复重新抽取,但重复当前陈述仍需后端去重,提示本身不保证严格幂等。
- 2
在原句仍完整时决定是否形成记忆
LLM按稳定个性关系、半稳定用户属性或跨会话可用性作准入判断,拒绝泛泛情绪和短暂情境。它是政策选择,暂时事件也可能是未来多跳问题的重要节点。
- 3
拆成原子事实并保留证据性质
对事实多标签分类为画像、偏好、事件、操作、用户规则和纠错,标直接陈述或推断及条件范围。文中“明确要求记住则全部标直接陈述”可能使推断来源被抹平,需要另行约束。
- 4
按实体范围限制丰富渠道
USER_PII不丰富,INTERNAL只用内部元数据,EXTERNAL必要时外查,GENERIC用参数知识或不丰富。每条只选一个范围,对同时包含人和产品的混合事实如何处理未充分说明。
- 5
落定时间地点并交给原后端
把相对时间绑定话语时间戳,规范化后交mem0去重、冲突处理、向量化和存储。外部丰富可能陈旧,原始证据、推断和新增外部知识应分开保存。
实验与证据
全文29379字符读完,公开HTML无额外附录;图1视觉核验、首发和许可核对,检索未核实官方实现。
来源证据LoCoMo-10,十段约300轮多会话对话,1540问题,排除第5类对抗问题。 4.1 ↗
我的解读覆盖较窄,不能证明抗恶意写入、真实用户隐私或多语言泛化。
来源证据后端mem0、Qdrant、未具名开放8B指令模型与固定回答提示。 4.2–4.3 ↗
我的解读匹配后端有助比较形成层,但缺模型名、裁判名、完整提示与种子阻碍独立复现。
来源证据5882条话语准入5527、拒绝355,即94.0%与6.0%。 4.4 ↗
我的解读话语不是最终原子事实数量,准入还可拆分和丰富;不能据此推算向量存储或调用费用减少6%。
来源证据整体50.6%→51.9%;单跳49.6%→51.8%;开放域48.3%→49.9%;时间57.6%→58.6%。 表2 ↗
我的解读分别提升1.3、2.2、1.6、1.0个百分点;统计显著性未给,单一整体对照不能证明每类机制解释。
来源证据多跳50.0%→47.9%,相对下降4.2%。 5 ↗
我的解读与过滤损伤证据链相符,但没有逐样本链分析或阈值扫描,尚不能证明是所有独立准入策略的必然限制。
来源证据判分采用宽松LLM裁判,接受释义和部分答案。 4.3 ↗
我的解读这是具体裁判规则下的正确率,不是严格事实覆盖率;未报告人工校准或裁判间一致性。
来源证据“无前件he is seven”示例被规范为用户的孩子七岁。 3 Grounding ↗
我的解读编辑解读:孩子及其与用户关系均未由该孤立窗口证明,和禁止引入无依据实体关系的原则有张力。
来源证据正文称生产环境可降存储、延迟和幻觉。 2;7;Limitations ↗
我的解读未给生产部署成本、延迟或隐私测试;保留原文的后端也可重新审查,所谓下游永远不可恢复只适用于已经丢弃原文的设定。
开放情况与使用许可
论文与原图公开;全文、摘要页未提供官方仓库、配置或模型卡,补充检索未核实实现发布,不能将所用mem0开源状态当作本方法已开源。
LICENSE论文为arXiv非独占托管许可,图1版权归作者,仅用于方法评论;未核实代码许可。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
固定检索与生成后修改形成层,至少在该配置下说明输入记忆质量能改变下游回答。
明确区分当前证据、历史引用、直接陈述和推断,有助于审计不恰当的永久用户画像。
如实报告多跳回退,暴露单条事实准入与证据链保存之间的矛盾。
反方 · 哪些结论还不够
50.6%→51.9%是1.3个百分点、约2.6%相对准确率提升,不是2.6个百分点或2.6%误差下降。
表格题头写Rel Error但数字按准确率变化计算;没有组件消融,不能把开放域收益单独归因知识丰富。
论文仅用提示策略描述隐私与grounding,未测泄漏;无前件的“he”仍被补成用户的孩子,示例本身存在无证据关系推断。
综合判断
值得作为写入前保留限定信息的设计提案阅读,实证是小幅、单基准、配置不完整的结果;不支持所有后端都无法纠错、生产成本必降或隐私得到保证的强结论。
我会先做的验证
建议实验(尚未执行):公开精确模型与提示词,分别消融准入、结构化和丰富;按对话做配对自助法置信区间,加入重复陈述、代词歧义、情绪事件与跨语种测试,并审计外部请求是否携带PII及多跳链断裂。