Gaussian Is Enough:动作先验更接近目标,为何未必更好
七种先验的大规模对照,把关注点转回微调表示与真实闭环
把扩散或流策略从高斯噪声改为预训练动作、检索结果或条件分布,直觉上似乎能更快到达正确动作。论文发现:充分微调后,多数更接近目标的先验并未稳定提高闭环成功率;在极少示范时仍有例外,编码器更新也可能比先验设计更关键。
图解主要方法
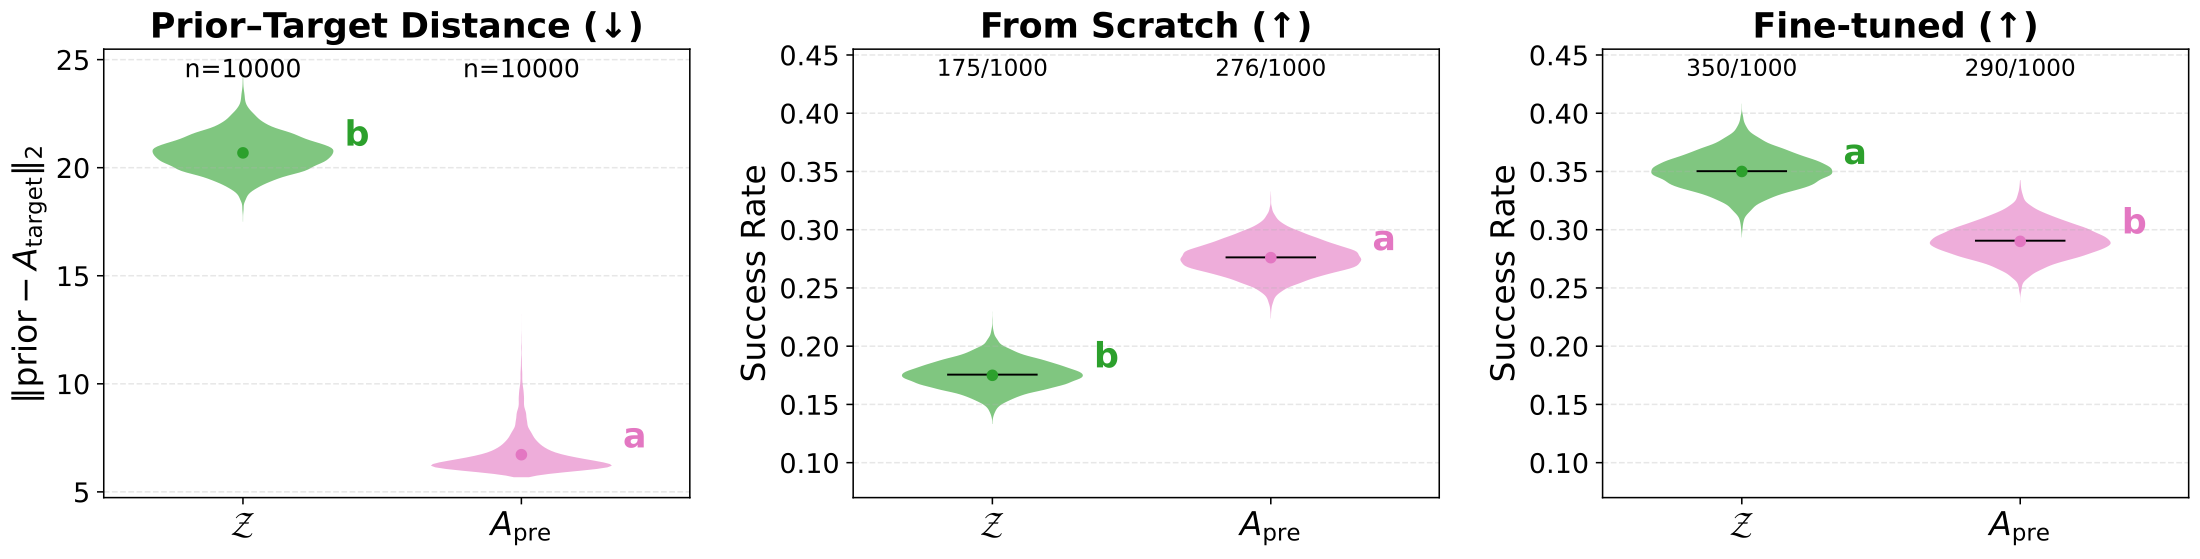
图2展示的先验距离与微调成功率为何可能脱钩?
- 1
明确七种起点与计算预算
比较高斯、预训练策略动作、动作加噪、嵌入加噪、条件高斯Cocos、CVAE型BRIDGER和检索先验。预训练先验要花去部分去噪预算,所以构造起点和后续运输合计比较;不能只计最终运输步骤。
- 2
控制训练,但检查目标函数差异
三类策略骨干覆盖LBM、π0.5和GR00T,尽量固定数据、训练步数和优化器。LBM主实验高斯用DDPM、其他先验用流匹配,是一个混杂;附录增加全流匹配BFP对照,在五个厨房任务仍未见先验收益。
- 3
用实际闭环而非动作L2判好坏
图2表明起点动作更靠近目标,不保证执行后完成任务。比较42个仿真任务与五个真实任务,真实试验交错随机运行并盲评,减少环境与评价顺序偏差;动作坐标尺度本身也会影响距离解释。
- 4
把表示更新和小数据例外分开
降低编码器学习率会显著掉分,提示微调表示适应的重要性;但这项机制证据主要来自LBM,不能外推GR00T的冻结EAGLE。仅5%数据时嵌入扰动先验有收益,也不能以平均结果否定所有低数据情形。
实验与证据
以下为作者报告;已阅读 v1 全文及可用附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【试验规模】42仿真任务、超过10万次rollout;真实五任务、五先验、每格50次,共1250次。多数先验在25%–100%数据下无显著优势。 主结果与统计附录 ↗
我的解读我的解读:大样本闭环对照增强结论,但共享显著性字母只表示未拒绝差异,不能证明严格等效;rollout数也不等于独立训练种子数。
来源证据【少样本例外】5%数据约10–20条示范时,嵌入加噪成功率25.9%,高斯18.9%。 数据量消融 ↗
我的解读我的解读:默认高斯是稳健起点,不代表条件先验没有适用场景;应按数据量分层。
来源证据【表示敏感性】LBM编码器学习率降低十倍,仿真约56–59降至41–43,真实37降至28。 编码器、先验距离与实现附录 ↗
我的解读我的解读:提示更强表示适应的价值,但不能把相关消融写成三骨干统一机制证明。BRIDGER数值失败与超参数调整也须计入复现。
开放情况与使用许可
全文及附录已读,作者项目页可访问;其链接的LBM评测仓库不能自动视为这篇七先验研究的完整训练实现,本次未核实专属完整发布。
LICENSE专属代码及权重许可未确认;论文图2许可见图注。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
把“更近的先验必然更好”的直觉放进预算受控和真实闭环评测,有助于避免投入复杂但收益不稳的模块。
反方 · 哪些结论还不够
骨干和任务仍有限,部分损失配置不完全匹配,低数据存在反例;统计未显著不等于普遍无效。
综合判断
充分微调时可先用高斯基线,把资源投入表示和评测;只有在明确的小数据或延迟瓶颈下再证明复杂先验的收益。
我会先做的验证
未执行的验证方案:固定训练种子、全流匹配目标和端到端采样预算,在5%至100%数据上做先验×编码器学习率交叉实验;报告置信区间、总延迟、失败类型与预先规定的等效界。