Glance:让生成模型兼任检索重排器
共用前缀缓存能否省掉另一个常驻模型,而不偷偷扩大显存?
Glance 在一个9B混合注意力模型上增加LoRA与指针头:候选段落编码一次,多条短探针分别给相关性打分。共享骨干减少模型部署种类,但不是必然比专用重排器快,主方案生成时还要重新编码筛出的段落。
图解主要方法
共用前缀缓存能否省掉另一个常驻模型,而不偷偷扩大显存?
- 1
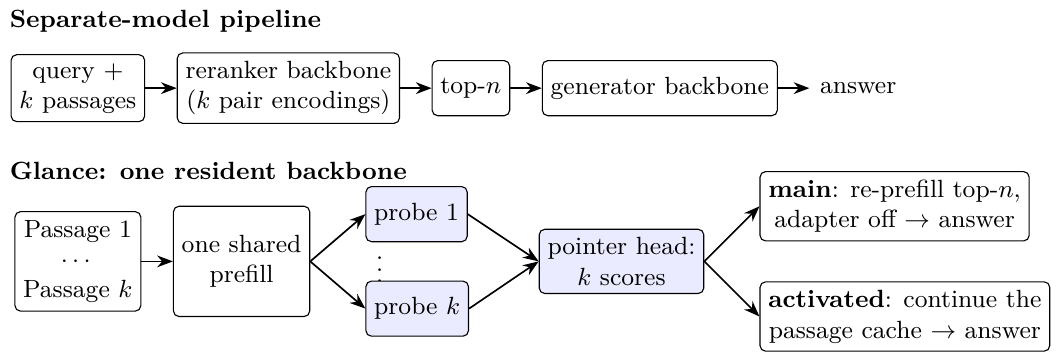
图1:先共享候选段落的编码
把问题与k个候选组织成共享状态,再为每段追加约30token的相关性探针。每个分支能看到全部候选,不与其他探针交互;“独立分支”不等于统计独立的判断。
- 2
混合注意力要求复制两类状态
骨干含3:1的Gated DeltaNet与全注意力层。除KV外,分支还需要复制线性注意力的递归状态及卷积窗口;仅调整注意力mask不能隔离这些状态。rank16 LoRA和256维指针头输出选项概率,不用逐字生成评分理由。
- 3
主方案筛选后重新prefill
主适配器在候选编码与探针阶段都激活。选出top-n后关闭适配器,用同一骨干重新编码这些段落再回答;因此共享的是重排阶段候选编码,不是从头到尾只做一次prefill。
- 4
Activated变体保留全部候选缓存
变体让候选使用基础权重,仅探针激活适配器,因此可以沿基础缓存生成。但缓存仍含全部k段,并没有物理删掉低分段落;节省重编码与缩小上下文是不同目标。
实验与证据
已阅读正文全部方法、实验与限制,并核对模型卡检查点差异,核对实验条件与原图;未独立复现。
来源证据4000个MS MARCO查询、55598探针、约7.7M token,单B200训练约39分钟;SciFact300与NFCorpus323查询,nDCG@10分别.741/.345,对BGE的.721/.326。 §4:训练与重排 ↗
我的解读小规模跨数据集结果支持可行性,不足以宣称全领域重排领先;所谓零样本版本也继承了通用决策训练。
来源证据主方案相同9B生成器、top3条件下F1比BGE重排高.045,95%区间[.014,.076];Activated对照仅100问,F1 .750对重新prefill的.754。 HotpotQA 300问 ↗
我的解读后一项小差值没有显著性依据,不能把少量样本的缓存复用等同无损保证。
来源证据100问、每段100词,k100时约21.6k token、1.05秒、56GiB;k200需分块探针,约15.8秒。官方根目录是额外450条长候选训练后的trained-long,39分钟论文检查点另存子目录。 长候选与模型卡 ↗
我的解读对照专用交叉编码器更快;必须匹配检查点,不能把新发布权重的分数冒充论文主实验。
开放情况与使用许可
官方HF包含适配器、指针头、实现和评估脚本,模型卡标Apache-2.0并要求保留NOTICE;不是完整独立基础模型。基础模型与MS MARCO数据条款仍需分别遵守。
LICENSE论文 CC BY 4.0;代码与权重许可另见开放范围
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
共享常驻骨干和可切换适配器对资源受限、多任务服务有工程意义,论文也报告了重排后的问答效果。
反方 · 哪些结论还不够
单骨干家族、有限任务与种子,分支状态随候选规模膨胀;缓存等价验证和vLLM原型的适用范围不同。
综合判断
这是部署整合与缓存复用方案,不是通用低延迟重排替代品。
我会先做的验证
未执行的验证方案:比较同GPU下专用重排器与Glance在k20/100/200的吞吐、峰值显存和问答忠实度;分别测主方案与Activated,禁止混用检查点。