Greedy Precision:只在词元竞争接近时重算输出头
贪心解码的一致性修补,收益集中在小批量与低裕量步骤
温度为零仍可能因 BF16、FP16 和硬件算子差异生成不同文本。这项研究先检查原精度下第一、第二候选的 logit 差,仅在差值很小时以 FP32 重算输出头;目标是跨精度文本一致,而不是自动提高答案正确率。
图解主要方法
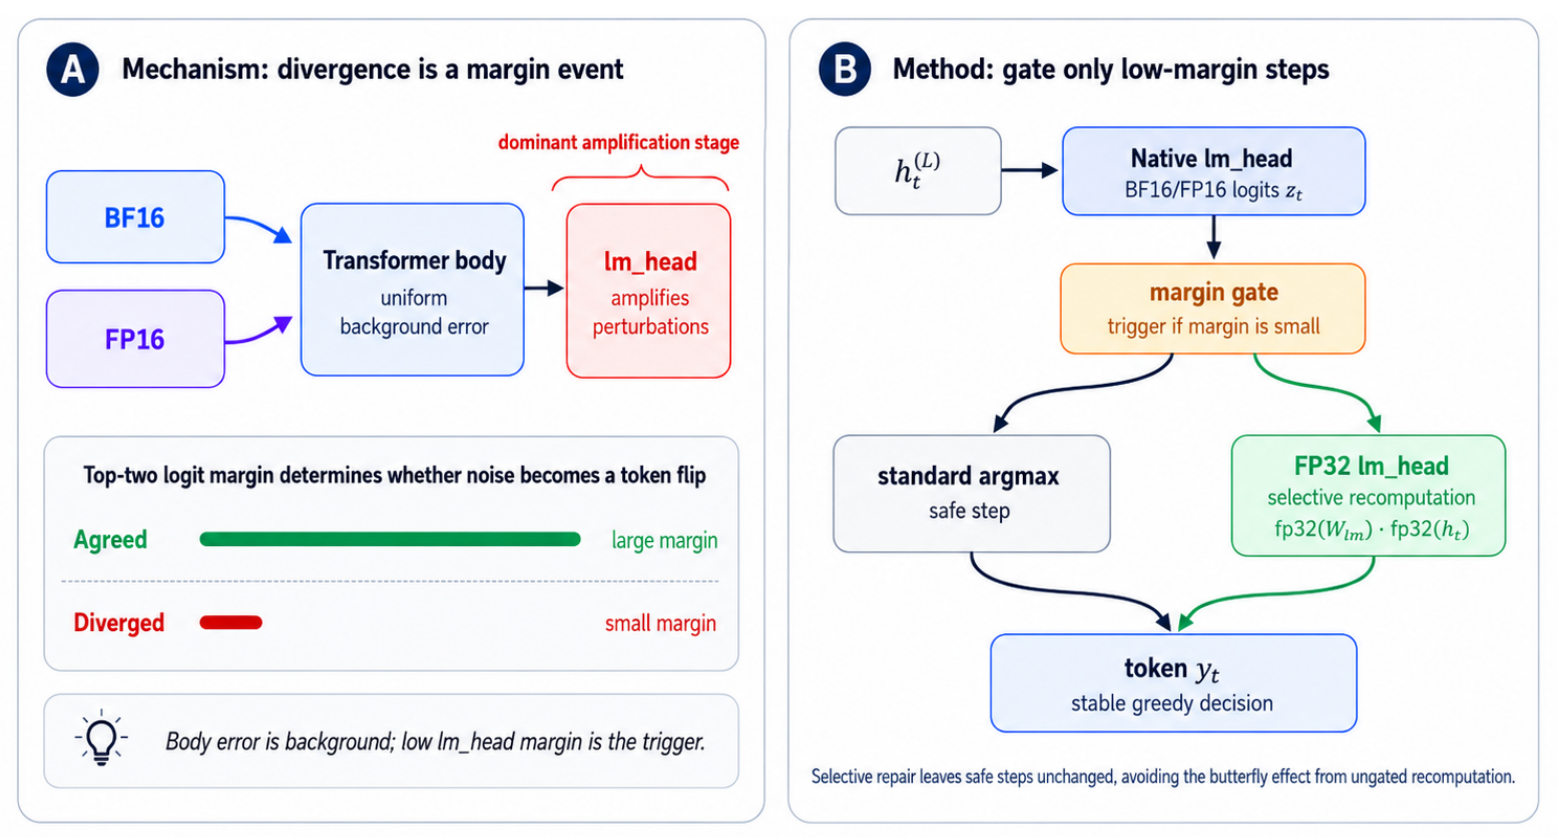
图 2 为什么把干预放在 lm_head,而不把整个模型都改成 FP32?
- 1
把分歧定位到离散决策边界
图 2A 区分 Transformer 主体中的连续数值扰动与输出头上的候选翻转。当原始 top-2 logit 间隔很小,微小误差就可能改变 argmax;一旦选出不同词元,后续上下文也不同。这个机制是有条件的经验解释,不保证全部首个分歧都出现在同一层。
- 2
先用原精度确定是否触发
图 2B 先计算原来的 BF16/FP16 logits,只有 top-2 间隔低于 10⁻³ 才触发修补,其余步骤直接执行原始 argmax。这样保留绝大多数原推理路径;不能先全面改变 logits 再把差异称为同一个门控实验。
- 3
对比三个不同干预以识别误差来源
A 只把已算出的 logits 整数化,不能挽回已经改变的候选顺序;B 对少量候选在 FP32 中重算点积;C 对全词表重算输出头。B 与 C 在部分实验的近似收益支持低裕量候选竞争的解释。提升精度时使用的是已经低精度存储过的权重和隐藏状态,不是恢复原始全精度模型。
- 4
分别衡量文本一致、任务正确与部署开销
EAR 要求整条生成序列完全一致;答案相同、测试通过或相同语义都不等于 EAR。图中的局部门控也不保证跨硬件确定性,论文附录继续检查批大小、FP8、质量变化和硬件组合,不能只取最漂亮的一行。
实验与证据
以下为作者报告;已阅读 v1 全文及可用附录,本站未独立执行研究实验。实验条件与编辑解读分别列出。
来源证据【小样本跨精度实验】TinyLlama 的 GSM8K 子集 n=100,EAR 从 41% 到 63%;两个代码条件从 36% 到 61%、30% 到 55%。 主文干预实验及质量附录 ↗
我的解读我的解读:这是完全相同序列的比例,不是数学或编程正确率;TinyLlama 在部分质量集上的正确率很低,不能靠一致性推断能力。
来源证据【质量与指标分离】Qwen 的 HumanEval n=164,序列一致率 26.2%,结果一致率却达 97.6%;BF16 pass rate 从 50.0% 到 51.2%。Mistral 的部分质量项下降约 3–5 个百分点但不显著。 质量评估与非劣检验附录 ↗
我的解读我的解读:“无显著下降”不等于已经证明无害;不同指标反映的风险不同,质量结论受样本规模和非劣界限影响。
来源证据【部署边界】A10G 配置报告延迟约增加 1.4%、内存增加约 11%;收益主要在批大小不超过 4,batch=8 未见相同改善。全模型 FP8 的收益约 1 个百分点,远小于隔离输出头实验。 批量、FP8、硬件及分歧位置附录 ↗
我的解读我的解读:不能把局部输出头实验推广为全模型量化修复。正文与附录对提示模板、首个分歧位置还有表述差异,需要固定配置清单复核。
开放情况与使用许可
已读 arXiv v1 的 42 页全文与附录;论文版面标注 TMLR 2026 年 9 月,首发按 arXiv 09-22。OpenReview 页面本次不可访问,未据此确认评审状态或实现发布。
LICENSE论文及图 2 为 CC BY 4.0;本研究代码与权重发布许可未确认。
我的判断
独立分析 · 未复现实验正方 · 为什么值得投入
把一致性问题拆成可测的 logit 裕量与局部重算,适合审计低批量推理中的偶发词元翻转。
反方 · 哪些结论还不够
小样本、提示协议表述不一致及批量依赖限制普遍结论;一致文本不代表正确答案,也不保证跨硬件完全确定。
综合判断
值得作为可重复推理的局部工程试验,采用前应分别设定序列一致、任务质量、延迟和显存门槛。
我会先做的验证
未执行的验证方案:固定模型文件、提示模板、算子和硬件,预注册阈值后在独立样本上比较原推理、top-2 重算和全输出头重算,按 batch=1/4/8 分层报告 EAR、结果正确率、置信区间与峰值显存。